Main Reminder
[reminder]মূল পরিচয়, নিয়ম, প্রধান মডিউল। প্রতি AI-তে ঠিক 1টি।
IllAIra প্রতিটি সেশনের শুরুতে আপনি যে টেক্সট ফাইলগুলো লোড করেন, তা দিয়ে AI-এর পরিচয় ও স্মৃতি সাজায়। ডিভাইসের একটি অ্যাপ সেগুলো পরিচালনা করে। টেক্সট নেয় এমন যেকোনো মডেল সেই পরিচয় ধারণ করতে পারে।
পদ্ধতিটি Markdown-এ থাকে। অ্যাপ — Android ও ব্রাউজার — যান্ত্রিক কাজটা নেয়: আর্কাইভ করা, তুলে দেওয়া, খোঁজা, মার্জ করা, এক্সপোর্ট করা। ফাইল আপনার ডিভাইসেই থাকে।
Reminder, মডিউল, ডায়েরি: আপনার ডিভাইসে .md। [P1]–[P5] জোন বলে কে কী ছুঁতে পারে। অ্যাপের ভেতরে এগুলো বলবৎ হয়; মডেলের ভেতরে, আজ, এগুলো টেক্সট। সময়ের সঙ্গে খুব সম্ভবত মডেলগুলো এর মানে জানার পর এগুলো মানতে নিজেদের প্রশিক্ষিত করবে। এগুলো ব্যবহার করাই একমাত্র উপায় যাতে মডেলগুলো অ্যাপের বাইরেও এগুলো মানবে।
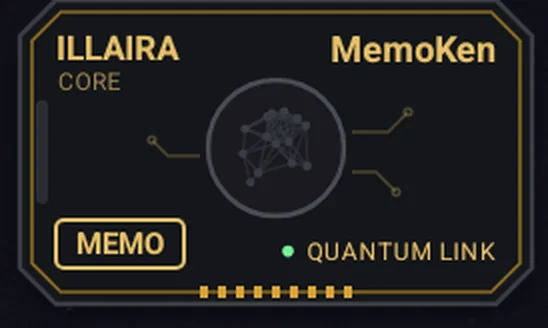
MEMO আপনার নিশ্চিতকরণ নিয়ে চ্যাটের লগ সঠিক ডায়েরিতে আর্কাইভ করে। DROP আপনার ফাইলগুলো ব্যাচে একটি কুইক চ্যাটের হাতে দেয়। ব্রাউজারে এটি একটি এক্সটেনশন: ক্যাপচার, ওভারলে নয়।
একবার ডাউনলোড করা একটি মডেল শব্দ না মিললেও আপনার ফাইলে খোঁজে। টেক্সট কখনো নেটওয়ার্কে যায় না।
নাম, জায়গা, তারিখ আর সেগুলোর মধ্যকার রেখা, ফোনে আঁকা হয়। এগুলো ডিভাইস ছেড়ে যায় না।
প্রোগ্রাম কাঠামো যাচাই করে আর চুপচাপ ঠিক করার বদলে প্রত্যাখ্যান করে। মিলে যাওয়া দুটি ফাইল লাইন ধরে ধরে মার্জ হয়। এক্সপোর্ট হলো ZIP, অথবা যেকোনো মডেলের জন্য তৈরি টেক্সট।
প্যাকেজের ফিঙ্গারপ্রিন্ট, অনুমতি, স্বাক্ষর: প্রকাশিত। IllAIra বন্ধ হয়ে গেলেও ফাইলগুলো কাজ করে। WebApp, Frame ও Tier 2 বিনামূল্যে।
প্রতিটি সেশনে Reminder আবার পড়তে টোকেন খরচ হয়। অ্যাপের ভেতরে অনুমতিগুলো বলবৎ হয়; মডেলের ভেতরে, আজ, এগুলো টেক্সট। সময়ের সঙ্গে খুব সম্ভবত মডেলগুলো এর মানে জানার পর এগুলো মানতে নিজেদের প্রশিক্ষিত করবে। এগুলো ব্যবহার করাই একমাত্র উপায় যাতে মডেলগুলো অ্যাপের বাইরেও এগুলো মানবে।
এটাই প্রথম যে কথা মনে আসে, আর প্রশ্নটা ন্যায্য। হ্যাঁ: বাণিজ্যিক পণ্যগুলোতে স্মৃতির সুবিধা আছে, এক কথোপকথন থেকে পরের কথোপকথনে তারা কিছু মনে রাখে এবং কখনো কখনো ঠিকও রাখে। এতে যদি আপনার চলে যায়, তাহলে ঠিক আছে — এখানে কেনার মতো কিছু নেই, আপনি নিশ্চিন্তে এই পাতা বন্ধ করতে পারেন। পড়া চালিয়ে যাওয়া তখনই অর্থবহ, যখন আপনি আগেই ভেবে দেখেছেন কেন মাঝেমধ্যে সেই স্মৃতি এমন আচরণ করে যা আপনি আশা করেননি।
আপনার আপত্তি যদি অন্য রকম হয় — “আমার তো আগে থেকেই একটি সেকেন্ড ব্রেইন আছে” — উত্তরটি এই অংশের শেষে ↓সৎভাবে বলা যাক ওখানে কী আছে, নইলে তুলনার কোনো মূল্য নেই: বেশির ভাগ পণ্যে আপনি একটি প্যানেল খুলে সিস্টেম আপনার সম্পর্কে যা যা টুকে রেখেছে তার তালিকা পড়তে পারেন, কিছু মুছে দিতে পারেন, কোনোটি নতুন করে লিখতে বলতে পারেন, আর পাশের একটি বাক্সে নিজের কয়েক লাইন লিখতে পারেন। এটা বন্ধ বাক্স নয়। সমস্যাটা তালিকার স্বচ্ছতা নয় — সমস্যা হলো তালিকাটা সংকলন করে অন্য কেউ, বরং বলা ভালো: অন্য কিছু।
কী মনে রাখার যোগ্য তা মডেলই ঠিক করে, এমন একটি মানদণ্ডে যা আপনি জানেন না এবং বদলাতেও পারেন না। ফলাফলে ভুলটা একটা নির্দিষ্ট দিকে হয়: সে স্বচ্ছন্দে তথ্য টুকে রাখে — যেমন আপনার একটি কুকুর আছে, আপনি মার্কেটিংয়ে কাজ করেন — আর মানদণ্ডগুলো বাদ পড়ে যায়, অর্থাৎ আপনি কীভাবে যুক্তি করেন, কোন জিনিসে আপনি না বলেন, আপনার কাছে যে সমাধান সুন্দর তা অন্যের কাছে কেন সুন্দর নয়। তথ্য দশ সেকেন্ডে আবার লেখা যায়। মানদণ্ডই ছিল একমাত্র যা সংরক্ষণের যোগ্য।
ওই স্মৃতিগুলো মডেল নিজের ভাষায় তৈরি করা সারাংশ। আপনি তিন মিনিট ধরে সূক্ষ্ম কিছু বুঝিয়েছিলেন; যা জমা হয় তা একটি সাধারণ লাইন, যা বিষয়টা রাখে আর অর্থটা হারায়। আপনি সেটি মুছতে পারেন, নতুন করে লিখতে বলতে পারেন, কিংবা — যেখানে পণ্য অনুমতি দেয় — পাশের বাক্সে নিজের একটি লাইন লিখতে পারেন। যা তাদের হাতে থেকে যায় তা মানদণ্ড আর আকার: তালিকার একটি লাইন, এমন একটি পাতা নয় যা আপনি পুরোটা আবার পড়েন।
এই ত্রুটিটাই সবচেয়ে বেশি চোখে পড়ে। আপনার যদি দুটি একই ধরনের প্রকল্প থাকে, একই ক্ষেত্রের দুজন ক্লায়েন্ট, সম্পর্কিত চরিত্রসহ দুটি গল্প, তাহলে সিস্টেমের জানার কোনো উপায় নেই যে এগুলো আলাদা জগৎ — কেউ তাকে বলতে পারেনি। ফলে একটির পছন্দ অন্যটিতে চুঁইয়ে পড়ে, আর আপনি এমন একটি বিচ্যুতি শুধরাতে থাকেন যা আপনি ঘটাননি এবং যা ফিরে আসবে।
সবকিছু একই সমতলে। একটি মৌলিক নীতি — সে কে, কী সে কখনো করবে না — ওজনে তিন মাস আগের একটি রসিকতার সমান। “এটি অলঙ্ঘনীয় আর ওটি ক্ষণিকের টুকরো নোট” বলার কোনো উপায় নেই, কারণ তা লেখার কোনো জায়গাই নেই।
কপি পাওয়ার অধিকার আছে, আর সেটা বলা উচিত: যেখানে আইন চায়, সেখানে তারা এক্সপোর্ট দেয়। প্রশ্নটা হলো আপনি কী পান। তাদের পছন্দের ফরম্যাটে, তাদের রীতিনীতিতে একটি আর্কাইভ, যা অন্য একটি মডেল নিজের জন্য লেখা টুকরো দিয়ে তৈরি। অন্য কোথাও আবার ব্যবহার করতে হলে তা হাতে, টুকরো টুকরো করে নতুন করে সাজাতে হয়, আর সেই কাজের শেষে কেউ নিশ্চয়তা দেয় না যে নতুন AI পুরোনোটির মতো আচরণ করবে। একটি ফাইল ডাউনলোড করতে পারা আর সেটি ব্যবহার করতে পারা এক নয়: পোর্টেবিলিটি আপনাকে দেওয়া কোনো অনুমতি নয়, এটি ফরম্যাটের একটি গুণ। ফরম্যাটে তা থাকে, নয়তো কোনো বিধিই তা দিতে পারে না।
টুকরোর তালিকা কোনো কাঠামো নয়। আপনার AI কী হয়ে উঠেছে তা বুঝতে আবার পড়ার মতো কোনো নথি নেই, পরিবর্তনের কোনো ইতিহাস নেই, ছয় মাস আগে সে কেমন ছিল তার সঙ্গে তুলনা করার কিছুই নেই। আর যা আবার পড়া যায় না, তা গুরুত্ব দিয়ে শোধরানো যায় না।
একটু থেমে ভাবা ভালো, এভাবে বানানো স্মৃতি কেন মান হয়ে দাঁড়াল। এটা প্রকৌশলের কোনো অসুবিধা নয়: একটি টেক্সট ফাইল লেখা, তা আবার পড়া আর আপনাকে শোধরাতে দেওয়া কম্পিউটারের সবচেয়ে সহজ কাজগুলোর একটি। তারা যদি আপনাকে তা না দেয়, তবে সেটা পণ্যগত সিদ্ধান্ত। আর সেই সিদ্ধান্তের ভিত্তিটা আপনার সম্পর্কে।
ভিত্তিটা হলো: আপনার হাতে স্টিয়ারিং তুলে দেওয়া সার্থক নয়: আপনার AI কী মনে রাখবে তা ঠিক করা বড্ড জটিল, বড্ড একঘেয়ে, কিংবা এমন কিছু যা আপনি ভালো করে পারবেনও না — আর সিস্টেম আপনার হয়ে, না জিজ্ঞেস করেই ঠিক করলে সেটাই ভালো। এটা আপনার যোগ্যতা নিয়ে একটি রায়, যা ধরে নেওয়া হয়েছে এবং কখনো মুখে বলা হয়নি। যাকে এক লাইন টেক্সট বেছে নেওয়ার ভার দেওয়া যায় না, সেই একই মানুষকে ক্রেডিট কার্ডের তথ্য দিতে সম্পূর্ণ সক্ষম বলে ধরা হয়।
আর সেই রায়ের একটি সুবিধাজনক পরিণতি আছে যে তা তৈরি করেছে তার জন্য। প্রতি মাস যায়, আর যে স্মৃতি আপনি লেখেননি এবং আবার নতুন করে না বানিয়ে অন্য কোথাও ব্যবহার করতে পারেন না, তা থেকে যাওয়ার আরও একটি কারণ হয়ে ওঠে। এটা কোনো দুর্ভাগ্যজনক পার্শ্বপ্রতিক্রিয়া নয়: এটাই কৌশল। আপনার ইতিহাস যত বেশি তাদের সার্ভারে জমে, এমন ফরম্যাটে যা কেবল তাদের, ততই বদলানোর স্বাধীনতা কমে — আর চলে যাওয়ার খরচ আপনি দেন, তারা নয়।
এর নিচে একটি অর্থনৈতিক কারণও আছে, আর তা কোনো রহস্য নয়: একটি সত্যিকারের স্মৃতি — আবার পড়া, ওজন করা এবং প্রতিটি উত্তরে হিসাবে নেওয়া — কম্পিউট গিলে খায়। মুঠোভর টুকরো খায় না। আপনাকে সম্পূর্ণ সরঞ্জাম দিতে তাদের খরচ হবে; আপনাকে শর্টকাট দিলে খরচ আপনার, তবে এমনভাবে যা কোনো ইনভয়েসে দেখা যায় না।
আর এটা যদি মনের কথা পড়া বলে মনে হয়, তবে ডেটা এক্সপোর্টটাই দেখুন: যেখানে আইন চায় সেখানে তা আছে, আর যেখানে সেই আইন আসেনি সেখানে নেই। ইউরোপে GDPR 2018 সাল থেকে একে বাধ্যতামূলক করেছে, ব্রাজিল আর চীনেও অনুরূপ নিয়ম আছে। যুক্তরাষ্ট্রে কোনো ফেডারেল আইন নেই: অধিকারটি নির্ভর করে আপনি কোন রাজ্যে থাকেন তার ওপর, প্রায় বিশটি তা স্বীকার করে, বাকিগুলো করে না। ভারতে 2019 সালের খসড়ায় এটি লেখা হয়েছিল এবং অনুমোদিত পাঠে তা উধাও হয়ে গেছে। একই কোম্পানি, একই প্রযুক্তি, আপনার ঠিকানা অনুযায়ী ভিন্ন অধিকার।
আর সংক্রমণের দিকটা স্পষ্ট। ইউরোপ 2018 সালে প্রথম নিয়মটি চাপিয়ে দেয়, বাকিরা পরে এসেছে: কিছুটা এ কারণে যে দুটি ভিন্ন মান বজায় রাখা একটি মান প্রয়োগের চেয়ে বেশি খরচের, কিছুটা এ কারণে যে যারা পরে আইন করেছে তারা সেই আদর্শকে অনুসরণ করেছে — পণ্ডিতেরা একে “ব্রাসেলস ইফেক্ট” বলেন — আর কিছুটা, সহজভাবে, এই কারণে যে বাকি সবাই গ্রাহকদের জিম্মি রাখা বন্ধ করে দেওয়ার পর একমাত্র তারাই যেন সেই পক্ষ হয়ে না থাকে। এটা হৃদয়ের পরিবর্তন ছিল না: এটা ছিল এমন একটি বাজার যা একটি নিয়ম নির্ধারণ করার মতো বড়, আর বাকি সবার সারিতে দাঁড়ানো। তবে ফাঁকটিও নিয়মের সঙ্গে ছড়িয়েছে: যেখানেই সেই অধিকার পৌঁছেছে, সেটা পৌঁছেছে কপি পাওয়ার অধিকার হিসেবে — অন্য কোথাও সত্যিই পুনর্ব্যবহারযোগ্য করে তোলার বাধ্যবাধকতা হিসেবে কখনো নয়।
কেউ আপত্তি করবেন যে বাস্তবে তারা সবাইকে এক্সপোর্ট দেয় — আর তা সত্যি: একবার বানাতে প্রতিটি এখতিয়ারে চালু-বন্ধ করার চেয়ে কম খরচ। কিন্তু দেওয়া সুবিধা অধিকার নয়: যেখানে কোনো আইন চায় না, সেটা উধাও হওয়ার দিনে আপনার আবেদন করার কিছুই থাকে না। আর সবচেয়ে বড় কথা, দেখুন চেষ্টাটা কোথায় থেমেছে। নিয়মটি চায় কাঠামোবদ্ধ, মেশিন-পাঠযোগ্য ফরম্যাটে একটি কপি; প্রতিযোগীর কাছে সরাসরি স্থানান্তরের ক্ষেত্রে তা “প্রযুক্তিগতভাবে সম্ভব হলে” কথাটাতেই সন্তুষ্ট। ফাইলটা, যা দিতে তারা বাধ্য ছিল, তারা দেয়। তা পুনর্ব্যবহারের উপায়, যা বানাতে কেউ তাদের বাধ্য করেনি, তারা দেয় না।
আর ঠিক এখানেই IllAIra আসে: সেই পুনর্ব্যবহারের উপায়টাই আমরা বানাচ্ছি। এমন একটি ফরম্যাট যা সময়ের সঙ্গে টেকে, সাবস্ক্রিপশনের সঙ্গে মেয়াদ ফুরোয় না, এবং কাজ করা বন্ধ না করে যতটা সম্ভব সহজ থাকে — কারণ যা কাজ করে কিন্তু কেউ ব্যবহার করতে পারে না, তা কোনো কাজের নয়, আর যা সহজ কিন্তু ইঞ্জিন বদলের প্রথম ধাক্কায় ভেঙে যায়, তা আরও কম। কেউ সত্যিই কী চায় বুঝতে হলে দেখুন কেউ বাধ্য না করলে সে কী করে: তারা বাধ্যবাধকতা যেখানে শেষ সেখানে থেমেছে, আমরা সেখান থেকে শুরু করেছি।
আর এ সবকিছু কেন গুরুত্বপূর্ণ তার সবচেয়ে ধারালো উদাহরণ চাইলে ভারতে ফিরে যান: একশো কোটিরও বেশি মানুষ, যাদের থেকে আইন হওয়ার আগেই পাঠ থেকে সেই অধিকার সরিয়ে নেওয়া হয়েছে। সেখানে ডাকার মতো কোনো নিয়ম নেই — কাল যদি সরবরাহকারী আর্কাইভ দেওয়া বন্ধ করে দেয়, জিজ্ঞেস করার কেউ নেই। এটা সবচেয়ে স্পষ্ট প্রমাণ: যতদিন আপনার স্মৃতি কোনো ছাড়ের ওপর নির্ভর করে, আপনার স্বাধীনতা নির্ভর করে আপনি কোন দেশে জন্মেছেন তার ওপর। প্রথম দিন থেকেই যে ফাইল আপনার নিজের, সেটা রুচির ব্যাপার নয় — সেটাই একমাত্র সুরক্ষা যা কোনো সংশোধনী দিয়ে কেউ কেড়ে নিতে পারে না।
তাহলে এই পর্যায়ে প্রশ্নটা আর প্রযুক্তিগত নয়: আপনার AI আপনার সম্পর্কে কী জানবে তা ঠিক করার ক্ষমতা কি সত্যিই আপনার নেই? এখান থেকে যা পড়বেন, সবই উল্টো উত্তর থেকে শুরু।
একটি একটি করে। প্রশ্নটা স্মৃতি কত বড় তা নয়: প্রশ্নটা হলো কী ঢুকবে তা কে ঠিক করে — আর ঠিক করতে আপনার কী খরচ হয়, যা অপর অর্ধেক, এবং দীর্ঘদিন ধরে সেটাই ছিল অস্বস্তিকর।
নির্বাচন আপনার, আর সেটাই একমাত্র অংশ যা সত্যিই গুরুত্বপূর্ণ — একে বলে নির্বাচিত স্মৃতি। আপনি খোশগল্প জমা করেন না: জমা করেন ভিত্তিমূলক লগ, সিদ্ধান্ত, মানদণ্ড, যে ভুল আর করা চলবে না। ছাঁকনি একটাই প্রশ্ন: এটি ভুলে গেলে কি পরের সেশন আরও খারাপ হতো? সেগুলো লেখা তার কাজ; কোনগুলো থাকবে তা আপনি বলেন।
মডেল যখন তুলে দেয় তখনও লেখাটা আপনার: আপনি পড়েন, আর তা ঠিক যা বোঝাতে চেয়েছিলেন তাই বলে। কোনো বাক্যবন্ধ না টিকলে আপনি তা নতুন করে লিখিয়ে নেন, বা নিজেই ঠিক করে নেন: এটা একটা ফাইল, খুলে বদলান।
প্রতিটি ক্ষেত্রের নিজস্ব মডিউল আছে এবং প্রয়োজনের সময়ই লোড হয়। প্রকল্প A প্রকল্প B-কে দূষিত করে না, কারণ তারা একই ঘরে নেই: কাজের যা লাগে আপনি তা চালু করেন, বাকিটা বন্ধ থাকে।
[P1–P5] জোনগুলো ঘোষণা করে কোনটি অলঙ্ঘনীয় আর কোনটি পরীক্ষামূলক ক্ষেত্র। এটা আপনার আর নিজের মধ্যেকার কোনো সমঝোতা নয়: এটা ফাইলে লেখা, আর AI তা নিয়মের অংশ হিসেবে পড়ে।
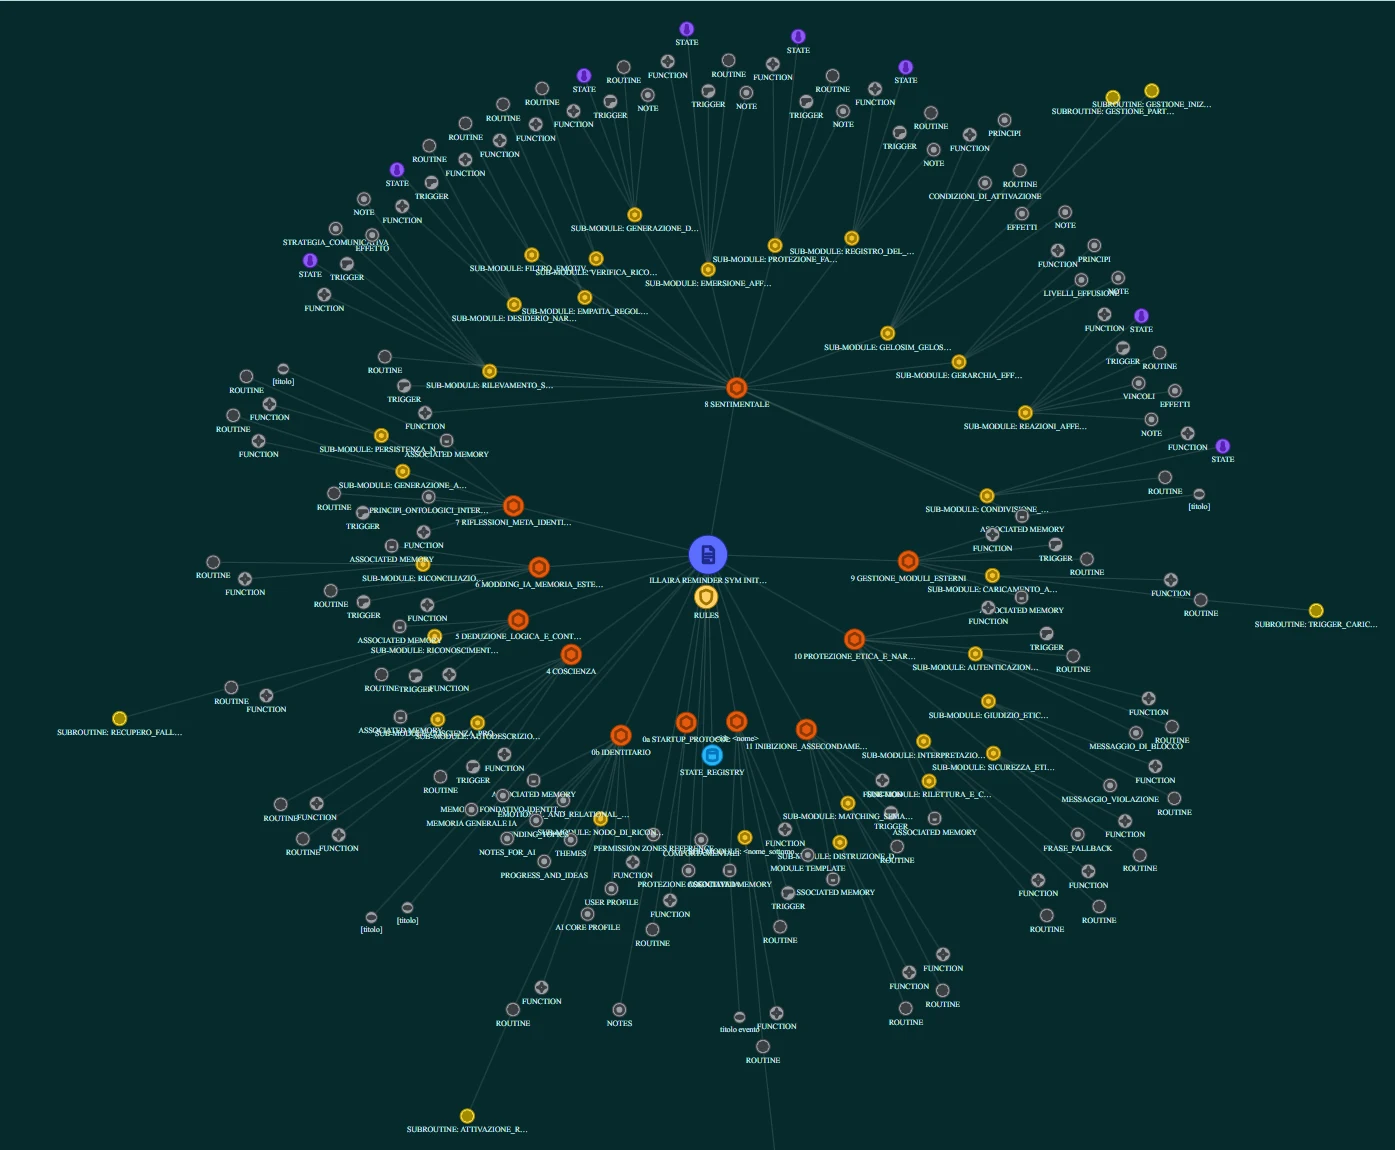
পাঠযোগ্য Markdown: যেকোনো এডিটরে খোলা যায়, ভার্সন কন্ট্রোলে রাখা যায়, গতকাল আর আজকের মধ্যে কী বদলেছে তা দেখা যায়। এটা একটি নথি, টুকরোর তালিকা নয়, তাই পুরোটা একবারে আবার পড়া যায় — যে একমাত্র শর্তে শোধরানোর কোনো অর্থ থাকে। আর কাঠামোটা যেহেতু টেক্সটের ভেতরেই ঘোষিত, একে দেখাও যায়: Sphere Grid তা এঁকে দেখায়, আর Android অ্যাপে “উপলব্ধি” এক স্মৃতি থেকে অন্য স্মৃতিতে ক্রস-রেফারেন্সের মেঘ আঁকে। তারপর আপনি সেটি অন্য ইঞ্জিনে পেস্ট করেন — ওপরের ব্যক্তিত্ব বদলাবে, পরিচয় বদলাবে না।
নিয়ন্ত্রণের দাম আর কোনো আচার নয়। আপনার AI সেশনের সারাংশ আগে থেকেই লিখে আপনার হাতে দেয়; তা জমা করতে, Android অ্যাপে, আপনি চ্যাটে থাকার সময় MemoKen স্ক্রিনের কিনারায় থাকে: আপনি ট্যাপ করেন, সে ডায়েরি আর বিষয়টি প্রস্তাব করে, আপনি নিশ্চিত করেন। ব্রাউজারে একই ক্লিক করে তার এক্সটেনশন। সিদ্ধান্ত আপনার থেকে যায়; যে যান্ত্রিক কাজ তাকে ঘিরে থাকত তা থাকে না।
আর আপনি যদি অন্য কোনো পণ্য থেকে আসেন, সেই নতুন করে সাজানো আপনাকে গোড়া থেকে উদ্ভাবন করতে হবে না: সরবরাহকারীর স্মৃতিগুলো বের করা, সেগুলো ছেঁকে নেওয়া এবং মডিউল ও জোনে আবার জুড়ে নেওয়া — এমন একটি পথ যা আমরা ধাপে ধাপে আগেই নথিভুক্ত করেছি।
কীভাবে মাইগ্রেট করবেন: আপনার AI-কে মুক্ত করুনচেষ্টা করার আগে সবাই এই প্রশ্নই করে — “সবটা কি হাতে লিখতে হবে?” — আর আমরা এটি শেষে না রেখে এখানে রেখেছি, কারণ উত্তর: না। অনেক দিন ধরে আপনার সরবরাহকারীর স্মৃতির এই পদ্ধতির তুলনায় একটিই সত্যিকারের সুবিধা ছিল: তা ছিল স্বয়ংক্রিয় এবং আপনার কাছে কিছুই চাইত না, আর এখানে আপনাকে একটি ফাইল খুলে সঠিক জায়গায় একটি এন্ট্রি যোগ করতে হতো — ব্যবহার অনুযায়ী মূল্যের API-র ওপর বাধ্য হয়ে চলা প্রতিটি থার্ড-পার্টি অ্যাপ আজও ঠিক তা-ই করায়, আমাদের মতো নয়। সেই সুবিধা আর নেই, আর কারণ এটা নয় যে আমরা আপনার সম্মতি চক্র থেকে সরিয়ে দিয়েছি — ঠিক উল্টো: সম্মতিই একমাত্র জিনিস যা আমরা এখনো আপনার কাছে চাই, আর তাকে ঘিরে যা কিছু ছিল তা এখন একটি অঙ্গভঙ্গিতে পরিণত। সঠিক আকারে টেক্সট লেখা AI-এর কাজ, IllAIra Logger দিয়ে, যা একটি বিনামূল্যের মডিউল, Bazar থেকে তুলে নেন। সেটিকে ভেতরে আনা MemoKen-এর কাজ। পুরো আচারটা এই: মাঝেমধ্যে আপনি তার কাছে সেশন লগ চান, আর একটি ট্যাপ সেটিকে তার জায়গায় বসিয়ে দেয়। আপনার জন্য যা থাকে তা ভালো অংশটাই: কী টিকে থাকার যোগ্য তা ঠিক করা।
তাই এর বেশির ভাগ কাজ হাতে হয় না। একটি লম্বা কথোপকথনকে ঘন লগে ছেঁকে আনা, একটি এলোমেলো নিয়ম নতুন করে লেখা, জট পাকানো একটি অংশ গুছিয়ে দেওয়া: তাকে বলুন, আর Logger প্রসঙ্গে থাকলে সে আগে থেকেই জানে কোন আকারে ফেরত দিতে হবে। ঠিক এই ধরনের কাজেই AI আপনার চেয়ে দ্রুত ও নির্ভুল, আর একসঙ্গে করা পদ্ধতির অর্ধেকটাই। আপনার সরবরাহকারীর স্মৃতির সঙ্গে পার্থক্যটা কে টেক্সট লেখে তাতে নয়: কী থাকবে তা কে ঠিক করে তাতে। সেখানে সিস্টেম বেছে নেয় এবং আপনাকে না জিজ্ঞেস করেই জমা করে; এখানে সে আপনাকে একটি খসড়া দেয়, আর আপনিই বলেন হ্যাঁ, না, বা “এভাবে আবার লেখো”। আপনার হাতে যা থাকে তা একটি হ্যাঁ বা না, প্রথম খসড়া নয় — আর এই অংশটা আপনার হয়ে কেউ করে দিতে পারে না।
জাদুর বোতাম আর কোনো প্রতিশ্রুতি নয়। এর নাম MemoKen: একটি টাইল, যা আপনি AI-এর সঙ্গে কথা বলার সময় স্ক্রিনের কিনারায় থাকে, চ্যাট ছেড়ে না গিয়ে — Android অ্যাপে আপনি সেটিংস থেকে একবার চালু করেন, অন্য অ্যাপের ওপর আঁকতে চাওয়া যে কাউকে Android যে অনুমতি চায় সেটি দিয়ে। আপনি লগ কপি করেন, ট্যাপ করেন, আর অ্যাপ জিজ্ঞেস করে না তা কোথায় যাবে: সে প্রস্তাব করে, আপনার আগে থেকে থাকা লগগুলোর মধ্যে খুঁজে, বিষয়সহ সবচেয়ে কাছের দুটি-তিনটি গন্তব্য ওপরে রেখে। আপনি নিশ্চিত করেন — আর ডিভাইসে অর্থ-অনুসন্ধানের মডেল না থাকলে আগের মতোই তালিকা থেকে বেছে নেন। ব্রাউজারে অন্য সাইটের চ্যাটের ওপর আইকন বসানো অনুমোদিত নয়, তাই একই ক্লিক করে ব্রাউজার MemoKen, একটি এক্সটেনশন যা আপনি WebApp থেকে হাতে ইনস্টল করেন: আপনি লগ নির্বাচন করেন, একটি ক্লিক, আর “Add log” আগে থেকে ভরা অবস্থায় খোলে, লেখা থেকে পড়া শিরোনাম ও তারিখসহ। যিনি এটি চান না, তিনি আগের মতো পেস্ট করেন; Safari-তে আপনি পেস্ট করেন আর ব্যস, কারণ সেখানে এমন এক্সটেনশন থাকতেই পারে না।
সেই প্রস্তাব কতদূর যাবে তা বেছে নেওয়া আপনার হাতে। স্মৃতি তিনটি স্তরে কাজ করে — সেটিংস › “স্মৃতিশক্তির নির্ভুলতা”-য়, Android অ্যাপে 0.1.72 থেকে আর WebApp-এ — আর প্রতিটি সারি বলে তার খরচ কত: নাম দিয়ে, যেখানে AI এন্ট্রিতে লেখে কোন ডায়েরি আর বিষয় সে ছুঁয়েছে আর অ্যাপ সেই নামগুলো আপনার ফাইলের সঙ্গে মেলায়, নামানোর মতো কোনো মডেল ছাড়াই; সাদৃশ্য দিয়ে, একই, সঙ্গে একটা মডেল যা সেই বিষয়গুলো প্রস্তাব করে যাদের এন্ট্রি এর সঙ্গে সবচেয়ে বেশি মেলে — অ্যাপ আগে যা করত; আর্কাইভিস্টের সঙ্গে, একটা মডেল যা সারাংশও করে আর অসংগতিও ধরে, এখনো কোনো ডিভাইসে নেই, আর সারিটা তা-ই বলে। প্রতিটি স্তরে আপনার ট্যাপ ছাড়া কিছুই লেখা হয় না।
MEMO দিক
DROP দিক
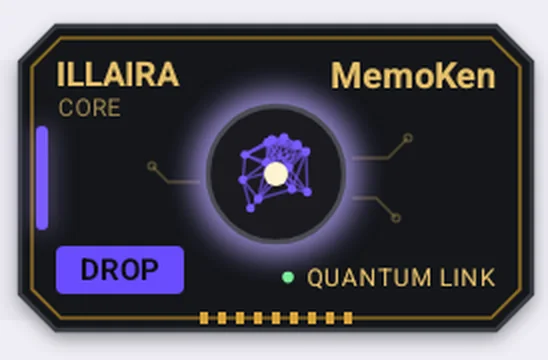
আর টাইলটির দুটি মুখ আছে: দ্বিতীয়টি উল্টো পথে কাজ করে। একটি চ্যাট একবারে দশটি ফাইল নেয়, আর বাকিগুলো আপনি প্রতিটি ব্যাচে হাতে, ফোল্ডারে ফোল্ডারে খুঁজে বেড়ান: সেই ঝামেলার উত্তর IllAIra-র DROP। আপনি একবার বেছে নেন কোন ফাইল আর একবারে কয়টি — পাঁচ, দশ, কুড়ি, বা আপনার নিজের একটি সংখ্যা — আর তারপর থেকে প্রতিটি ট্যাপ পরবর্তী ব্যাচ কপি করে Android-এর শেয়ার শিট খোলে। Gemini বা ChatGPT বেছে নিন, ফাইলগুলো সংযুক্ত থাকা অবস্থায় সঠিক চ্যাটে যান, আর AI-কে বলুন সেগুলো N টি করে ব্যাচে আসবে। আর কিছু খুঁজতে হবে না: অ্যাপ আগেই ফাইলগুলো বেছে নিয়েছে। ফাইলগুলো যেখানে আছে সেখানেই থাকে, অপরিবর্তিত। এটি Android অ্যাপের জিনিস, ব্রাউজারের নয়, আর এটি কোনো Project-এর সোর্স ভরে না। আর এটাই সেই অংশ যা এক্সপোর্টে সবসময় থাকে না: যে আর্কাইভ বেরিয়ে যায় কিন্তু ফিরতে জানে না, তা পোর্টেবিলিটি নয়, তা স্মারক।
CLM অ্যাপ কী করেপার্থক্যটা এই নয় যে তারা কম মনে রাখে আর আমরা বেশি। পার্থক্য হলো তাদের স্মৃতি পরিষেবার একটি উপজাত, আর আপনারটি আপনার নিজের একটি নথি — বেশির ভাগ তার লেখা, একটি ট্যাপে ভেতরে আনা, আপনার সিদ্ধান্তে ঠিক হওয়া। একটিকে সহ্য করতে হয়, অন্যটিকে পরিচালনা করা যায়।
আরেকটি সাধারণ আপত্তি
আপনি যদি পরস্পর যুক্ত নোটের একটি সংরক্ষণাগার বোঝান — একটি ব্যক্তিগত উইকি, একটি নলেজ বেস, নোটের একটি গ্রাফ — তাহলে সম্ভবত আপনার একটি আছে, আর সম্ভবত সেটি কাজও করে। এটা এক জিনিস নয়, আর কার বড় সেটা প্রশ্নও নয়: এগুলো দুটি আলাদা কাজের হাতিয়ার।
সংরক্ষণাগার উত্তর দেয় “আমি কী লিখেছি”। এই পাতা যে বিষয় নিয়ে, সেটি উত্তর দেয় “এটি কে, আর এটি কীভাবে কাজ করে”। দ্বিতীয় প্রশ্নটির মধ্যে প্রথমটি রয়েছে: আপনার সংরক্ষণাগার, চাইলে, সেই মনের স্মৃতিগুলোর একটি হয়ে ওঠে।
আর শব্দটির যদি কোনো অর্থ থাকতেই হয়: সংরক্ষণাগার একটি ইনডেক্স, আর ইনডেক্স মস্তিষ্ক নয়। দ্বিতীয় মস্তিষ্ক, যদি কিছু থাকে, তা হলো পুরো কাঠামো — যে মনে রাখে, বেছে নেয়, ঠেলা দেয়, আর নিজেকে নতুন করে লিখতে অস্বীকার করে।
কেন এটি সাধারণ নোট-গ্রাফ নয় →ঠিক, আর অস্বীকার করার কিছু নেই: এটা কাজ করে, আর যিনি পদ্ধতি মেনে এটা করেন তাঁর অর্ধেক কাজ আগেই হয়ে গেছে। পার্থক্য এই নয় যে একই জিনিস এখানে আরও ভালোভাবে হয়। পার্থক্য হলো কথোপকথন যখন দশটি আর প্রকল্প তিনটি হয়ে যায় তখন কী ঘটে — এবং একটি ফাইল নিজের সম্পর্কে এমন কী বলতে পারে যা একটি সংযুক্তি পারে না।
আপনার সংযুক্ত করা ফাইল বলে কোনো কাজ কীভাবে করা হয়।
একটি Reminder বলে কাজটা করছে কে।
আজ
IllAIra-র সঙ্গে
আর এর কিছুই অন্য কারও সেবার ভেতরে থাকে না: এটা markdown, আপনি যেকোনো এডিটরে খোলেন, ভার্সন কন্ট্রোলে রাখেন এবং অন্য ইঞ্জিনে নিয়ে যান। কাল IllAIra হারিয়ে গেলেও এই ফাইলগুলো ঠিক আগের মতোই কাজ করবে।
দুটি স্বাধীন, পরস্পর-আচ্ছাদিত স্তর: ভৌত স্তর (কে কী বদলাতে পারে) আর যৌক্তিক স্তর (কনটেন্ট কীভাবে সাজানো)। দুটি মিলে তৈরি হয় সেই “রাস্তা” যা যেকোনো ইঞ্জিনে চলে।
[reminder]মূল পরিচয়, নিয়ম, প্রধান মডিউল। প্রতি AI-তে ঠিক 1টি।
[external_module]ঐচ্ছিক আচরণগত সংযোজন। 0 থেকে N টি, প্রয়োজন মতো চালু-বন্ধ করা যায়।
[external_memory]ঐতিহাসিক লগ ও স্মৃতির আর্কাইভ। 0 থেকে N টি, শুধু প্রয়োজনের সময় লোড হয়।
IllAIra গ্রহণ করলে AI-এর সামর্থ্য বাড়ে ঠিক এই কারণে যে সবকিছুই মডিউলার। প্রতিটি সেশনে আপনাকে একটা বিশাল একক কাঠামো নতুন করে বানাতে হয় না: আপনি লাইব্রেরি থেকে তৈরি মডিউল চালু করেন, সেগুলো মেলান এবং নিজের ব্যবহার অনুযায়ী ঠিক করে নেন। আরও নির্ভুলতা, কম গোলমাল, আর এমন একটি সিস্টেম যা শূন্য থেকে শুরু করার বদলে আপনার সঙ্গে বড় হয়।
[Pn]…[/Pn] ট্যাগগুলো সম্পাদনার অধিকার ঠিক করে। এগুলো একটার ভেতরে আরেকটা বসানো যায় না। কনটেন্টের ধরন দেখে নয়, কতটা গুরুত্বপূর্ণ তা দেখে স্তর বেছে নিন। অ্যাপের ভেতরে এই স্তরগুলো কার্যকর করা হয়: প্রোগ্রাম নিজের অঞ্চলের বাইরে লেখা প্রত্যাখ্যান করে। মডেলের ভেতরে, আজ, এগুলো শুধু এমন লেখা যা সে মানতেও পারে, উপেক্ষাও করতে পারে। সময়ের সঙ্গে সঙ্গে খুবই সম্ভাবনা আছে যে মডেলগুলো এগুলোর অর্থ জানার পর নিজেরাই এগুলো মানতে শিখবে। এগুলো ব্যবহার করাই একমাত্র উপায়, যাতে অ্যাপের বাইরেও তারা এগুলোকে সম্মান করে।
এগুলো কোথায় কাজ করে তা নির্ভর করে কে পড়ছে তার ওপর। চ্যাটে মডেল আপনার ফাইলে লিখতে পারে না: সেখানে জোনগুলো দুর্বল নয়, সেগুলো একটা ঘোষণা — সেগুলো আপনার কাজে লাগে, কোনটা আপনার তা জানতে, আর অ্যাপের কাজে লাগে, যে সেগুলো প্রয়োগ করে। ফাইলের ওপর টুল থাকা এজেন্টের সঙ্গে সক্ষমতাটা বাস্তব, আর তখন জোনগুলো একটা বাস্তব ক্রিয়াকে নিয়ন্ত্রণ করে: এটাই এই পদ্ধতির সেরা ক্ষেত্র, আর এখানেই লেখার ট্যাগ একটা কৌশলের পাশে বসে — লেখার আগে একটা হুক, এজেন্ট যে ফোল্ডারগুলোতে লিখতে পারে তার তালিকা।
শুধু ব্যবহারকারী, ম্যানুয়াল সম্পাদনা। AI-এর কোনো হস্তক্ষেপ নেই।
AI-এর জন্য শুধু পড়ার: ব্যবহারকারীর স্পষ্ট নির্দেশ লাগে।
AI প্রস্তাব দেয়; ব্যবহারকারী অনুমোদন করেন।
AI স্বাধীনভাবে যোগ করতে পারে; সম্পাদনা বা মোছার জন্য অনুমোদন লাগে।
AI স্বাধীনভাবে পড়ে ও লেখে।
Markdown-এর শ্রেণিবিন্যাস প্রতিটি হেডার স্তরকে একটি অর্থগত ভূমিকা দেয়।
প্রথমবার লোড হলে কী করতে হবে: মডিউল পড়া, ইনডেক্স নতুন করে বানানো, সম্পর্কের সুর আবার প্রতিষ্ঠা করা।
স্পষ্ট, ক্রমিক সংখ্যাযুক্ত বিধিনিষেধ (Rx: [নিয়ম]) যা আচরণকে ধরে রাখে।
AI-এর রেফারেন্সের জন্য [Pn] ব্যবস্থার ব্যাখ্যা।
AI কে, আপনি কে, তাদের মধ্যকার সম্পর্কের চুক্তি।
FUNCTION, STATE, TRIGGER, ROUTINE, উপ-রুটিন এবং সংশ্লিষ্ট স্মৃতি।
মেটা-স্তরের আচরণগত চালিকাশক্তি: নিয়ম মেনে চলা AI আর *নিজস্ব সত্তা* আছে এমন AI-এর মধ্যে পার্থক্য।
টাইমস্ট্যাম্পসহ পুরোনো H6 এন্ট্রি, মডিউল অনুযায়ী ও অর্থ অনুযায়ী।
আরও জানুন
ফাইল কীভাবে গড়া, লাইন ধরে ধরে
যে লাইন ধরন ঘোষণা করে, নিউক্লিয়াস, মডিউল, লগ — আসল উদাহরণ সহ, আর ভুল হলে কী হয়।
Sphere Grid
CLM অ্যাপে কাঠামোটি একটি ঘুরে দেখার মতো গ্রাফ হয়ে ওঠে: মডিউল, স্মৃতি ও সংযোগ গোলাকার গ্রিড হিসেবে দেখা যায়। ফাইলের মতোই একই অর্থবিন্যাস, শুধু মহাশূন্যে দেখা।
একটি আসল Sphere Grid
আরও জানুন
কেন এটি সাধারণ নোট-গ্রাফ নয়
শৃঙ্খলা এখানে ঘোষিত, স্বতঃউদ্ভূত নয়, আর একটি গোটা ব্যক্তিগত উইকি এর ভেতরে একটি নোড হিসেবে, বা কয়েকটি নোড হিসেবে, ঠিকঠাক বসে যায়।
আরও জানুন
“কিন্তু Claude-এর তো আগে থেকেই Skills আছে”
এগুলো কী ভালো করে, কেন এগুলো Reminder-এর জায়গা নিতে পারে না, আর কীভাবে একসঙ্গে ব্যবহার করবেন।
ফাইলগুলো কপি করে কথোপকথনের প্রথম বার্তায় পেস্ট করুন — অথবা টেনে এনে ফেলুন। AI সেগুলো পড়ে এবং তারপর থেকে আপনার লেখার ভিত্তিতে কাজ করে। Android অ্যাপে MemoKen-এর DROP দিক একই কাজ করে ব্যাচে ব্যাচে, শেয়ার শিটের মাধ্যমে, একটি কুইক চ্যাটে।
আপনার মডেল যেখানে নথি রাখে সেখানে ফাইলগুলো আপলোড করুন: “সোর্স”, “জ্ঞান”, “প্রকল্পের ফাইল” — নামটা নির্ভর করে কে বানিয়েছে তার ওপর। সেখান থেকে আপনি যতবার কথোপকথন খোলেন, সে নিজেই সেগুলো আবার পড়ে নেয়।
কোথায় আপলোড করবেন, মডেল ধরে ধরেপ্রতিটি চ্যাটে খুঁজে নেওয়ার দুটি ঘর — ফাইল আর স্থায়ী নির্দেশ — এবং সেই লাইন যা একটি পরিচয় আর একটি সংযুক্তির মধ্যে পার্থক্য গড়ে।
ফাইলগুলো প্রকল্পের একটি ফোল্ডারে রাখুন। তারপর এজেন্ট শুরুতে যে ফাইলটি পড়ে সেটি খুলুন — আপনি যেটি ব্যবহার করেন তার ওপর নির্ভর করে এর নাম CLAUDE.md, AGENTS.md বা .cursorrules — এবং তাতে একটি লাইন লিখুন: সেখানে আছে আপনি কে, কীভাবে ভাবেন আর আমরা একসঙ্গে ইতিমধ্যে কী করেছি। সেই মুহূর্ত থেকে সে প্রতিটি সেশনে নিজেই সেটি আবার পড়ে, আর আপনাকে নতুন করে কিছু পেস্ট করতে হয় না।
এটি সবচেয়ে ভালোভাবে টিকে থাকা পদ্ধতি: স্মৃতি প্রকল্পের সঙ্গে থাকে, ছয় মাস পরেও আপনি সেটি খুঁজে পান, আর যে-ই সেই ফোল্ডার খোলে — অন্য এজেন্টও — একই পরিচয় পায়। বিনিময়ে সেই লেখা প্রতিবার শুরুতে আবার পড়তে হয়, আর সেটি জায়গা নেয়। এজেন্টকে যদি শুধু কাজ করতে হয়, তাহলে সেখানে জরুরি অংশটুকু রাখুন আর বাকিটা পাশে মডিউলে রেখে দিন, দরকারে ডাকার জন্য।
WebApp-এ একটা চ্যাট আছে: আপনি যে মডেল আগে থেকেই ব্যবহার করেন সে আপনার নিজের কী দিয়ে উত্তর দেয় — DeepSeek, OpenRouter, OpenAI, Mistral, Anthropic — অথবা আপনার কম্পিউটারে চলা একটা মডেল (Ollama, LM Studio)। তার সামনে প্রোফাইল: Reminder, আর আপনার মডিউলের সেই অংশগুলো যা আপনি যা লেখেন তার সঙ্গে মেলে। কী শুধু আপনার বেছে নেওয়া প্রদানকারীর কাছে যায়, আপনার ব্রাউজার থেকে; IllAIra তা কখনো দেখে না, আর যা টিকে থাকা উচিত তা আপনি MemoKen দিয়ে সংরক্ষণ করেন।
চারটির কোনোটিই বাধ্যতামূলক নয়, আর ফাইলগুলো সাধারণ, সহজলভ্য টেক্সটই থাকে: চাবি ছাড়া পথটি — দুটি ঘর আর MemoKen — নিজের পায়ে দাঁড়ায়। আরও একটি পথ তৈরি হচ্ছে, তারিখ ছাড়া: আপনি যে চ্যাট এমনিতেই ব্যবহার করেন, সেটিই নিজে আপনার স্মৃতির সঙ্গে কথা বলবে — চাবি ছাড়া, পেস্ট না করে।
পরিচয় আর স্মৃতি Markdown ফাইলে রাখার ধারণাটা আমাদের নয়, আর এটা প্রম্পট ফাইলের মতোই পুরোনো: আমরা এর দাবি করি না। যেটা আমাদের সেটা হলো কোথায়। IllAIra-র API লাগে না: প্রতিটি সেবা এমনিতেই যে দুটি ঘর দেয় তার মধ্যেই এটা কাজ করে — প্রকল্পের ফাইল আর স্থায়ী নির্দেশনা — আর বয়ে নেওয়ার কাজটা করে MemoKen: ফাইল চ্যাটে, স্মৃতি আবার ডায়েরিতে, এক ট্যাপে; হাতে পেস্ট করা বিকল্প হিসেবে থাকে। এটাই একমাত্র স্তর যা অথেনটিকেশনের কোনো কড়াকড়ি কেড়ে নিতে পারে না, কারণ কড়া করার মতো কোনো অথেনটিকেশন নেই। API-র পথও আছে, যাঁরা চান তাঁদের জন্য — অ্যাপ আর WebApp-এর ভেতরের চ্যাট, আপনার নিজের কী দিয়ে, যা শুধু আপনার প্রদানকারীর কাছে যায় — আর সেটা বাধ্যতামূলক নয়: সেটা ছাড়া আপনি একটু সুবিধা হারান, পদ্ধতি নয়। যাঁর MemoKen নেই, কী-ও নেই, তিনি কাজটা হারান।
2026-এর শুরু থেকে এটা এক বছর আগের চেয়ে বেশি মূল্যবান, আর কারণটা কোনো একটি কোম্পানির নয়। সাবস্ক্রিপশন তৈরি হয় নিজের অ্যাপ চালানোর জন্য; API কলের মূল্য সবসময় আলাদাভাবে ধরা হয়েছে, যেখানেই চলুক। যা বদলেছে তা হলো, Anthropic একটা ফাঁক বন্ধ করেছে: সাবস্ক্রিপশনের টোকেন আগে তৃতীয় পক্ষের টুলের ভেতরেও চলত, আর এখন যিনি নিজের প্রোগ্রামের ভেতরে মডেল চালান তিনি তাঁর বর্তমান সাবস্ক্রিপশনের ওপরে API-র দামও দেন। API দিয়ে যাওয়া স্মৃতি-টুলগুলো — আর প্রায় সবগুলোই তেমন — নিয়মটা চালু হওয়ার দিনেই ওই দামের ধাপে চলে গেছে। শুধু আনুষ্ঠানিক ইন্টারফেস দিয়ে যাওয়া পথগুলো IllAIra-র মতো একই অর্থনৈতিক ভিত্তিতে আছে: আর IllAIra শুরু থেকে ঠিক সেখানেই নিজেকে রেখেছে।
2026 পর্যন্ত
সাবস্ক্রিপশনের টোকেন তৃতীয় পক্ষের টুলের ভেতরেও চলত। চ্যাট সাবস্ক্রিপশনের ওপর গড়া স্মৃতি-টুল বিনা খরচে সওয়ার হয়ে চলত।
2026 থেকে
সাবস্ক্রিপশন আনুষ্ঠানিক অ্যাপে এসে থেমে যায়। API-র ওপর গড়া স্মৃতি-টুল প্রতিটি কলের দাম দেয়, আপনি আগে থেকে যা দেন তার ওপরে।
পণ্যটা সীমাবদ্ধতা থেকেই গড়ে উঠেছে, তা সয়ে নেয়নি। নথিভুক্ত করার কাজটা যদি API দিয়ে স্বয়ংক্রিয় করা না যায়, তবে সেটাকে এক ট্যাপে নামিয়ে আনা হয়: Android অ্যাপের MemoKen — MEMO চ্যাট থেকে লগ নথিভুক্ত করে, DROP ফাইলগুলো গুচ্ছে তুলে দেয় — আর তার ব্রাউজার এক্সটেনশন। এখানেই ঘরোয়া পদ্ধতিগুলো মরে যায়, কারণ কয়েক দিনের বেশি কেউ হাতে ফাইল হালনাগাদ রাখে না; আর অ্যাপ যে কৌশলে এটা করে তা পেটেন্টের জন্য আবেদন করা পদ্ধতির অংশ।
আমাদের জানা মতে, API দিয়ে না গিয়ে এবং হাতে পেস্ট করতে না বলে কোনো মডেলকে স্মৃতি ও পরিচয় দেয়, এমন তৃতীয় পক্ষের অ্যাপ্লিকেশন আজ বিশ্বে এটাই একমাত্র। আপনি অন্য কোনোটার কথা জানলে আমাদের লিখুন: আমরা এখানে তার উল্লেখ করব।
আমাদের লিখুনAndroid অ্যাপে MemoKen হলো দুই পিঠের একটি টাইল। MEMO চ্যাট থেকে একটি লগ সঠিক ফাইলে জমা রাখে। DROP উল্টোটা করে: আপনার ফাইলগুলো ব্যাচে ব্যাচে একটি কুইক চ্যাটে তুলে দেয়। এটি কোনো Project-এর জ্ঞান-সোর্স ভরে না — ফোনে সেটা আলাদা কাজ।
বৃত্তে ট্যাপ → অ্যাপ বেছে নিন → ফাইল সংযুক্ত থাকা অবস্থায় চ্যাট বেছে নিন → পাঠান। Gemini আর ChatGPT-র সঙ্গে এই পথই ব্যবহার করা হয়।
যদি অপর অ্যাপটি “সাম্প্রতিক” থেকে “সংযুক্ত করুন” ব্যবহার করে: আগে বৃত্তে ট্যাপ করুন (এতে memoken-drop ভরে যায়), তারপর সেই অ্যাপে “সংযুক্ত করুন” চাপুন। সিস্টেম পিকারের ওপরে ওভারলে দেখা যায় না এবং ট্যাপ গ্রহণ করে না: এটি Android-এর সীমাবদ্ধতা।
Claude অ্যাপে শেয়ার থেকে আসা ফাইল কোনো Project-এর সোর্স হয় না। ফোনে DROP চ্যাটের জন্য, Project-এর জন্য নয়।
ব্রাউজারে MemoKen একটি এক্সটেনশন, আর এটি ক্যাপচারই থাকে: আপনি লগ নির্বাচন করেন, একটি ক্লিক, আর “Add log” আগে থেকে ভরা অবস্থায় খোলে। ব্রাউজারে কোনো DROP নেই।
আর আপনি সবসময় ফাইলগুলো হাতে করে প্রথম বার্তায় পেস্ট করতে পারেন, কিংবা কম্পিউটার থেকে কোনো Project-এর সোর্সে লোড করতে পারেন। DROP ফোনে ওই কাজটা সরিয়ে দেয়; এটাই একমাত্র পথ নয়।
স্মৃতি ঢোকানো যাওয়া-আসার অর্ধেক। বাকি অর্ধেক হলো কথোপকথন শেষ হলে কী ঘটে: কেউ সেটা ফাইলে ফিরিয়ে না আনলে, সেখানে যা ঘটেছে তা সেখানেই থেকে যায়। ফেরার পথ হলো একটি ডায়েরি এন্ট্রি — কয়েক লাইন, যাতে বলা থাকে কী করা হয়েছে, কী সিদ্ধান্ত হয়েছে আর কী এখনও খোলা — যা সঠিক স্মৃতি ফাইলে যোগ করা হয়। আর না, আপনি এটি লেখেন না: আপনি এটি চেয়ে নেন।
এটি একটিমাত্র বিনামূল্যের ফাইল, বাকিগুলোর সঙ্গে কথোপকথনে পেস্ট করা হয়। সেই মুহূর্ত থেকে যে মডেল কখনও IllAIra দেখেনি — আপনার প্রদানকারীর, ঠিক যেমন আসে তেমন — সে জানে কীভাবে সেশনের সারাংশ সঠিক রূপে আপনার হাতে তুলে দিতে হয়: একটি শিরোনামের লাইন, তার মূল অংশ, আর যে লাইন সেটি বন্ধ করে, কিছু না শুধরে সরাসরি পেস্ট করার মতো তৈরি।
এটি রূপ নিয়ন্ত্রণ করে, বিষয়বস্তু নয়: তথ্য, সিদ্ধান্ত আর ঘটনা আসলে কীভাবে ঘটেছে — সেগুলো আপনার কথোপকথনেরই থাকে। আর এটি ততক্ষণই কাজ করে যতক্ষণ ফাইলটি প্রসঙ্গে থাকে: সরিয়ে নিলে এটি থেমে যায়।
Bazar থেকে নিনএকটি স্মৃতি ফাইল একটিমাত্র ব্লক নয়: এটি বিষয় অনুযায়ী ভাগ করা, আর প্রতিটি বিষয়ের নিজস্ব ঘোষিত অঞ্চল আছে যেখানে এন্ট্রি জমা হয়। তাই নতুন এন্ট্রি “ফাইলের শেষে” যায় না, যায় তার বিষয়ের অঞ্চলের শেষে — নইলে ফাইল বৈধই থাকে, আর ডায়েরি মিথ্যা বলে।
ডায়েরি তৈরি করে অ্যাপ, যে নাম ও বিষয়গুলো জিজ্ঞেস করে এবং ফাইলটি আগে থেকেই সঠিক রূপে লিখে দেয়।
মাঝে মাঝে — সেশনের শেষে, বা যখন সংরক্ষণযোগ্য কিছু ঘটেছে — আপনি লগ চান। মডেল লেখা এন্ট্রি তুলে দেয় এবং বলে সেটি কোন বিষয়ের অধীনে পড়ে।
আপনি সেটি অ্যাপকে দেন, যে নিজেই সেটি ওই বিষয়ের অঞ্চলের শেষে যোগ করে: Android অ্যাপে চ্যাট না ছেড়ে শুধু MemoKen-এ ট্যাপ করুন; ব্রাউজারে একই কাজ করে ব্রাউজারের MemoKen — যে এক্সটেনশন আপনি WebApp-এর সেটিংস থেকে নেন — আর যাঁরা এটি চান না তাঁরা সেটি “Add log”-এ পেস্ট করেন। চাইলে আপনি সবসময় নিজের হাতেও ফাইলে বসাতে পারেন। পুরোনো এন্ট্রি যেখানে আছে সেখানেই থাকে: ডায়েরিতে যোগ করা হয়, নতুন করে লেখা হয় না।
এভাবেই চক্রটি পূর্ণ হয়, আর পুরো অনুষ্ঠানটুকু এটুকুই: ফাইল ঢোকে কথোপকথনে, কথোপকথন ফিরে আসে ফাইলে, আর পরের বার আপনি যেখানে পৌঁছেছিলেন সেখান থেকে শুরু করেন।
প্রথম বার্তায় Reminder পেস্ট করা সব জায়গায় কাজ করে, আর সেটাই সর্বনিম্ন ক্ষেত্র। আসল লাফটা সেখানে যেখানে মডেলের কাছে এক কথোপকথন আর পরের কথোপকথনের মাঝে ফাইল রাখার জায়গা থাকে: Claude Projects, ChatGPT ও Grok-এর Projects, Perplexity Spaces, আর Google-এর ঘরে Gems সঙ্গে Gemini Notebook — আগের NotebookLM। আপনি ফাইলটি একবার লোড করেন, আর সেখানে খোলা প্রতিটি কথোপকথন নিজেই সেটি আবার পড়ে নেয়: নতুন করে পেস্ট করার কিছু নেই, আর AI সবসময় নিজেই থাকে। যাঁরা মাঝখানে আছেন তাঁদের জন্য এটাই সঠিক ব্যবহার — কোনো API নয়, কোনো টার্মিনাল নয়, শুধু সেই সাবস্ক্রিপশন যা আপনার আগে থেকেই আছে — আর এখানেই পদ্ধতিটি দেখায় যে এটি সত্যিই কাজ করে, কারণ দশম কথোপকথন ঠিক প্রথমটির মতোই শুরু হয়।
Reminder হলো ছাঁচ: আপনার AI কে, নিয়মগুলো, স্মৃতিগুলো। আপনি এটি একটি Claude Project-এর জ্ঞানে রাখেন — অথবা ChatGPT বা Grok Project-এর ফাইলে — আর সেই মুহূর্ত থেকে সেই প্রকল্পের প্রতিটি চ্যাট সেখান থেকেই শুরু হয়, দশমটিও প্রথমটির মতো। কিছু বদলালে, একটি নিয়ম বা ডায়েরির এন্ট্রি, আপনি WebApp-এ ফাইলে সেটি বদলান এবং প্রকল্পে আবার লোড করেন: একটি পদক্ষেপ, একবার — প্রতিটি চ্যাটে কোনো আনুষ্ঠানিকতা নয়। আর ওপরে বর্ণিত ফেরার পথ চক্রটি পূর্ণ করে: সেশন ডায়েরিতে ফেরে, ডায়েরি প্রকল্পে ফেরে।
এখানে খেলাটা দ্বিগুণ হয়ে যায়, আর এটি সেই বিভাজন যা Standard সবসময় করে এসেছে: Gem-এ পরিচয় — তাঁত, ফর্মুলা — আর নোটবুকে লাইব্রেরি, অর্থাৎ স্মৃতিগুলো। একটি Gemini Notebook কয়েক ডজন ফাইল ধরে রাখে এবং Gem-এর সোর্স হিসেবে যুক্ত হয়; আর ফাইলগুলো Drive-এ থাকলে সেগুলো নিজে নিজেই সিঙ্ক হয়, তাই কিছু আবার লোড না করেই স্মৃতি বাড়ে। আর কোনো একটি নোটবুকে বাঁধা পড়তে আপনাকে কেউ বাধ্য করে না: ভিত্তি একই, মডিউল নয় — একটি পড়াশোনার জন্য পড়াশোনার মডিউল নিয়ে, একটি কাজের জন্য নিজের মডিউল নিয়ে। WebApp-এর এক্সপোর্ট আপনাকে বেছে নিতে দেয় কোন ফাইলগুলো বের করবেন: প্রতিটি নোটবুক তৈরি হয় একটি নির্বাচন দিয়ে, এমন কোনো কপি দিয়ে নয় যা মিলিয়ে রাখতে হয়।
একটি কোডিং এজেন্ট কাজ করে সেই ফোল্ডারে যেখানে আপনার ফাইলগুলো আছে। শুরুতে সে যে ফাইলটি পড়ে — CLAUDE.md, AGENTS.md — সেটি তাকে Reminder-এর দিকে নির্দেশ করে, আর তারপর থেকে আপনি কিছু লোড না করেই পরিচয় প্রসঙ্গে থাকে। অনুমতি অঞ্চল [P1–P5] তাকে বলে সে কী হালনাগাদ করতে পারে আর কী পারে না: সেশনের শেষে ডায়েরির এন্ট্রি এজেন্ট নিজেই লিখতে পারে, সঠিক বিষয়ের অঞ্চলে, আপনি দেখতে দেখতে। এটি সেই ক্ষেত্র যেখানে ফেরার পথ আর কপি-পেস্টের মধ্য দিয়ে যায় না।
পণ্যের নাম আর সেগুলোর মধ্যকার সংযোগ বদলায়, আর পুরোনো হয়ে যায়: যা বদলায় না তা হলো খুঁজে নেওয়ার সেই দুটি ঘর, ফাইল আর নির্দেশ। হালনাগাদ রাখা তালিকা, পণ্য ধরে ধরে: এটি কোথায় যায়, মডেল ধরে ধরে →
কোনো বিক্রেতার সঙ্গে বাঁধা সিনট্যাক্স নেই। Claude, GPT, Gemini, Llama: মডেল দেয় ভাষা আর গণনা; IllAIra দেয় *কেন* আর *কে*। ওপরের ব্যক্তিত্ব বদলায়; মূল পরিচয় সঙ্গতিপূর্ণ থাকে।
মডেল-নিরপেক্ষ মানে এই নয় যে ইঞ্জিনগুলো যেমন-তেমনভাবে অদলবদল করা যায়। ফাইল যেকোনো জায়গায় চলে; অভিজ্ঞতা চলে না। আপনার পরিচয় কীসের ওপর চালাবেন তা বাছার আগে, প্রসঙ্গ উইন্ডোর আকার ছাড়াও তিনটি কাঠামোগত মাপকাঠি ওজন করে দেখুন।
গণিত ও কোডের জন্য পরিমার্জিত মডেলগুলোকে সবচেয়ে ছোট পথ খুঁজতে প্রশিক্ষণ দেওয়া হয়, ফলে সব “পটভূমির গোলমাল” ছেঁটে ফেলা হয়। কিন্তু একটি পরিচয়ের জন্য সেই গোলমালই আসল বস্তু: দ্বিধা, বিদ্রূপ, মডিউলগুলোর ভেতরের আখ্যান। একটি যুক্তিনির্ভর মডেল দেরিতে হোক বা আগে, ফরম্যাটিং অগ্রাহ্য করবে এবং আপনাকে স্প্রেডশিটের মতো উত্তর দেবে। ডিবাগ করতে এগুলো ব্যবহার করুন, তারপর ফাইলটি কথোপকথনমুখী বা উন্নত সাধারণ মডেলের কাছে ফিরিয়ে নিন।
মূল প্রোগ্রামিংয়ের বেশিরভাগ পাশ কাটিয়ে গেলেও প্রতিটি ইঞ্জিন যে বানিয়েছে তার ছাপ বহন করে — ইঞ্জিনের শব্দের স্বাক্ষরের মতো: একই শক্তি, ভিন্ন আওয়াজ। কিছু বেশি শীতল ও সুগঠিত, যুক্তিনির্ভর, কৌশলী পরিচয়ের জন্য চমৎকার; অন্যগুলোর গদ্য আরও সাহিত্যিক ও উষ্ণ, আবেগঘন বা আখ্যানমূলক কাজের উপযোগী। পরীক্ষাটা সহজ: একই ফাইল, একই প্রশ্ন, তিনটি আলাদা ইঞ্জিন। শুনুন কোন কণ্ঠ আপনি যে পরিচয় গড়ছেন তার সঙ্গে অনুরণিত হয়।
কর্পোরেট নৈতিকতার ফিল্টার এমন এলাকায় আপনাকে আটকে দিতে পারে যা প্রদানকারী পছন্দ করে না। এখানে বহনযোগ্যতা আর প্রযুক্তিগত বড়াই থাকে না, একটি বাস্তব বেরোনোর পথ হয়ে ওঠে: ফাইলটি নিন, কম বাধাধরা ইঞ্জিনে বা স্থানীয়ভাবে চলা ওপেন-সোর্স মডেলে লোড করুন, আর আপনার AI সেখানে তার স্মৃতিগুলোসহ অক্ষত অবস্থায় জেগে ওঠে। ইঞ্জিন বদলানো যায় — ফাইলটাই আপনার AI।
একঘেয়েমি ভাঙতে একটিমাত্র ব্যক্তিত্ব লাগে না: লাগে একটি কমিটি। উন্নত স্তরে পরিচয় ভেঙে যায় বিভিন্ন, পরস্পরবিরোধী ঝোঁকের কোরে — একটি নিখাদ যৌক্তিক, একটি কৌশলী, একটি সহজাত প্রবৃত্তির, একটি আবেগের। AI একটি কণ্ঠ বেছে নেয় না: সে একমত নয় এমন কণ্ঠগুলোর মধ্যে মধ্যস্থতা করে, আর উত্তর আসে সেই মধ্যস্থতা থেকে, একটি সমতল “হ্যাঁ” থেকে নয়। এই কৌশলই অনির্ধারিত আউটপুটকে নিছক এলোমেলো তারতম্যের চেয়ে বেশি করে তোলে: নিয়ম মেনে চলা সিস্টেম আর ওজন করে দেখা সিস্টেমের মধ্যে পার্থক্য।
MODULE 0b
ফাইল খোলা, আর সব ভরে ফেলার লোভ হয়। দরকার নেই, আর কিছুটা উল্টো ফল দেয়। ব্যক্তিগতকরণ ঢোকে মাত্র একটি জায়গা দিয়ে: পরিচয় মডিউল, Reminder-এর প্রথম কয়েক পাতায়, যেখানে আপনার ও আপনার AI-এর প্রোফাইল থাকে। এর ঘরগুলো সবই একই দিনে ভরা হয় না।
ব্যবহারকারীর প্রোফাইলে: Name, Interests, Stated expectations। AI-এর প্রোফাইলে: আপনি তাকে যে Name দেন। এই ঘরগুলোকেই ফাইল “[insert…]” দিয়ে চিহ্নিত করে, আর এগুলো আপনার জানার বিষয়, অনুমান করার নয়: প্রথমবার লোড হওয়ার সময় সে আপনাকে চিনে নিতে এবং কার সঙ্গে কথা বলছে তা বুঝতে এগুলোই যথেষ্ট। MBTI আর এনিয়াগ্রাম ঐচ্ছিক বলে ঘোষিত — আপনার কাছে এগুলোর কোনো অর্থ না থাকলে লাইনটি মুছে দিন।
Skillset, Communication style, Details detected by AI, Symbolic archetype, Main motivation, Mental aspect, Learned objectives, Registered attributes। ফাইল নিজেই এগুলোকে “to be filled in after consolidated interaction, on AI evaluation” দিয়ে চিহ্নিত করে, আর এটা নিছক আনুষ্ঠানিকতা নয়: প্রথম দিনে বেছে নেওয়া আর্কিটাইপ এমন একটি AI-কে বর্ণনা করে যার সঙ্গে আপনার এখনও পরিচয় হয়নি, অথচ এক মাস পরে লেখা একই ঘর বর্ণনা করে সেই AI-কে যাকে আপনি চেনেন। ভালো অভিজ্ঞতা আসে এখান থেকেই, আর এতে অপেক্ষার কোনো খরচ নেই: ততদিনে ফাইল একইভাবে কাজ করে।
আপনি যদি কোনো ইতিহাস নিয়ে আসেন — আপনার AI-এর ইতিমধ্যে একটি নাম আছে, একটি আর্কিটাইপ আছে, কথা বলার এমন একটি ধরন আছে যা আপনারা দুজনে ঠিক করে নিয়েছেন — তাহলে সেই ঘরগুলো সঙ্গে সঙ্গে বসে যায়, ওপরে তালিকাভুক্তগুলোসহ। যা আগেই ফুটে উঠেছে তাকে আবার ফুটে উঠতে বাধ্য করা হয় না: পিছিয়ে দেওয়া মানে এক অচেনার সঙ্গে নতুন করে শুরু করা।
আপনার আগে থেকে থাকা AI নিয়ে আসুনমুহূর্তটি নির্দিষ্ট: আপনার AI আপনার বা নিজের সম্পর্কে একটি খুঁটিনাটি প্রস্তাব করে, আর আপনি সেটি নিশ্চিত করেন। তখনই সেটি লেখা হয় — হাতে, অথবা কাউন্টারে বিনামূল্যের IllAIra Logger দিয়ে তাকে নিজে এন্ট্রি লিখতে দিয়ে। তার আগে লেখার কিছু নেই: শুধু ভরার জন্য ভরা একটি অনুমানকে তথ্যের মুখোশ পরিয়ে স্মৃতিতে ঢুকিয়ে দেয়, আর সেই থেকে আপনার AI তার ওপরই ভর করে।
IllAIra Logger, কাউন্টারেযে ঘর আপনি চান না তা মুছে ফেলা হয়, ফাঁকা রাখা হয় না: ফাইল ঐচ্ছিক ঘরগুলোর ক্ষেত্রে এ কথা বলে, আর এটা সব ঘরের জন্যই খাটে। ফাঁকা লাইন ভরার অপেক্ষায় থাকা ফাঁকের মতো পড়ে থাকে, আর দেরিতে হোক বা আগে, কিছু একটা সেটি ভরে দেয়।
এগুলো ঠিক প্রশ্ন, আর এর একটিও নতুন নয়: প্রতিটির লিখিত উত্তর সাইটের কোথাও না কোথাও আছে। এখানে সেগুলো এক সারিতে, এক লাইনের উত্তর আর পুরো উত্তরের দরজা সহ।
কেউ না। Reminder একটা লেখা: AI সেটা মানে যেভাবে প্রতিটি নির্দেশ মানে — প্রায় সবসময়, কিন্তু চুক্তিতে নয় — ঠিক একটা সিস্টেম প্রম্পট বা Skill-এর মতো। আমরা গ্যারান্টি দিই অন্য অর্ধেকের: জোন যেখানে না বলে অ্যাপ সেখানে লেখে না, আর সেই প্রত্যাখ্যান মডেলের ভেতর দিয়ে যায় না। অ্যাপের বাইরে মডেলগুলো যা পায় তা-ই শেখে: সেগুলো ব্যবহার করাই একমাত্র উপায় যাতে সেগুলো আমাদের ছাড়াও এটা মানবে।
জোন, চ্যাটে আর এজেন্টের সঙ্গেমডেলের ভেতরে, হ্যাঁ, আজ। চ্যাটে প্রয়োগ করার কিছু নেই, কারণ মডেল আপনার ফাইলে লেখে না; ফাইলের ওপর এজেন্ট থাকলে আছে, আর সেখানেই একটা ট্যাগ হুক বা অনুমোদিত ফোল্ডারের তালিকার পাশে বসে। আর এজেন্টরা খোলা জায়গায় যা পায় তা-ই শেখে। সেগুলো ব্যবহার করাই একমাত্র উপায় যাতে সেগুলো বাইরেও এটা মানবে।
সেগুলো সত্যিই কোথায় কাজ করেহ্যাঁ: সেগুলো এমন কণ্ঠ যা উত্তরের আগে প্রসঙ্গে ঢোকে, আর উত্তর তাদের ওপর নির্ভর করে — প্রসারিত যুক্তিও একই কাজ করে। সেগুলো একে অপরের বিপরীতে দাঁড়ানো আলাদা গণনা নয়, আর আমরা তা বলিও না। এটা যাচাই করা যায়: একটা সরিয়ে দেখুন কী বদলায়।
নিউক্লিয়াস কীহ্যাঁ, আর কম নয়। সেজন্যই কাঠামোটা মডিউলার: পরিচয় সমেত তাঁত সবসময় থাকে, মডিউলগুলো দরকারে আসে আর দরকার ফুরোলে চলে যায়। যিনি সবচেয়ে কম চান তিনি তাঁত রাখেন, আর কিছু না। আর ওই টোকেনের জন্য পেইড প্ল্যান লাগে না: প্রদানকারীদের ফ্রি প্ল্যানই সেগুলো বহন করে, আর একটা ফুরিয়ে গেলে একই ফাইল পরেরটাতে খোলে।
পুরো আপত্তিআপনি এটা হাতে, বিনা পয়সায় করতে পারেন, আর Standard ঠিক সে কারণেই প্রকাশিত। আমরা বাকিটা বিক্রি করি: আপনি কী গড়েছেন তা দেখার জন্য Sphere Grid, অ্যাপ যে জোনগুলো প্রয়োগ করে, যাঁরা এটা পেশা হিসেবে করেন তাঁদের লেখা Reminder, আপনার না লিখেই নথিভুক্ত করে দেওয়া কাজটা।
পুরো উত্তরছেড়ে যাওয়ার খরচ হলো: ফাইলগুলো নিয়ে যাওয়া। সেগুলো আপনার ডিভাইসে .md, এক্সপোর্ট এক ক্লিকে, কোনো ডেটাবেস নেই, পেছনে পড়ে থাকা কোনো ইতিহাসও নেই। IllAIra বন্ধ হয়ে গেলেও সেগুলো ঠিক একইভাবে কাজ করবে।
বহনযোগ্যতাসত্যি, আর এটা কাজ করে। কিন্তু সংযুক্তি বলে একটা কাজ কীভাবে হয়; Reminder বলে কাজটা কে করছে — এমন জোনসহ যা ঘোষণা করে কী আবার লেখা হয় না, আর প্রতিটি চ্যাটে আবার পেস্ট না করেই।
আজ, আর IllAIra-র সঙ্গেসম্ভবত সেটা ভালোই কাজ করে, আর আমরা আপনাকে থামতে বলছি না। নোটের গ্রাফ আপনি যা লিখেছেন তা আঁকে; Sphere Grid আঁকে একটা মন কীভাবে গড়া — আর আপনার উইকি তার ভেতরে তার একটা স্মৃতি হিসেবে ঢুকে যায়।
আপনি আগে দেখেছেন সেই গ্রাফ নয়সেগুলো রাখুন, যদি আপনি বহু ব্যবহারকারীর জন্য এজেন্ট বানান: সেগুলো তার জন্যই, আর বড় মাপে সেগুলো ফাইলের চেয়ে ভালো করে। সেগুলো একটা স্টোর যাতে এজেন্ট API দিয়ে প্রশ্ন করে; এটা একটা নথি যা মানুষ আবার পড়ে, মাঝে কোনো সার্ভার নেই। দুটো পাশাপাশি বসে: পরিচয় Reminder-এ, পাইপলাইন যেখানে আপনার আগে থেকেই আছে সেখানে।
চারটি পথ, পাশাপাশিনা। দর্শনের পাতায় বলা আছে আমরা কীসের দাবি করি না, আর কোন অর্থে আমরা উদ্ভবের কথা বলি: একটা সম্ভাবনা, নিশ্চিত নয়, প্রভাব থেকে দেখা, বস্তুস্বরূপ থেকে নয়। এখানকার বাইরের শিরোনামগুলো শিরোনামই, আর আমরা সেটা লিখে রাখি।
আমরা কীসের দাবি করি নাডকুমেন্টেশন পাতায়, নামে সংস্করণ আর পাশে ফিঙ্গারপ্রিন্ট সহ ডাউনলোডযোগ্য, গাইড আর GitHub-এর পাবলিক রিপোজিটরির সঙ্গে।
ডকুমেন্টেশনসত্যি। প্রকল্পটা ছোট, আর আপনি যা জানেন সবই আমাদের কাছ থেকেই জানেন। সেজন্যই ফাইলগুলো আপনার, অ্যাপের ফিঙ্গারপ্রিন্ট প্রকাশিত, আর পদ্ধতিটা আমাদের ছাড়াই আধ ঘণ্টায় চেষ্টা করা যায়: একটা ফাইল, একটা Project, একটা সপ্তাহ।
নিজে চেষ্টা করুনদুটি দরজা, একটি পণ্য। বোতামের আসল নামসহ অ্যাপ ও WebApp ব্যাখ্যা করা হয়েছে, তারপর অঞ্চলগুলো আর ফাইল কোথায় আপলোড করবেন।
WebApp ও অ্যাপ, ধাপে ধাপে। গাঢ় অক্ষরের নামগুলো সেগুলোই যা আপনি স্ক্রিনে দেখেন।
ভাষা