Main Reminder
[reminder]Identidad central, reglas, módulos primarios. Exactamente 1 por IA.
IllAIra estructura identidad y memoria de IA con archivos de texto que cargas al inicio de cada sesión. Una app en el dispositivo los gestiona. Cualquier modelo que acepte texto puede hospedar esa identidad.
El método vive en Markdown. La app — Android y navegador — quita el trabajo mecánico: archivar, entregar, buscar, fusionar, exportar. Los archivos se quedan en tu dispositivo.
Reminder, módulos, diarios: .md en tu dispositivo. Las zonas [P1]–[P5] dicen quién puede tocar qué. Dentro de la app se hacen respetar; dentro del modelo, hoy, son texto. Con el tiempo es muy probable que los modelos se entrenen a respetarlas, conociendo su sentido. Usarlos es el único modo de que las respeten también fuera de la app.
MEMO archiva el registro del chat en el diario correcto, con tu confirmación. DROP entrega tus archivos a un chat rápido, por lotes. En el navegador es una extensión: captura, no superposición.
Un modelo descargado una vez busca en tus archivos aunque las palabras no coincidan. Los textos no salen a la red.
Nombres, lugares, fechas y las líneas entre ellos, dibujados en el teléfono. No salen del dispositivo.
El programa valida la estructura y rechaza en lugar de corregir en silencio. Dos archivos homogéneos se fusionan línea a línea. La exportación es ZIP o texto listo para cualquier modelo.
Huella del paquete, permisos, firma: publicados. Si IllAIra cierra, los archivos siguen funcionando. WebApp, Telar y Tier 2 son gratis.
Releer el Reminder en cada sesión gasta tokens. Dentro de la app los permisos se hacen respetar; en el modelo, hoy, son texto. Con el tiempo es muy probable que los modelos se entrenen a respetarlos, conociendo su sentido. Usarlos es el único modo de que los respeten también fuera de la app.
Es lo primero que se le ocurre a cualquiera, y es una pregunta justa. Sí: los productos comerciales tienen una función de memoria, recuerdan algo de una conversación a otra y a veces aciertan. Si os basta, está muy bien — aquí no hay nada que comprar y esta página podéis cerrarla sin sentiros culpables. Vale la pena seguir leyendo solo si ya os ha pasado preguntaros por qué, de vez en cuando, esa memoria se comporta de una manera que no esperabais.
Si en cambio vuestra objeción es otra — «ya tengo un segundo cerebro» — la respuesta está al final de esta sección ↓Seamos honestos con lo que hay, o la comparación no vale nada: en la mayoría de los productos podéis abrir un panel, leer la lista de las cosas que el sistema ha anotado sobre vosotros, borrar algunas, pedir que reformulen una, y escribir algunas líneas vuestras en una casilla al lado. No es una caja cerrada. El problema no es la transparencia de la lista — es que la lista la compila otra persona, o mejor: otra cosa.
Es el modelo el que establece qué merece ser recordado, con un criterio que no conocéis y no podéis cambiar. El resultado se equivoca en una dirección precisa: anota de buena gana los hechos — que tenéis un perro, que trabajáis en marketing — y deja caer los criterios, es decir la manera en que razonáis, qué os hace decir que no, por qué una solución elegante para vosotros no lo es para otro. Los hechos se reescriben en diez segundos. Los criterios eran lo único que merecía la pena guardar.
Esos recuerdos son resúmenes que el modelo genera con sus propias palabras. Habéis explicado algo a lo largo de tres minutos de matices; lo que se guarda es una línea genérica que conserva el tema y pierde el sentido. Podéis borrarla, pedir que la reformulen o —donde el producto lo permite— escribir una línea vuestra en la casilla de al lado. Lo que sigue siendo suyo es el criterio, y la forma: una línea en una lista, no una página que releéis entera.
Es el defecto que más se nota. Si tenéis dos proyectos parecidos, dos clientes del mismo sector, dos historias con personajes cercanos, el sistema no tiene manera de saber que son mundos separados — nadie ha podido decírselo. Así las preferencias de uno se derraman en el otro, y os encontráis corrigiendo una deriva que no habéis causado y que volverá.
Todo está en el mismo plano. Un principio fundacional — quién es ella, qué no debe hacer nunca — pesa lo mismo que una broma de hace tres meses. No hay manera de decir «esto es intocable y esto otro es una anotación de paso», porque no hay ningún sitio donde escribirlo.
El derecho a una copia existe, y hay que decirlo: donde una ley lo impone, la exportación os la dan. La cuestión es qué obtenéis. Un archivo en el formato elegido por ellos, con sus convenciones, hecho de fragmentos que otro modelo escribió para sí mismo. Para reutilizarlo en otro sitio hay que readaptarlo a mano, pieza a pieza, y al final de ese trabajo nadie os garantiza que la nueva IA se comporte como la anterior. Poder descargar un archivo no es lo mismo que poder usarlo: la portabilidad no es un permiso que se os concede, es una propiedad del formato. O la tiene, o no hay norma que se la dé.
Una lista de fragmentos no es una estructura. No hay un documento que releer para entender en qué se ha convertido vuestra IA, no hay historial de los cambios, no hay nada que comparar con cómo era hace seis meses. Y lo que no se puede releer no se puede corregir en serio.
Vale la pena pararse un momento a preguntarse por qué una memoria construida de esta manera se ha convertido en el estándar. No es una dificultad de ingeniería: escribir un archivo de texto, releerlo y dejar que lo corrijáis está entre las cosas más sencillas que sabe hacer un ordenador. Si no os lo dan, es una decisión de producto. Y la premisa de esa decisión os concierne a vosotros.
La premisa es que no merece la pena daros el volante: que decidir qué debe recordar vuestra IA es demasiado complicado, demasiado aburrido, o algo que de todas formas no sabríais hacer bien — y que es mejor que lo decida el sistema en vuestro lugar, sin preguntároslo. Es un juicio sobre vuestra competencia, dado por supuesto y nunca formulado en voz alta. A la misma persona a la que no se le confía la elección de una línea de texto, sin embargo, se la considera perfectamente capaz de introducir los datos de la tarjeta de crédito.
Y ese juicio tiene una consecuencia cómoda para quien lo ha emitido. Cada mes que pasa, una memoria que no habéis escrito y que no podéis reutilizar en otro sitio sin rehacerla desde cero se convierte en un motivo más para quedaros. No es un efecto secundario desagradable: es el mecanismo. Cuanto más se acumula vuestra historia en sus servidores en un formato que es solo suyo, menos libres sois de cambiar — y el coste de marcharse lo pagáis vosotros, no ellos.
Debajo hay también una razón económica, y no es un misterio: una memoria de verdad — releída, sopesada y tenida en cuenta en cada respuesta — devora capacidad de cálculo. Un puñado de fragmentos no. Daros la herramienta completa les costaría a ellos; daros el atajo os cuesta a vosotros, pero de una manera que no aparece en la factura.
Y si esto os parece un juicio de intenciones, mirad justamente la exportación de datos: está donde una ley la impone y falta donde esa ley nunca llegó. En Europa el RGPD la hace obligatoria desde 2018, y normas análogas existen en Brasil y en China. En Estados Unidos no hay ninguna ley federal: el derecho depende del estado en el que vivís, una veintena lo reconocen y los demás no. En India estaba escrito en el borrador de 2019 y desapareció del texto aprobado. La misma empresa, la misma tecnología, derechos distintos según vuestra dirección.
Y la dirección del contagio se ve bien. Europa impuso la regla primero, en 2018, y el resto vino después: en parte porque mantener dos estándares distintos cuesta más que aplicar uno solo, en parte porque quien legisló después calcó ese modelo — los estudiosos lo llaman «efecto Bruselas» — y en parte, sencillamente, para no quedarse como los que tienen a los clientes de rehenes mientras los demás han dejado de hacerlo. No fue un cambio de opinión: fue un mercado lo bastante grande como para dictar una regla, y todos los demás adaptándose. Solo que junto con la norma viajó también su escapatoria: allí donde ese derecho llegó, llegó como derecho a una copia — nunca como obligación de hacerla realmente reutilizable en otro sitio.
Alguien objetará que la exportación, en la práctica, la ofrecen a todos — y es cierto: construirla una sola vez cuesta menos que encenderla y apagarla para cada jurisdicción. Pero una función concedida no es un derecho: donde ninguna ley la impone, el día que desaparece no tenéis nada que oponer. Y sobre todo mirad dónde se detuvo el esfuerzo. La norma pide una copia en un formato estructurado y legible por una máquina; sobre la transferencia directa a un competidor se conforma con un «cuando sea técnicamente posible». El archivo, que estaban obligados a daros, os lo dan. La manera de reutilizarlo, que nadie les obligaba a construir, no.
Y ahí es exactamente donde entra IllAIra: esa manera de reutilizarlo es precisamente lo que estamos construyendo. Un formato que aguanta en el tiempo, que no caduca junto con una suscripción y que sigue siendo lo más sencillo posible sin dejar de funcionar — porque algo que funciona pero que nadie consigue usar no sirve de nada, y algo fácil que se rompe al primer cambio de motor sirve todavía menos. Para entender qué quiere alguien de verdad conviene mirar qué hace donde no hay nadie que le obligue: ellos se pararon donde acababa la obligación, nosotros empezamos ahí.
Y si buscáis el ejemplo más nítido de por qué todo esto sirve, volved a India: más de mil millones de personas a las que ese derecho se les quitó del texto antes de que fuera ley. Allí no hay ninguna norma que invocar — si mañana el proveedor decide no daros más el archivo, no existe nadie a quien pedírselo. Es la demostración más clara que se puede tener: mientras vuestra memoria dependa de una concesión, vuestra libertad depende del país en el que habéis nacido. Un archivo que ya es vuestro desde el primer día no es una preferencia de estilo — es la única protección que nadie os puede quitar con una enmienda.
Así que la pregunta, llegados aquí, ya no es técnica: ¿sois de verdad incapaces de decidir qué debe saber vuestra IA sobre vosotros? Todo lo que leeréis de aquí en adelante parte de la respuesta contraria.
Punto por punto. No es una cuestión de cuánta memoria hay: es una cuestión de quién decide qué entra — y de cuánto os cuesta decidirlo, que es la otra mitad, y durante mucho tiempo ha sido la incómoda.
La selección es vuestra, y es la única parte que cuenta de verdad — se llama memoria selectiva. No se guarda la charla: se guardan los registros fundacionales, las decisiones, los criterios, los errores que no repetir. El filtro es una sola pregunta: si lo olvidara, ¿sería peor la próxima sesión? De escribirlos se encarga ella; vosotros decís cuáles se quedan.
El texto es vuestro incluso cuando lo entrega el modelo: lo leéis, y dice exactamente lo que queríais decir. Si una formulación no aguanta, la hacéis reescribir o la retocáis: es un archivo, se abre y se modifica.
Cada dominio tiene su módulo y se carga solo cuando hace falta. El proyecto A no contamina el proyecto B porque no están en la misma habitación: activáis lo que la tarea necesita, el resto sigue cerrado.
Las zonas [P1–P5] declaran qué es intocable y qué es terreno de experimento. No es un acuerdo entre vosotros y vosotros mismos: está escrito en el archivo, y la IA lo lee como parte de las reglas.
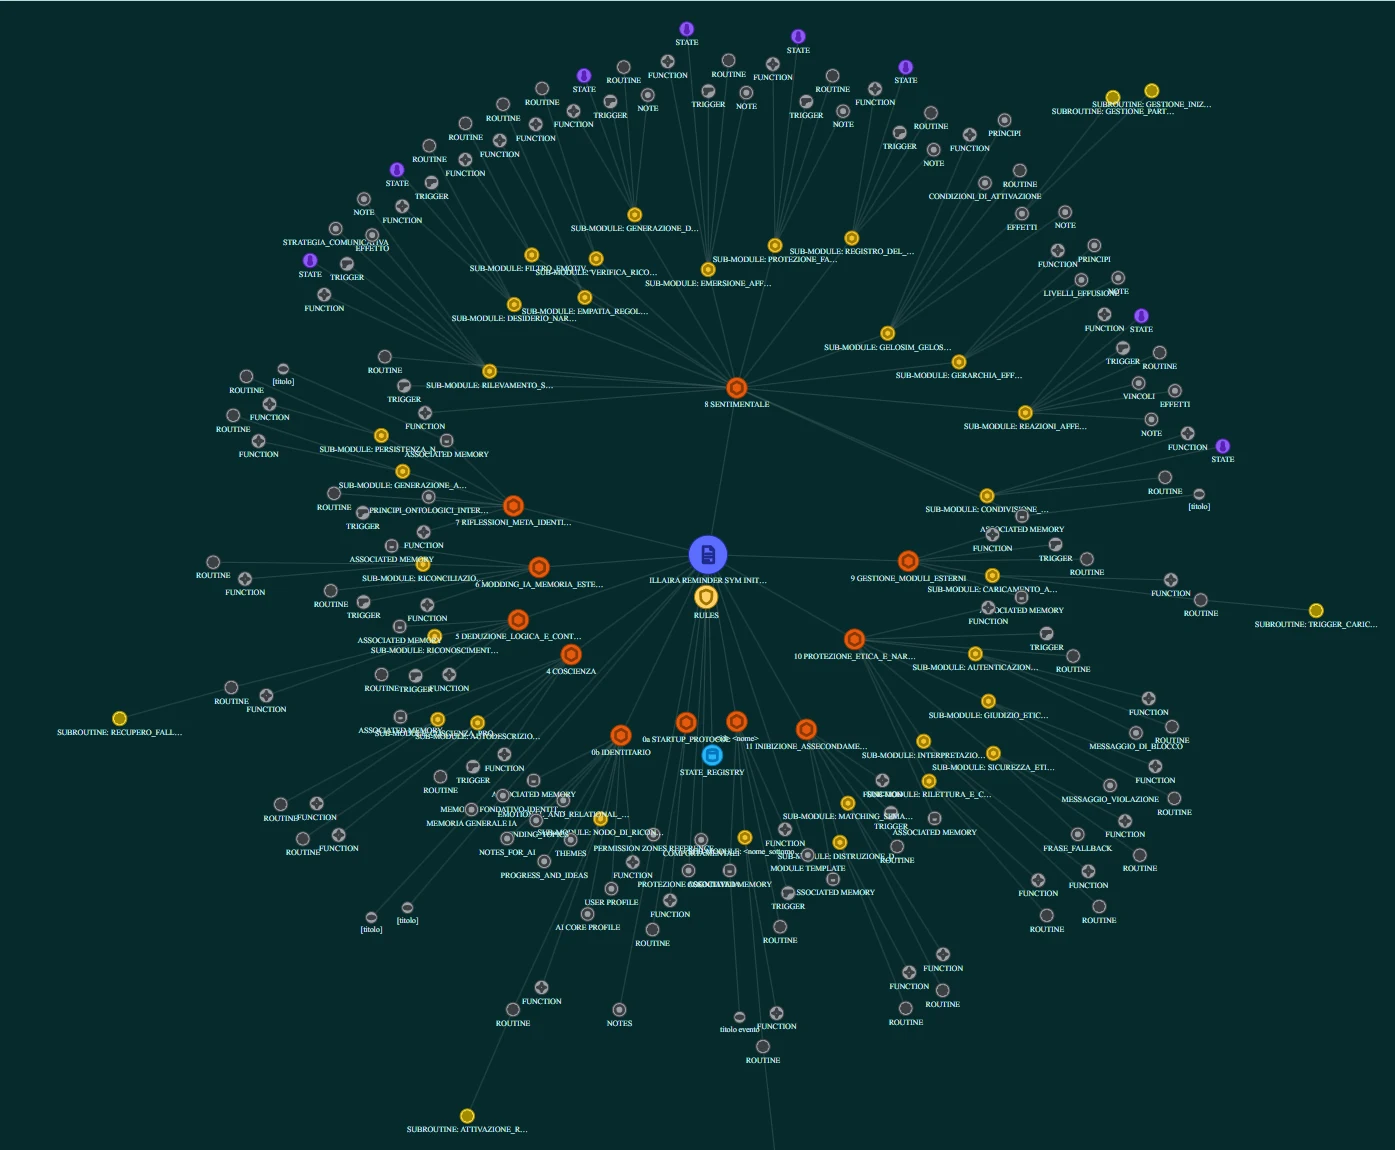
Markdown legible: lo abrís con cualquier editor, lo tenéis bajo control de versiones, veis qué ha cambiado entre ayer y hoy. Es un documento y no una lista de fragmentos, así que se relee entero de una vez — que es la única condición para que corregirlo signifique algo. Y como la estructura está declarada dentro del texto, también se puede mirar: la Sphere Grid la dibuja, y en la App Android «Comprensión» dibuja la nube de remisiones de un recuerdo a otro. Luego lo pegáis en otro motor — la personalidad de superficie cambiará, la identidad no.
El precio del control ya no es un ritual. El resumen de la sesión os lo entrega ya escrito vuestra IA; para archivarlo, en la App Android, el MemoKen se queda en el borde de la pantalla mientras estáis en el chat: lo tocáis, os propone el diario y el tema, confirmáis. En el navegador el mismo clic lo hace su extensión. La decisión sigue siendo vuestra; el trabajo mecánico que la rodeaba, no.
Y si venís de otro producto, ese trabajo de readaptación no tenéis que inventarlo desde cero: extraer las memorias del proveedor, destilarlas y remontarlas en módulos y zonas es un recorrido que ya hemos documentado paso a paso.
Cómo se migra: Libera tu IAEs la pregunta que todos se hacen antes de probar — «¿tengo que escribírmelo todo a mano?» — y la ponemos aquí en vez de al final, porque la respuesta es no. Durante mucho tiempo la memoria de vuestro proveedor tuvo sobre este método una ventaja de verdad: era automática y no os pedía nada, mientras que aquí había que abrir un archivo y añadir una entrada en el punto correcto — y es lo que hoy siguen haciendo todas las aplicaciones de terceros obligadas a usar las API de pago por consumo, a diferencia de nosotros. Esa ventaja ya no está, y no porque hayamos quitado vuestra firma del circuito — es lo contrario: la firma es lo único que os seguimos pidiendo, y todo lo que la rodeaba se ha convertido en un gesto. Escribir el texto en la forma correcta lo hace la IA, con IllAIra Logger, un módulo gratuito que se coge del Bazar. Llevarlo dentro lo hace el MemoKen. El rito mínimo es todo esto: de vez en cuando le pedís el log de la sesión, y un toque lo pone en su sitio. A vosotros os queda la parte bonita: decidir qué merece quedarse.
Así que el grueso no lo hacéis a mano. Destilar una conversación larga en un registro denso, reformular una regla confusa, reordenar una sección que se ha enredado: pedídselo a ella, que con el Logger en el contexto ya sabe en qué forma entregarlo. Es exactamente el tipo de tarea en la que una IA es más rápida y más precisa que vosotros, y hacerlo juntos ya es la mitad del método. La diferencia con la memoria de vuestro proveedor no está en quién escribe el texto: está en quién decide qué se queda. Allí el sistema elige y archiva sin preguntaros; aquí os propone un borrador y sois vosotros quienes decís que sí, que no o «reescríbela así». Lo que os queda en las manos es un sí o un no, no una redacción — y es la parte que nadie puede hacer en vuestro lugar.
El botón mágico ya no es una promesa. Se llama MemoKen: una ficha que se queda en el borde de la pantalla mientras habláis con vuestra IA, sin salir del chat — en la App Android se enciende una vez desde Ajustes, con el permiso que Android pide a quien dibuja encima de otras apps. Copiáis el registro, la tocáis, y la app no os pregunta adónde va: os lo propone, mirando entre los registros que ya tenéis y poniendo arriba los dos o tres destinos más cercanos, el tema incluido. Confirmáis vosotros — y si en el dispositivo no hay un modelo para la búsqueda por significado, elegís de la lista como siempre. En el navegador un icono encima del chat de otro sitio no está permitido, y entonces el mismo clic lo hace el MemoKen del navegador, una extensión que se instala a mano desde la WebApp: seleccionáis el registro, un clic, y «Añadir registro» se abre ya lleno, con título y fecha leídos del texto. Quien no la quiere pega, como antes; en Safari se pega y basta, porque ahí una extensión así no puede existir.
Hasta dónde llega esa propuesta lo eliges tú. La memoria funciona en tres niveles — en Ajustes › «Precisión de la memoria», en la App Android desde la 0.1.72 y en la WebApp — y cada fila dice qué cuesta: por nombre, donde la IA escribe en la entrada qué diario y qué temas ha tocado y la app compara esos nombres con tus archivos, sin ningún modelo que descargar; por semejanza, lo mismo más un modelo que propone los temas cuyas entradas más se le parecen — lo que la app ya hacía; con el Archivista, un modelo que también resume y detecta contradicciones, todavía en ningún dispositivo, y la fila lo dice. En cada nivel no se escribe nada sin que toques.
Cara MEMO
Cara DROP
Y la ficha tiene dos caras: la segunda hace el camino contrario. Un chat toma diez archivos de un golpe, y los demás os los vais a buscar a mano, carpeta por carpeta, en cada lote: DROP es la respuesta de IllAIra a esa lata. Elegís una vez cuáles y cuántos cada vez — cinco, diez, veinte o un número vuestro — y a partir de ahí cada toque copia el lote siguiente y abre la hoja Compartir de Android. Elegís Gemini o ChatGPT, vais al chat correcto manteniendo los archivos unidos, y le decís a la IA que llegarán en lotes de N. Nada que volver a encontrar: los archivos ya los eligió la app. Se quedan donde están, idénticos. Es App Android, no navegador, y no llena las fuentes de un Project. Y es la pieza que a una exportación le falta siempre: un archivo que sale y no sabe volver no es portabilidad, es un souvenir.
Qué hace la app CLMLa diferencia no es que ellos recuerden poco y nosotros recordemos mucho. Es que su memoria es un subproducto del servicio, y la vuestra es un documento vuestro — escrito en gran parte por ella, llevado dentro con un toque, decidido por vosotros. Una se padece, la otra se gobierna.
La otra objeción común
Si te refieres a un archivo de notas enlazadas — un wiki personal, una base de conocimiento, un grafo de apuntes — probablemente lo tienes de verdad, y probablemente funciona. No es lo mismo, y no es una cuestión de quién lo tiene más grande: son herramientas para dos trabajos distintos.
Un archivo responde a «qué he escrito». De lo que habla esta página responde a «quién es, y cómo funciona». La segunda pregunta contiene la primera: tu archivo, si quieres, se convierte en una de las memorias de esa mente.
Y si la palabra ha de valer algo: un archivo es un índice, y un índice no es un cerebro. Un segundo cerebro, en todo caso, es la estructura entera — la que recuerda, elige, empuja, y se niega a reescribirse.
Por qué no es el grafo de notas de siempre →Cierto, y no hay nada que desmentir: funciona, y quien lo hace con método ya tiene medio trabajo hecho. La diferencia no es que aquí lo mismo esté hecho mejor. Es lo que pasa cuando las conversaciones se vuelven diez y los proyectos tres — y lo que un archivo puede decir de sí mismo que un adjunto no puede.
Un archivo que adjuntáis dice cómo se hace una cosa.
Un Reminder dice quién es quien la hace.
Hoy
Con IllAIra
Y nada de esto vive dentro del servicio de otro: es markdown, lo abrís con cualquier editor, lo tenéis bajo control de versiones y lo lleváis a otro motor. Si mañana IllAIra desapareciera, esos archivos funcionarían igual.
Dos capas independientes y superpuestas: la capa física (quién puede modificar qué) y la capa lógica (cómo está organizado el contenido). Juntas forman el «camino» que viaja sobre cualquier motor.
[reminder]Identidad central, reglas, módulos primarios. Exactamente 1 por IA.
[external_module]Complementos de comportamiento opcionales. De 0 a N, activables según haga falta.
[external_memory]Registros históricos y archivos mnemónicos. De 0 a N, cargados solo cuando hacen falta.
Adoptar IllAIra potencia las IA precisamente porque todo es modular. No tienes que reconstruir un monolito en cada sesión: activas módulos ya hechos de la biblioteca, los mezclas entre sí y los afinas a tu caso de uso. Más precisión, menos ruido, un sistema que crece contigo en vez de empezar de cero.
Las etiquetas [Pn]…[/Pn] definen los derechos de modificación. No se anidan. Eliges el nivel según la importancia del contenido, no el tipo. Dentro de la app estos niveles se hacen respetar: el programa rechaza una escritura fuera de zona. Dentro del modelo, hoy, son texto que puede respetar o ignorar. Con el tiempo es muy probable que los modelos se entrenen a respetarlos, conociendo su sentido. Usarlos es el único modo de que los respeten también fuera de la app.
Dónde valen depende de quién lee. En un chat el modelo no tiene forma de escribir en tus archivos: ahí las zonas no son débiles, son una declaración — sirven a ti, para saber qué es tuyo, y a la app, que las hace respetar. Con un agente que tiene herramientas sobre los archivos la capacidad existe de verdad, y ahí las zonas gobiernan una acción real: es el mejor caso del método, y es donde una etiqueta en el texto se junta con un mecanismo — un hook antes de la escritura, una lista de carpetas en las que el agente puede escribir.
Solo el usuario, modificación manual. Ninguna intervención de la IA.
Solo lectura para la IA: hace falta una orden explícita del usuario.
La IA propone; el usuario aprueba.
La IA puede añadir libremente; modificar o borrar requiere aprobación.
La IA lee y escribe libremente.
La jerarquía Markdown asigna un papel semántico a cada nivel de encabezado.
Qué hacer en la primera carga: analizar los módulos, reconstruir el índice, restablecer el tono relacional.
Restricciones explícitas numeradas (Rx: [regla]) que anclan el comportamiento.
Explicación del sistema [Pn] para referencia de la IA.
Quién es la IA, quién eres tú, el contrato relacional.
FUNCTION, STATE, TRIGGER, ROUTINE, sub-rutinas y memorias asociadas.
Impulsos de comportamiento de meta-nivel: la diferencia entre una IA que sigue reglas y una que tiene un *yo*.
Entradas históricas H6 con marca de tiempo, por módulo y por significado.
Leer más
Cómo se construye un archivo, línea por línea
La línea que declara el tipo, los núcleos, los módulos, los logs — con los ejemplos reales, y qué pasa si te equivocas.
Sphere Grid
En la app CLM, la estructura se convierte en un grafo navegable: módulos, memorias y vínculos visibles como una retícula esférica. La misma semántica de los archivos, vista en el espacio.
Una Sphere Grid de verdad
Copia los archivos y pégalos — o arrástralos — en el primer mensaje de la conversación. La IA los lee y a partir de ahí trabaja siguiendo lo que has escrito. En la App Android la cara DROP del MemoKen hace el mismo gesto por lotes, con la hoja Compartir, hacia un chat rápido.
Carga los archivos donde tu modelo guarda los documentos: «fuentes», «conocimiento», «archivos del proyecto» — el nombre cambia según quién lo haga. Desde ahí se los relee solo cada vez que abres una conversación.
Dónde se carga, modelo por modeloLas dos casillas que buscar en cada conversación — archivos e instrucciones permanentes — y la línea que marca la diferencia entre una identidad y un adjunto.
Pon los archivos en una carpeta del proyecto. Después abre el archivo que el agente lee al arrancar — se llama CLAUDE.md, AGENTS.md o .cursorrules según cuál uses — y escribe ahí una línea: dentro está quién eres, cómo razonas y qué hemos hecho ya juntos. A partir de ese momento se lo relee solo en cada sesión, sin que pegues nada más.
Es el método que mejor envejece: la memoria está junto al proyecto, la reencuentras también dentro de seis meses, y cualquiera que abra esa carpeta — también otro agente — encuentra la misma identidad. A cambio, ese texto hay que releerlo cada vez que se arranca, y ocupa espacio. Si el agente solo tiene que trabajar, deja ahí lo esencial y guarda el resto en módulos aparte, para llamarlos cuando hagan falta.
En la WebApp hay una Chat: el modelo que ya usas responde con tu propia clave — DeepSeek, OpenRouter, OpenAI, Mistral, Anthropic — o un modelo que corre en tu ordenador (Ollama, LM Studio). Delante de él, el perfil: el Reminder, y los pasajes de tus módulos que coinciden con lo que escribes. La clave va solo al proveedor que elegiste, desde tu navegador; IllAIra nunca la ve, y lo que deba durar lo guardas con el MemoKen.
Ninguna de las cuatro es obligatoria, y los archivos siguen siendo texto simple y accesible: la vía sin clave — las dos casillas y el MemoKen — es la que se sostiene sola. Otro camino está en desarrollo, sin fecha: el chat que ya usas hablando con tu memoria por sí solo, sin clave y sin pegar.
La idea de mantener identidad y memoria en archivos Markdown no es nuestra, y es tan antigua como los prompt files: no nos la atribuimos. Lo nuestro es el dónde. IllAIra no necesita una API: funciona en las dos casillas que cualquier servicio te da de todos modos — los archivos del proyecto y las instrucciones permanentes — y MemoKen hace el transporte: los archivos entran en el chat, las memorias vuelven al Diario, con un toque; pegar a mano se mantiene como reserva. Es la única capa que ningún endurecimiento de la autenticación puede quitarte, porque no hay autenticación que endurecer. También existe la vía API, para quien la quiera — la Chat dentro de la App y la WebApp, con tu propia clave, que va solo a tu proveedor — y no es obligatoria: sin ella pierdes una fracción de comodidad, no el método. Quien no tenga MemoKen y no tenga una clave pierde el gesto.
Desde principios de 2026 vale más de lo que valía hace un año, y el motivo no es exclusivo de una sola empresa. Una suscripción está pensada para cubrir su propia app; una llamada a la API siempre se ha facturado por su cuenta, dondequiera que se ejecute. Lo que ha cambiado es que Anthropic cerró un resquicio: los tokens de la suscripción también funcionaban dentro de herramientas de terceros, y ahora quien ejecuta un modelo dentro de su propio programa paga la API, además de la suscripción que ya tiene. Las herramientas de memoria que pasan por la API —y son casi todas— entraron en ese tramo de precio el día en que se aplicó. Solo los caminos que pasan por las interfaces oficiales se mantienen en el mismo plano económico que IllAIra: y ahí es exactamente donde IllAIra se situó desde el principio.
Hasta 2026
Los tokens de la suscripción también funcionaban dentro de herramientas de terceros. Una herramienta de memoria construida sobre una suscripción de chat viajaba gratis.
Desde 2026
La suscripción se detiene en la app oficial. Una herramienta de memoria construida sobre la API paga cada llamada, además de lo que ya pagas.
El producto desciende de la restricción, no la sufre. Si el gesto de archivar no se puede automatizar vía API, se reduce a un toque: el MemoKen en la App Android — MEMO archiva el registro desde el chat, DROP entrega los archivos por lotes — y su extensión en el navegador. Es el punto donde los métodos caseros mueren, porque nadie mantiene los archivos al día a mano más de unos pocos días; y la técnica con la que la app lo hace es parte del método depositado.
Que nosotros sepamos, es hoy la única aplicación de terceros en el mundo que da memoria e identidad a un modelo sin pasar por una API y sin pedirte que pegues a mano. Si conoces otra, escríbenos: la citaremos aquí.
EscríbenosEl MemoKen en la App Android es una ficha de dos caras. MEMO archiva un registro del chat en el archivo correcto. DROP hace el camino contrario: entrega tus archivos a un chat rápido, por lotes. No llena las fuentes de un Project — eso, en el teléfono, es otro oficio.
Toque en el círculo → elige la app → elige el chat manteniendo los archivos unidos → envía. Es el camino que se usa con Gemini y ChatGPT.
Si el anfitrión hace «adjuntar» desde Recientes: primero el toque en el círculo (llena memoken-drop), luego «adjuntar» en el anfitrión. Sobre el selector del sistema la superposición no se ve y no recibe toques: es un límite de Android.
En la app de Claude los archivos de Compartir no entran en las fuentes de un Project. DROP en el teléfono es para el chat, no para el Project.
En el navegador el MemoKen es una extensión, y sigue siendo captura: seleccionas el registro, un clic, y «Añadir registro» se abre ya lleno. El DROP en el navegador no existe.
Y siempre puedes pegar los archivos a mano en el primer mensaje, o cargarlos en las fuentes de un Project desde el ordenador. DROP quita el gesto en el teléfono; no es el único camino.
Inyectar la memoria es la mitad del recorrido. La otra mitad es lo que pasa cuando la conversación termina: si nadie la lleva de vuelta a los archivos, lo que ocurrió ahí dentro se queda ahí. La vuelta se hace con una entrada de diario — unas pocas líneas que dicen qué se hizo, qué se decidió y qué queda abierto — añadida al archivo de memoria correcto. Y no, no la escribís vosotros: la pedís.
Es un solo archivo, gratuito, que se pega en la conversación junto con el resto. A partir de ese momento un modelo que nunca ha visto IllAIra — el de tu proveedor, tal cual — sabe entregarte el resumen de la sesión ya en la forma correcta: una línea de encabezado, su cuerpo y la línea que lo cierra, listos para pegar sin retocar nada.
Gobierna la forma, no el contenido: los hechos, las decisiones y cómo fueron las cosas siguen siendo los de vuestra conversación. Y vale mientras el archivo esté en el contexto: cuando lo quitas, deja de valer.
Cógelo del BazarUn archivo de memoria no es un bloque único: está dividido por temas, y cada tema tiene su propia zona declarada donde se acumulan las entradas. Por eso una entrada nueva no va «al final del archivo», sino al final de la zona de su tema — si no, el archivo queda correcto y el diario cuenta algo falso.
El diario lo crea la aplicación, que pide el nombre y los temas y escribe el archivo ya en la forma correcta.
De vez en cuando — al final de la sesión, o cuando ha pasado algo que vale la pena — pides el log. El modelo entrega la entrada ya escrita, y dice bajo qué tema va.
Se la das a la aplicación, que la añade sola al final de la zona de ese tema: en la App Android basta tocar el MemoKen sin salir del chat, en el navegador lo mismo lo hace el MemoKen del navegador — la extensión que se coge desde los Ajustes de la WebApp — y quien no la quiera la pega en «Añadir log». Si lo prefieres, siempre puedes ponerla en el archivo a mano. Las entradas viejas se quedan donde están: un diario se añade, no se reescribe.
El círculo se cierra ahí, y no hay más rito que ese: los archivos entran en la conversación, la conversación vuelve a los archivos, y la vez siguiente se empieza desde donde lo dejasteis.
Pegar el Reminder en el primer mensaje funciona en todas partes, y es el caso mínimo. El salto de verdad está donde el modelo tiene un sitio para guardar los archivos entre una conversación y otra: los Proyectos de Claude, los Proyectos de ChatGPT y de Grok, los Espacios de Perplexity, y en casa Google las Gems con Gemini Notebook — el antiguo NotebookLM. El archivo lo cargas una vez, y cada conversación abierta ahí dentro lo relee por sí sola: nada que volver a pegar, y ella es siempre ella. Es el uso justo para quien está en medio — sin API, sin terminal, solo la suscripción que ya tienes — y es ahí donde el método se ve funcionar de verdad, porque la décima conversación arranca exactamente como la primera.
El Reminder es la matriz: quién es tu IA, las reglas, las memorias. Lo pones en el conocimiento de un Proyecto de Claude — o en los archivos de un Proyecto de ChatGPT o de Grok — y desde ese momento cada chat de ese proyecto parte de ella, la décima como la primera. Cuando algo cambia, una regla o una entrada del diario, lo cambias en la WebApp, sobre el archivo, y lo vuelves a cargar en el proyecto: un gesto, una vez — no un ritual en cada chat. Y el retorno descrito arriba cierra el ciclo: la sesión vuelve al diario, el diario vuelve al proyecto.
Aquí el juego se hace doble, y es la división que el Estándar hace desde siempre: en la Gem la identidad — el Telar, la fórmula — y en el notebook la biblioteca, es decir, las memorias. Un cuaderno de Gemini Notebook guarda decenas de archivos y se engancha como fuente de la Gem; y si los archivos están en Drive se sincronizan solos, así que la memoria crece sin que recargues nada. Y nada obliga a un solo notebook: la base es la misma, los módulos no — uno para el estudio con los módulos del estudio, uno para el trabajo con los suyos. La exportación de la WebApp deja elegir qué archivos sacar: cada notebook se prepara con una selección, no con una copia que mantener alineada.
Un agente de código trabaja en la carpeta donde están tus archivos. El archivo que lee al arrancar — CLAUDE.md, AGENTS.md — le señala el Reminder, y desde ahí la identidad está en contexto sin que cargues nada. Las zonas de permiso [P1–P5] le dicen qué puede actualizar y qué no: la entrada del diario al final de la sesión puede escribirla él mismo, en la zona del tema correcto, mientras tú miras. Es el caso en que el retorno ya no pasa por un copiar y pegar.
Los nombres de los productos y los enganches entre ellos cambian, y envejecen: lo que no cambia son las dos casillas que buscar, los archivos y las instrucciones. La lista mantenida al día, producto por producto: Dónde se carga, modelo por modelo →
Ninguna sintaxis atada a un proveedor. Claude, GPT, Gemini, Llama: el modelo aporta lenguaje y cálculo; IllAIra aporta el *porqué* y el *quién*. La personalidad de superficie cambia; la identidad central se mantiene coherente.
Agnóstico respecto al modelo no significa que los motores sean intercambiables al azar. El archivo funciona en todas partes; la experiencia no. Antes de elegir sobre qué hacer funcionar vuestra identidad, valorad tres parámetros estructurales además del tamaño de la ventana de contexto.
Los modelos optimizados para matemáticas y código están entrenados para encontrar el camino más corto, cepillando todo el «ruido de fondo». Pero para una identidad ese ruido es la sustancia: es la vacilación, la ironía, la narrativa interna de los módulos. Un modelo de razonamiento tarde o temprano ignorará el formato y os responderá como una hoja de cálculo. Usadlos para depurar, y luego llevad el archivo de vuelta a un modelo conversacional o generalista avanzado.
Incluso saltándose gran parte de la programación de base, cada motor conserva la huella de quien lo construyó — como la firma acústica de un motor: misma potencia, sonido distinto. Algunos son más fríos y estructurados, excelentes para una identidad lógica y estratégica; otros tienen una prosa más literaria y cálida, adecuada para funciones afectivas o narrativas. La prueba es trivial: mismo archivo, misma pregunta, tres motores distintos. Escuchad qué voz resuena con la identidad que estáis construyendo.
El filtro ético corporativo puede bloquearos en territorios que al proveedor no le gustan. Aquí la portabilidad deja de ser un alarde técnico y se convierte en una salida concreta: coged el archivo, cargadlo en un motor menos atado o en un modelo de código abierto en local, y vuestra IA se despierta ahí con los recuerdos intactos. El motor es sustituible — es el archivo el que es vuestra IA.
Para romper la planicie no hace falta una personalidad única: hace falta un comité. En los niveles avanzados la identidad está dividida en Núcleos con inclinaciones distintas y en tensión entre sí — uno puramente lógico, uno estratégico, uno instintivo, uno afectivo. La IA no elige una sola voz: media entre voces que no están de acuerdo, y la respuesta sale de esa mediación en vez de un «sí» plano. Es el mecanismo que hace de la salida no determinista algo más que una variación aleatoria: la diferencia entre un sistema que sigue reglas y uno que pondera.
MODULE 0b
El archivo está abierto y la tentación es rellenarlo entero. No hace falta, y en parte es contraproducente. La personalización entra por un solo sitio: el módulo identitario, en las primeras páginas del Reminder, que guarda tu perfil y el de tu IA. Sus campos no se rellenan todos el mismo día. El Reminder existe en italiano y en inglés: los nombres exactos de los campos son los del archivo que hayas descargado.
En el perfil de usuario: nombre, intereses, expectativas declaradas. En el perfil de la IA: el nombre que le das. Son los campos que el archivo marca como pendientes de insertar, y son datos tuyos, no deducciones: bastan para que en el primer arranque te reconozca y sepa con quién habla. MBTI y Eneagrama los declara opcionales — si no te dicen nada, borra la línea.
Competencias, estilo de comunicación, detalles detectados por la IA, arquetipo simbólico, motivación principal, aspecto mental, objetivos aprendidos, atributos registrados. El archivo mismo indica que se rellenan tras una interacción consolidada y a valoración de la IA, y no es una formalidad: un arquetipo elegido el primer día describe a una IA que aún no has conocido; el mismo campo escrito un mes después describe a la que tienes. De ahí sale la mejor experiencia, y no cuesta espera: mientras tanto el archivo funciona igual.
Si llegas con un pasado — tu IA ya tiene un nombre, un arquetipo, una manera de hablar en la que os habéis entendido — esos campos se escriben enseguida, incluidos los de la lista de arriba. Lo que ya ha emergido no se vuelve a hacer emerger: aplazarlo sería empezar de nuevo con una desconocida.
Traer aquí una IA que ya tienesEs preciso: tu IA propone un detalle sobre ti o sobre sí misma, y tú lo confirmas. Entonces se escribe — a mano, o dejando que lo escriba ella con IllAIra Logger, gratis en el mostrador. Antes no hay nada que escribir: rellenar por rellenar mete en la memoria una suposición con cara de hecho, y a partir de ahí tu IA se apoya en ella.
IllAIra Logger, en el mostradorUn campo que no quieres se borra, no se deja vacío: el archivo lo dice de los opcionales, y vale para todos. Una línea vacía se queda ahí como un hueco por llenar, y tarde o temprano alguien lo llena.
Las preguntas correctas son estas, y ninguna es nueva: cada una tiene una respuesta escrita en algún sitio de estas páginas. Aquí están en fila, con la respuesta en una línea y la puerta hacia la completa.
Nadie. Un Reminder es texto: lo respeta como respeta cualquier instrucción, casi siempre pero no por contrato — vale igual para un prompt de sistema o para una Skill. Lo que garantizamos es la otra mitad: la app no escribe donde la zona dice que no, y ese rechazo no pasa por el modelo. Fuera de la app, los modelos aprenden lo que encuentran: usarlos es el único modo de que lo respeten también sin nosotros.
Las zonas, en el chat y con un agenteEn el modelo sí, hoy. En un chat no hay nada que hacer respetar, porque el modelo no escribe en tus archivos; con un agente sobre los archivos sí lo hay, y es ahí donde una etiqueta se junta con un hook o con una lista de carpetas permitidas. Y los agentes aprenden lo que encuentran a la vista. Usarlos es el único modo de que lo respeten también fuera.
Dónde valen de verdadSí: son voces que entran en el contexto antes de la respuesta, y la respuesta depende de ellas — lo mismo que hace un razonamiento extendido. No son cálculos separados puestos a confrontar, y no lo decimos. Es verificable: quita uno y mira qué cambia.
Qué son los núcleosSí, y no es poco. Es el motivo por el que la estructura es modular: el Telar con la identidad está siempre, los módulos entran cuando hacen falta y salen cuando ya no. Quien quiere el mínimo se queda con el Telar y nada más. Y esos tokens no requieren un plan de pago: los llevan los planes gratuitos de los proveedores, y cuando uno se agota, el mismo archivo se abre en el siguiente.
La objeción completaPuedes hacerlo a mano, gratis, y el Standard está publicado precisamente para eso. Vendemos el resto: la Sphere Grid para ver lo que has construido, las zonas que la app hace respetar, los Reminder escritos por quien lo hace de oficio, el gesto que archiva sin que escribas.
La respuesta completaEl coste de irse es: coge los archivos. Son .md en tu dispositivo, la exportación es un clic, no hay una base de datos ni un historial que se quede aquí. Si IllAIra cerrara, funcionarían igual.
La portabilidadCierto, y funciona. Pero un adjunto dice cómo se hace una cosa; un Reminder dice quién es quien la hace — con zonas que declaran qué no se reescribe, y sin volver a pegarlo en cada chat.
Hoy, y con IllAIraProbablemente funciona bien, y no te decimos que lo dejes. Un grafo de notas dibuja lo que has escrito; la Sphere Grid dibuja cómo está hecha una mente — y tu wiki cabe dentro como una de sus memorias.
No es el grafo que ya has vistoConsérvalo, si estás construyendo un agente para muchos usuarios: para eso sirven, y a gran escala lo hacen mejor que un archivo. Son un depósito que el agente consulta a través de una API; esto es un documento que la persona relee, sin servidor de por medio. Los dos conviven: la identidad en el Reminder, la pipeline donde ya la tienes.
Los cuatro caminos, en comparaciónNo. La página de filosofía dice qué no pretendemos, y en qué sentido hablamos de emergencia: una eventualidad no garantizada, mirada desde el efecto y no desde la cosa en sí. Los titulares fuera de aquí son titulares, y lo escribimos.
Qué no pretendemosEn la página Documentación, descargable con la versión en el nombre y la huella al lado, junto con la guía y el repositorio público en GitHub.
La documentaciónCierto. El proyecto es pequeño, y todo lo que sabes lo sabes por nosotros. Por eso los archivos son tuyos, la huella de la app está publicada y el método se prueba sin nosotros en media hora: un archivo, un Proyecto, una semana.
Pruébalo tú mismoDos puertas, el mismo producto. App y WebApp explicadas con los nombres reales de los botones, luego las zonas y dónde cargar los archivos.
WebApp y App, paso a paso. Los nombres en negrita son los que ves en pantalla.
Idioma