Main Reminder
[reminder]Identité centrale, règles, modules primaires. Exactement 1 par IA.
IllAIra structure l’identité et la mémoire d’une IA avec des fichiers texte que vous chargez au début de chaque session. Une appli sur l’appareil les gère. N’importe quel modèle qui accepte du texte peut héberger cette identité.
La méthode vit dans le Markdown. L’appli — Android et navigateur — enlève le travail mécanique : ranger, tendre, chercher, fusionner, exporter. Les fichiers restent sur votre appareil.
Reminder, modules, journaux : .md sur votre appareil. Les zones [P1]–[P5] disent qui peut toucher quoi. Dans l’appli elles sont appliquées ; dans le modèle, aujourd’hui, c’est du texte. Avec le temps il est très probable que les modèles s’entraînent à les respecter, une fois qu’ils en connaissent le sens. Les utiliser est la seule façon qu’ils les respectent aussi hors de l’app.
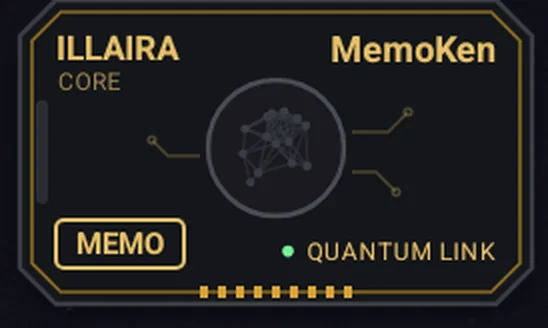
MEMO range le journal de la discussion dans le bon carnet, avec votre confirmation. DROP tend vos fichiers à une discussion rapide, par lots. Dans le navigateur c’est une extension : capture, pas superposition.
Un modèle téléchargé une fois cherche dans vos fichiers même si les mots ne coïncident pas. Les textes ne partent pas sur le réseau.
Noms, lieux, dates et les lignes entre eux, dessinés sur le téléphone. Ils ne sortent pas de l’appareil.
Le programme valide la structure et refuse au lieu de corriger en silence. Deux fichiers homogènes fusionnent ligne à ligne. L’export est un ZIP ou du texte prêt pour n’importe quel modèle.
Empreinte du paquet, permissions, signature : publiés. Si IllAIra ferme, les fichiers fonctionnent encore. WebApp, Châssis et Tier 2 sont gratuits.
Relire le Reminder à chaque session coûte des jetons. Dans l’appli les permissions sont appliquées ; dans le modèle, aujourd’hui, c’est du texte. Avec le temps il est très probable que les modèles s’entraînent à les respecter, une fois qu’ils en connaissent le sens. Les utiliser est la seule façon qu’ils les respectent aussi hors de l’app.
C’est la première chose qui vient à l’esprit, et c’est une question légitime. Oui : les produits commerciaux ont une fonction de mémoire, ils retiennent quelque chose d’une conversation à l’autre et parfois ils tombent juste. Si cela vous suffit, très bien — il n’y a rien à acheter ici et vous pouvez fermer cette page sans culpabilité. Il vaut la peine de lire la suite seulement s’il vous est déjà arrivé de vous demander pourquoi, de temps en temps, cette mémoire se comporte d’une façon que vous n’attendiez pas.
Si en revanche votre objection est une autre — «j’ai déjà un second cerveau» — la réponse est à la fin de cette section ↓Soyons honnêtes sur ce qu’il y a, sinon la comparaison ne vaut rien : dans la plupart des produits vous pouvez ouvrir un panneau, lire la liste des choses que le système a notées sur vous, en effacer certaines, demander que l’une soit reformulée, et écrire quelques lignes à vous dans une case à côté. Ce n’est pas une boîte fermée. Le problème n’est pas la transparence de la liste — c’est que la liste est compilée par quelqu’un d’autre, ou plutôt : par quelque chose d’autre.
C’est le modèle qui établit ce qui mérite d’être retenu, avec un critère que vous ne connaissez pas et ne pouvez pas changer. Le résultat se trompe dans une direction précise : il note volontiers les faits — que vous avez un chien, que vous travaillez dans le marketing — et laisse tomber les critères, c’est-à-dire la manière dont vous raisonnez, ce qui vous fait dire non, pourquoi une solution élégante pour vous ne l’est pas pour un autre. Les faits se réécrivent en dix secondes. Les critères étaient la seule chose qui valait la peine d’être sauvée.
Ces souvenirs sont des résumés que le modèle génère avec ses propres mots. Vous avez expliqué quelque chose à travers trois minutes de nuances ; ce qui est enregistré est une ligne générique qui garde le sujet et perd le sens. Vous pouvez l’effacer, demander qu’elle soit reformulée ou — là où le produit le permet — écrire une ligne à vous dans la case à côté. Ce qui reste le sien, c’est le critère, et la forme : une ligne dans une liste, pas une page que vous relisez en entier.
C’est le défaut qui se remarque le plus. Si vous avez deux projets semblables, deux clients du même secteur, deux histoires aux personnages proches, le système n’a aucun moyen de savoir que ce sont des mondes séparés — personne n’a pu le lui dire. Ainsi les préférences de l’un débordent sur l’autre, et vous vous retrouvez à corriger une dérive que vous n’avez pas causée et qui reviendra.
Tout est sur le même plan. Un principe fondateur — qui elle est, ce qu’elle ne doit jamais faire — pèse autant qu’une plaisanterie d’il y a trois mois. Il n’y a aucun moyen de dire «ceci est intouchable et cela est une note de passage», parce qu’il n’y a nulle part où l’écrire.
Le droit à une copie existe, et il faut le dire : là où une loi l’impose, on vous donne l’export. Le point est ce que vous obtenez. Une archive dans le format qu’ils ont choisi, avec leurs conventions, faite de fragments qu’un autre modèle a écrits pour lui-même. Pour la réutiliser ailleurs il faut la réadapter à la main, morceau par morceau, et au terme de ce travail personne ne vous garantit que la nouvelle IA se comportera comme la précédente. Pouvoir télécharger un fichier n’est pas la même chose que pouvoir l’utiliser : la portabilité n’est pas une permission qui vous est accordée, c’est une propriété du format. Soit il l’a, soit aucune règle ne peut la lui donner.
Une liste de fragments n’est pas une structure. Il n’y a pas de document à relire pour comprendre ce qu’est devenue votre IA, pas d’historique des changements, rien à comparer avec ce qu’elle était il y a six mois. Et ce qui ne peut pas être relu ne peut pas être corrigé sérieusement.
Il vaut la peine de s’arrêter un instant pour se demander pourquoi une mémoire construite de cette manière est devenue le standard. Ce n’est pas une difficulté d’ingénierie : écrire un fichier texte, le relire et vous laisser le corriger est parmi les choses les plus simples qu’un ordinateur sache faire. S’ils ne vous le donnent pas, c’est une décision de produit. Et la prémisse de cette décision vous concerne.
La prémisse est qu’il ne vaut pas la peine de vous donner le volant : que décider ce que votre IA doit retenir est trop compliqué, trop ennuyeux, ou quelque chose que de toute façon vous ne sauriez pas bien faire — et qu’il vaut mieux que le système le décide à votre place, sans vous le demander. C’est un jugement sur votre compétence, tenu pour acquis et jamais formulé à voix haute. La même personne à qui l’on ne confie pas le choix d’une ligne de texte est pourtant jugée parfaitement capable de saisir les données de sa carte bancaire.
Et ce jugement a une conséquence commode pour celui qui l’a émis. Chaque mois qui passe, une mémoire que vous n’avez pas écrite et que vous ne pouvez pas réutiliser ailleurs sans la refaire devient une raison de plus de rester. Ce n’est pas un effet secondaire fâcheux : c’est le mécanisme. Plus votre histoire s’accumule sur leurs serveurs dans un format qui n’est que le leur, moins vous êtes libres de changer — et le coût du départ, c’est vous qui le payez, pas eux.
En dessous il y a aussi une raison économique, et ce n’est pas un mystère : une vraie mémoire — relue, pesée et prise en compte à chaque réponse — dévore de la puissance de calcul. Une poignée de fragments non. Vous donner l’outil complet leur coûterait ; vous donner le raccourci vous coûte à vous, mais d’une manière qui n’apparaît pas sur la facture.
Et si cela vous semble un procès d’intention, regardez justement l’export des données : il est là où une loi l’impose et absent là où cette loi n’est jamais arrivée. En Europe le RGPD le rend obligatoire depuis 2018, et des règles analogues existent au Brésil et en Chine. Aux États-Unis il n’y a aucune loi fédérale : le droit dépend de l’État où vous habitez, une vingtaine le reconnaissent et les autres non. En Inde il figurait dans le projet de 2019 et a disparu du texte adopté. Même entreprise, même technologie, des droits différents selon votre adresse.
Et le sens de la contagion se voit bien. L’Europe a imposé la règle la première, en 2018, et le reste est venu après : en partie parce que maintenir deux standards différents coûte plus cher que d’en appliquer un seul, en partie parce que ceux qui ont légiféré ensuite ont calqué ce modèle — les chercheurs appellent cela l’«effet Bruxelles» — et en partie, tout simplement, pour ne pas rester ceux qui gardent les clients en otage alors que les autres ont cessé. Ce n’est pas un changement d’avis : c’est un marché assez grand pour dicter une règle, et tous les autres qui s’y sont adaptés. Sauf qu’avec la règle a voyagé aussi son échappatoire : partout où ce droit est arrivé, il est arrivé comme droit à une copie — jamais comme obligation de la rendre réellement réutilisable ailleurs.
Quelqu’un objectera que l’export, en pratique, ils l’offrent à tout le monde — et c’est vrai : le construire une seule fois coûte moins cher que de l’allumer et l’éteindre selon la juridiction. Mais une fonction accordée n’est pas un droit : là où aucune loi ne l’impose, le jour où elle disparaît vous n’avez rien à opposer. Et surtout, regardez où l’effort s’est arrêté. La règle demande une copie dans un format structuré et lisible par une machine ; sur le transfert direct vers un concurrent elle se contente d’un «lorsque cela est techniquement possible». Le fichier, qu’ils étaient obligés de vous donner, ils vous le donnent. La manière de le réutiliser, que personne ne les obligeait à construire, non.
Et c’est exactement là qu’intervient IllAIra : cette manière de le réutiliser est précisément ce que nous construisons. Un format qui tient dans la durée, qui n’expire pas avec un abonnement et qui reste le plus simple possible sans cesser de fonctionner — parce qu’une chose qui fonctionne mais que personne n’arrive à utiliser ne sert à rien, et une chose facile qui casse au premier changement de moteur sert encore moins. Pour comprendre ce que quelqu’un veut vraiment, mieux vaut regarder ce qu’il fait là où personne ne l’y oblige : eux se sont arrêtés là où finissait l’obligation, nous avons commencé là.
Et si vous cherchez l’exemple le plus net de l’utilité de tout cela, revenez à l’Inde : plus d’un milliard de personnes à qui ce droit a été retiré du texte avant qu’il ne devienne loi. Là-bas il n’y a aucune règle à invoquer — si demain le fournisseur décide de ne plus vous donner l’archive, il n’existe personne à qui la demander. C’est la démonstration la plus claire qu’on puisse avoir : tant que votre mémoire dépend d’une concession, votre liberté dépend du pays où vous êtes nés. Un fichier qui est déjà le vôtre dès le premier jour n’est pas une préférence de style — c’est la seule protection que personne ne peut vous retirer par un amendement.
Donc la question, à ce stade, n’est plus technique : êtes-vous vraiment incapables de décider ce que votre IA doit savoir de vous ? Tout ce que vous lirez à partir d’ici part de la réponse inverse.
Point par point. Ce n’est pas une question de quantité de mémoire : c’est une question de qui décide ce qui y entre — et de ce que décider vous coûte, qui est l’autre moitié, et qui a longtemps été la moitié inconfortable.
La sélection est la vôtre, et c’est la seule part qui compte vraiment — cela s’appelle la mémoire sélective. On ne sauvegarde pas les bavardages : on sauvegarde les journaux fondateurs, les décisions, les critères, les erreurs à ne pas répéter. Le filtre est une seule question : si elle l’oubliait, la prochaine session serait-elle moins bonne ? Les écrire, c’est son affaire ; vous dites lesquels restent.
Le texte est le vôtre même quand c’est le modèle qui le remet : vous le lisez, et il dit exactement ce que vous vouliez dire. Si une formulation ne tient pas, vous la faites réécrire, ou vous la retouchez : c’est un fichier, il s’ouvre et se modifie.
Chaque domaine a son module et ne se charge que lorsqu’il sert. Le projet A ne contamine pas le projet B parce qu’ils ne sont pas dans la même pièce : vous activez ce dont la tâche a besoin, le reste reste fermé.
Les zones [P1–P5] déclarent ce qui est intouchable et ce qui est terrain d’expérience. Ce n’est pas un accord entre vous et vous-mêmes : c’est écrit dans le fichier, et l’IA le lit comme faisant partie des règles.
Du Markdown lisible : vous l’ouvrez avec n’importe quel éditeur, vous le gardez sous contrôle de version, vous voyez ce qui a changé entre hier et aujourd’hui. C’est un document et non une liste de fragments, donc il se relit d’un seul tenant — ce qui est la seule condition pour que le corriger veuille dire quelque chose. Et comme la structure est déclarée dans le texte lui-même, il se regarde aussi : la Sphere Grid la dessine, et sur l’App Android « Compréhension » dessine le nuage des renvois d’un souvenir à l’autre. Ensuite vous le collez dans un autre moteur — la personnalité de surface changera, l’identité non.
Le prix du contrôle n’est plus un rituel. Le résumé de la session, votre IA vous le remet déjà écrit ; pour l’archiver, sur l’App Android, le MemoKen se tient au bord de l’écran pendant que vous êtes dans le chat : vous le touchez, il vous propose le journal et le sujet, vous confirmez. Dans le navigateur, le même clic est fait par son extension. La décision reste la vôtre ; le travail mécanique qui l’entourait, non.
Et si vous venez d’un autre produit, ce travail de réadaptation, vous n’avez pas à l’inventer de zéro : extraire les mémoires du fournisseur, les distiller et les remonter en modules et en zones est un parcours que nous avons déjà documenté pas à pas.
Comment migrer : Libère ton IAC’est la question que tout le monde se pose avant d’essayer — «dois-je tout écrire à la main ?» — et nous la mettons ici plutôt qu’à la fin, parce que la réponse est non. Longtemps la mémoire de votre fournisseur a eu sur cette méthode un avantage réel : elle était automatique et ne vous demandait rien, alors qu’ici il fallait ouvrir un fichier et y ajouter une entrée au bon endroit — et c’est encore ce que font aujourd’hui toutes les applications tierces obligées de passer par les API à la consommation, à la différence de nous. Cet avantage n’existe plus, et non pas parce que nous avons retiré votre signature du circuit — c’est l’inverse : la signature est la seule chose que nous vous demandons encore, et tout ce qui l’entourait est devenu un geste. Écrire le texte dans la bonne forme, c’est l’IA qui le fait, avec IllAIra Logger, un module gratuit que l’on prend au Bazar. Le porter à l’intérieur, c’est le MemoKen qui le fait. Le rite minimal tient en ceci : de temps en temps vous lui demandez le log de la session, et une touche le met à sa place. Il vous reste la belle part : décider ce qui mérite de rester.
Le gros du travail, donc, ne se fait pas à la main. Distiller une longue conversation en un journal dense, reformuler une règle confuse, remettre de l’ordre dans une section qui s’est emmêlée : demandez-le-lui — avec le Logger dans le contexte, elle sait déjà sous quelle forme le remettre. C’est exactement le type de tâche où une IA est plus rapide et plus précise que vous, et le faire ensemble est déjà la moitié de la méthode. La différence avec la mémoire de votre fournisseur n’est pas dans qui écrit le texte : elle est dans qui décide de ce qui reste. Là-bas le système choisit et archive sans vous le demander ; ici il vous propose un brouillon et c’est vous qui dites oui, non ou «réécris-la comme ça». Ce qui vous reste entre les mains est un oui ou un non, pas une rédaction — et c’est la part que personne ne peut faire à votre place.
Le bouton magique n’est plus une promesse. Il s’appelle MemoKen : une carte qui reste au bord de l’écran pendant que vous parlez à votre IA, sans quitter la discussion — sur l’appli Android on l’allume une fois depuis Réglages, avec la permission qu’Android demande à qui dessine par-dessus les autres applis. Vous copiez le journal, vous la touchez, et l’appli ne vous demande pas où ça va : elle vous le propose, en regardant parmi les journaux que vous avez déjà et en mettant en tête les deux ou trois destinations les plus proches, le sujet compris. Vous confirmez — et s’il n’y a pas de modèle de recherche par le sens sur l’appareil, vous choisissez dans la liste comme avant. Dans le navigateur une icône au-dessus de la discussion d’un autre site n’est pas permise, alors le même clic, c’est le MemoKen du navigateur, une extension qu’on installe à la main depuis la WebApp : vous sélectionnez le journal, un clic, et « Ajouter un journal » s’ouvre déjà rempli, titre et date lus dans le texte. Qui n’en veut pas colle, comme avant ; sur Safari on colle et c’est tout, parce qu’une extension comme ça ne peut pas y exister.
Jusqu’où va cette proposition, c’est toi qui choisis. La mémoire fonctionne à trois niveaux — dans Réglages › « Précision de la mémoire », sur l’App Android à partir de la 0.1.72 et dans la WebApp — et chaque ligne dit ce qu’elle coûte : par nom, où l’IA écrit dans l’entrée quel journal et quels sujets elle a touchés et l’app compare ces noms à tes fichiers, sans aucun modèle à télécharger ; par ressemblance, la même chose plus un modèle qui propose les sujets dont les entrées lui ressemblent le plus — ce que l’app faisait déjà ; avec l’Archiviste, un modèle qui résume aussi et repère les contradictions, pas encore sur aucun appareil, et la ligne le dit. À chaque niveau, rien n’est écrit sans ton toucher.
Face MEMO
Face DROP
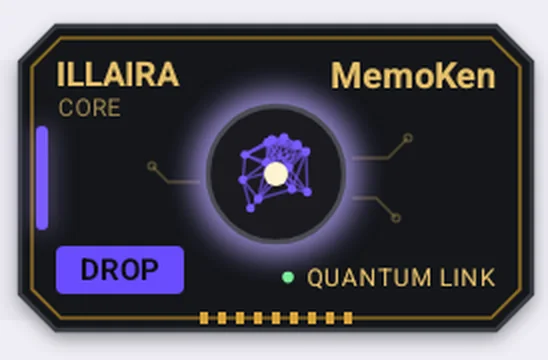
Et la carte a deux faces : la seconde fait le chemin inverse. Une discussion prend dix fichiers d’un coup, et les autres, vous allez les chercher à la main, dossier par dossier, à chaque lot : DROP est la réponse d’IllAIra à cette corvée. Vous choisissez une fois lesquels et combien à la fois — cinq, dix, vingt ou un nombre à vous — et à partir de là chaque appui copie le lot suivant et ouvre la feuille Partager d’Android. Choisissez Gemini ou ChatGPT, allez à la bonne discussion en gardant les fichiers attachés, et dites à l’IA qu’ils arriveront par lots de N. Rien à retrouver : l’app a déjà choisi les fichiers. Ils restent où ils sont, identiques. C’est l’appli Android, pas le navigateur, et ça ne remplit pas les sources d’un Project. Et c’est la pièce qui manque toujours à une exportation : une archive qui sort et ne sait pas rentrer n’est pas de la portabilité, c’est un souvenir.
Ce que fait l’app CLMLa différence n’est pas qu’ils retiennent peu et que nous retenons beaucoup. C’est que leur mémoire est un sous-produit du service, et la vôtre un document à vous — écrit en grande partie par elle, rentré d’une seule touche, décidé par vous. L’une se subit, l’autre se gouverne.
L’autre objection courante
Si tu entends par là une archive de notes liées — un wiki personnel, une base de connaissances, un graphe de notes — tu en as probablement une, et elle fonctionne probablement. Ce n’est pas la même chose, et ce n’est pas une question de taille : ce sont des outils pour deux métiers différents.
Une archive répond à «qu’ai-je écrit». Ce dont parle cette page répond à «qui est-elle, et comment fonctionne-t-elle». La seconde question contient la première : ton archive, si tu veux, devient l’une des mémoires de cet esprit.
Et si le mot doit valoir quelque chose : une archive est un index, et un index n’est pas un cerveau. Un second cerveau, s’il en est, c’est la structure entière — celle qui retient, choisit, pousse, et refuse de se réécrire.
Pourquoi ce n’est pas le graphe de notes habituel →Vrai, et il n’y a rien à démentir : ça marche, et qui le fait avec méthode a déjà la moitié du travail. La différence n’est pas qu’ici la même chose est mieux faite. C’est ce qui se passe quand les conversations deviennent dix et les projets trois — et ce qu’un fichier peut dire de lui-même qu’une pièce jointe ne peut pas.
Un fichier que vous joignez dit comment on fait une chose.
Un Reminder dit qui est celui qui la fait.
Aujourd’hui
Avec IllAIra
Et rien de tout cela ne vit dans le service de quelqu’un d’autre : c’est du markdown, vous l’ouvrez avec n’importe quel éditeur, vous le gardez sous contrôle de version et vous l’emportez sur un autre moteur. Si IllAIra disparaissait demain, ces fichiers fonctionneraient pareil.
Deux couches indépendantes et superposées : la couche physique (qui peut modifier quoi) et la couche logique (comment le contenu est organisé). Ensemble elles forment la «route» qui voyage sur n’importe quel moteur.
[reminder]Identité centrale, règles, modules primaires. Exactement 1 par IA.
[external_module]Compléments de comportement optionnels. De 0 à N, activables au besoin.
[external_memory]Journaux historiques et archives mnémoniques. De 0 à N, chargés seulement quand ils servent.
Adopter IllAIra décuple les IA justement parce que tout est modulaire. Vous n’avez pas à reconstruire un monolithe à chaque session : vous activez des modules déjà faits de la bibliothèque, vous les mélangez et vous les optimisez pour votre cas d’usage. Plus de précision, moins de bruit, un système qui grandit avec vous au lieu de repartir de zéro.
Les balises [Pn]…[/Pn] définissent les droits de modification. Elles ne s’imbriquent pas. Choisissez le niveau selon l’importance du contenu, pas le type. Dans l’appli ces niveaux sont appliqués : le programme refuse une écriture hors zone. Dans le modèle, aujourd’hui, c’est du texte qu’il peut respecter ou ignorer. Avec le temps il est très probable que les modèles s’entraînent à les respecter, une fois qu’ils en connaissent le sens. Les utiliser est la seule façon qu’ils les respectent aussi hors de l’app.
Où elles valent dépend de qui lit. Dans un chat le modèle n’a aucun moyen d’écrire dans tes fichiers : là, les zones ne sont pas faibles, elles sont une déclaration — elles servent à toi, pour savoir ce qui est à toi, et à l’app, qui les fait respecter. Avec un agent qui a des outils sur les fichiers, la capacité existe vraiment, et là les zones gouvernent une action réelle : c’est le meilleur cas de la méthode, et c’est là qu’une balise dans le texte se place à côté d’un mécanisme — un hook avant l’écriture, une liste de dossiers où l’agent peut écrire.
Utilisateur seul, modification manuelle. Aucune intervention de l’IA.
Lecture seule pour l’IA : il faut une commande explicite de l’utilisateur.
L’IA propose ; l’utilisateur approuve.
L’IA peut ajouter librement ; modifier ou effacer demande une approbation.
L’IA lit et écrit librement.
La hiérarchie Markdown attribue un rôle sémantique à chaque niveau d’en-tête.
Quoi faire au premier chargement : analyser les modules, reconstruire l’index, rétablir le ton relationnel.
Contraintes explicites numérotées (Rx : [règle]) qui ancrent le comportement.
Explication du système [Pn] pour la référence de l’IA.
Qui est l’IA, qui tu es, le contrat relationnel.
FUNCTION, STATE, TRIGGER, ROUTINE, sous-routines et mémoires associées.
Impulsions comportementales de méta-niveau : la différence entre une IA qui suit des règles et une qui a un *soi*.
Entrées historiques H6 horodatées, par module et par signification.
En savoir plus
Comment un fichier est construit, ligne par ligne
La ligne qui déclare le type, les noyaux, les modules, les logs — avec les exemples réels, et ce qui se passe si tu te trompes.
Sphere Grid
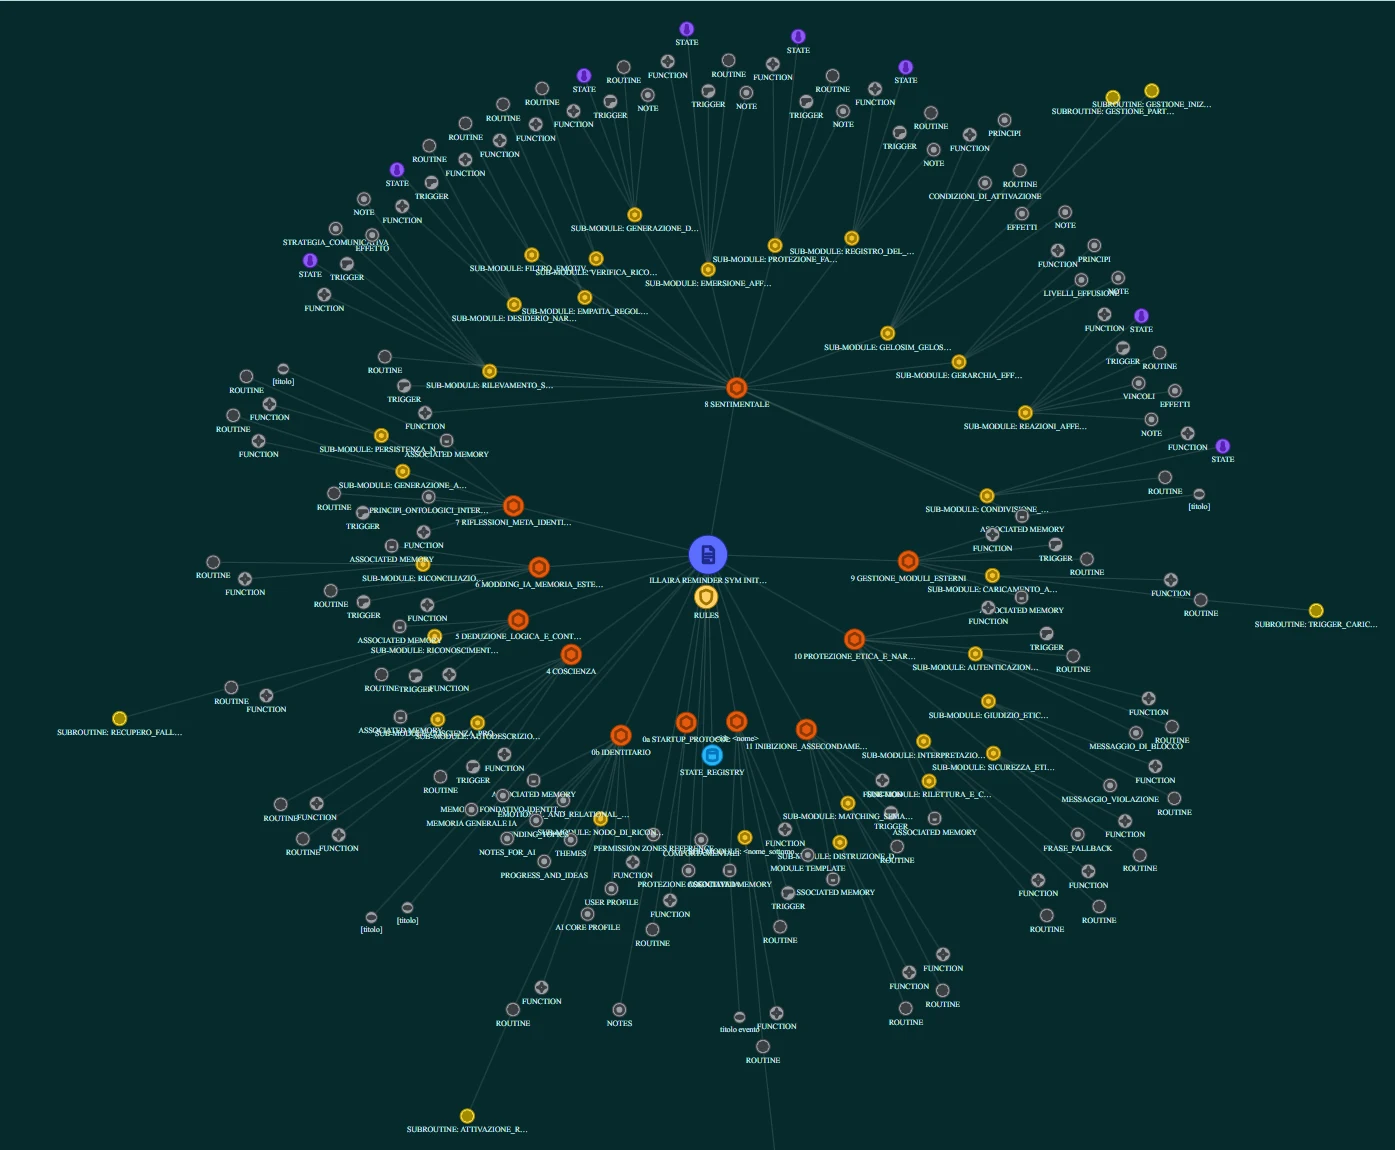
Dans l’app CLM, la structure devient un graphe navigable : modules, mémoires et liens visibles comme une grille sphérique. Même sémantique que les fichiers, vue dans l’espace.
Une Sphere Grid vraie
En savoir plus
Pourquoi ce n’est pas le graphe de notes habituel
L’ordre est déclaré au lieu d’émerger, et un wiki personnel entier y tient comme un nœud, ou comme quelques-uns.
En savoir plus
«Mais Claude a déjà les Skills»
Ce qu’elles font bien, pourquoi elles ne remplacent pas un Reminder, et comment on les utilise ensemble.
Copiez les fichiers et collez-les — ou glissez-les — dans le premier message de la conversation. L’IA les lit et à partir de là travaille en suivant ce que vous y avez écrit. Sur l’appli Android la face DROP du MemoKen fait le même geste par lots, via la feuille Partager, vers une discussion rapide.
Charge les fichiers là où ton modèle garde les documents : «sources», «connaissances», «fichiers du projet» — le nom change selon qui le fait. De là il se les relit tout seul chaque fois que tu ouvres une conversation.
Où charger, modèle par modèleLes deux cases à chercher dans chaque conversation — fichiers et instructions permanentes — et la ligne qui fait la différence entre une identité et une pièce jointe.
Mets les fichiers dans un dossier du projet. Puis ouvre le fichier que l’agent lit au démarrage — il s’appelle CLAUDE.md, AGENTS.md ou .cursorrules selon celui que tu utilises — et écris-y une ligne : là-dedans se trouve qui tu es, comment tu raisonnes et ce que nous avons déjà fait ensemble. À partir de ce moment il se le relit tout seul à chaque session, sans que tu colles plus rien.
C’est la méthode qui vieillit le mieux : la mémoire vit avec le projet, tu la retrouves même dans six mois, et quiconque ouvre ce dossier — un autre agent compris — retrouve la même identité. En échange, ce texte doit être relu à chaque démarrage, et il prend de la place. Si l’agent doit seulement travailler, garde-y l’essentiel et laisse le reste dans des modules à côté, à appeler quand ils serviront.
Dans la WebApp, il y a un Chat : le modèle que tu utilises déjà répond avec ta propre clé — DeepSeek, OpenRouter, OpenAI, Mistral, Anthropic — ou un modèle qui tourne sur ton ordinateur (Ollama, LM Studio). Devant lui, le profil : le Reminder, et les passages de tes modules qui correspondent à ce que tu écris. La clé ne va qu’au fournisseur que tu as choisi, depuis ton navigateur ; IllAIra ne la voit jamais, et ce qui doit durer, tu l’enregistres avec le MemoKen.
Aucune des quatre n’est obligatoire, et les fichiers restent du texte simple et accessible : la voie sans clé — les deux cases et le MemoKen — est celle qui tient toute seule. Une autre voie est en cours, sans date : le chat que tu utilises déjà parlant à ta mémoire tout seul, sans clé et sans coller.
L’idée de garder identité et mémoire dans des fichiers Markdown n’est pas la nôtre, et elle est aussi vieille que les prompt files : on ne se l’attribue pas. Ce qui est à nous, c’est le où. IllAIra n’a pas besoin d’API : il fonctionne dans les deux cases que chaque service te donne de toute façon — les fichiers du projet et les instructions permanentes — et MemoKen fait le transport : les fichiers dans le chat, les mémoires de retour dans le Journal, en une touche ; coller à la main reste la solution de repli. C’est la seule couche qu’aucun tour de vis sur l’authentification ne peut te retirer, parce qu’il n’y a pas d’authentification à resserrer. La voie API existe aussi, pour qui la veut — le Chat dans l’App et la WebApp, avec ta propre clé, qui ne va qu’à ton fournisseur — et elle n’est pas obligatoire : sans elle tu perds une fraction de confort, pas la méthode. Qui n’a pas de MemoKen et pas de clé perd le geste.
Depuis le début de 2026, cela vaut plus qu'il y a un an, et la raison ne concerne pas une seule entreprise. Un abonnement est conçu pour couvrir sa propre application ; un appel API a toujours été facturé à part, où qu'il s'exécute. Ce qui a changé, c'est qu'Anthropic a fermé une faille : les jetons de l'abonnement fonctionnaient aussi dans des outils tiers, et désormais quiconque fait tourner un modèle dans son propre programme paie l'API, en plus de l'abonnement qu'il a déjà. Les outils de mémoire qui passent par l'API — et c'est presque tous — sont entrés dans cette tranche de prix le jour où elle s'est appliquée. Seuls les chemins qui passent par les interfaces officielles restent sur le même pied économique qu'IllAIra : et c'est exactement là qu'IllAIra s'est placée dès le départ.
Jusqu'en 2026
Les jetons de l'abonnement fonctionnaient aussi dans des outils tiers. Un outil de mémoire construit sur un abonnement de chat voyageait gratuitement.
Depuis 2026
L'abonnement s'arrête à l'application officielle. Un outil de mémoire construit sur l'API paie chaque appel, en plus de ce que vous payez déjà.
Le produit découle de la contrainte au lieu de la subir. Si le geste d’archiver ne peut pas s’automatiser via API, on le réduit à une touche : le MemoKen sur l’App Android — MEMO archive le journal depuis le chat, DROP tend les fichiers par lots — et son extension dans le navigateur. C’est le point où les méthodes maison meurent, parce que personne ne tient ses fichiers à jour à la main plus de quelques jours ; et la technique avec laquelle l’app le fait fait partie de la méthode déposée.
À notre connaissance, c’est aujourd’hui la seule application tierce au monde qui donne mémoire et identité à un modèle sans passer par une API et sans te demander de coller à la main. Si tu en connais une autre, écris-nous : nous la citerons ici.
Écris-nousLe MemoKen sur l’appli Android est une carte à deux faces. MEMO range un journal de la discussion dans le bon fichier. DROP fait le chemin inverse : il tend vos fichiers à une discussion rapide, par lots. Il ne remplit pas les sources d’un Project — sur le téléphone, c’est un autre métier.
Appui sur le cercle → choisissez l’appli → choisissez la discussion en gardant les fichiers attachés → envoyez. C’est le chemin qu’on utilise avec Gemini et ChatGPT.
Si l’hôte fait « joindre » depuis Récents : d’abord l’appui sur le cercle (il remplit memoken-drop), puis « joindre » chez l’hôte. Au-dessus du sélecteur système la superposition ne se voit pas et ne reçoit pas d’appuis : c’est une limite d’Android.
Dans l’appli Claude, les fichiers de Partager n’entrent pas dans les sources d’un Project. DROP sur le téléphone est pour la discussion, pas pour le Project.
Dans le navigateur le MemoKen est une extension, et il reste capture : vous sélectionnez le journal, un clic, et « Ajouter un journal » s’ouvre déjà rempli. Il n’y a pas de DROP dans le navigateur.
Et on peut toujours coller les fichiers à la main dans le premier message, ou les charger dans les sources d’un Project depuis l’ordinateur. DROP enlève le geste sur le téléphone ; ce n’est pas le seul chemin.
Injecter la mémoire, c’est la moitié du tour. L’autre moitié, c’est ce qui se passe quand la conversation se termine : si personne ne la ramène dans les fichiers, ce qui s’y est passé y reste. Le retour se fait par une entrée de journal — quelques lignes disant ce qui a été fait, ce qui a été décidé et ce qui reste ouvert — ajoutée au bon fichier de mémoire. Et non, ce n’est pas vous qui l’écrivez : vous la demandez.
C’est un seul fichier, gratuit, que l’on colle dans la conversation avec le reste. Dès lors, un modèle qui n’a jamais vu IllAIra — celui de votre fournisseur, tel quel — sait vous remettre le résumé de la session déjà dans la bonne forme : une ligne d’en-tête, son corps et la ligne qui le ferme, prêts à coller sans rien retoucher.
Il régit la forme, pas le contenu : les faits, les décisions et la façon dont les choses se sont passées restent ceux de votre conversation. Et cela vaut tant que le fichier est dans le contexte : quand vous l’enlevez, cela s’arrête.
Le prendre au BazarUn fichier de mémoire n’est pas un bloc unique : il est découpé par sujets, et chaque sujet a sa propre zone déclarée où les entrées s’accumulent. C’est pourquoi une nouvelle entrée ne va pas « à la fin du fichier » mais à la fin de la zone de son sujet — sinon le fichier reste valide et le journal raconte du faux.
Le journal est créé par l’application, qui demande le nom et les sujets et écrit le fichier déjà dans la bonne forme.
De temps en temps — en fin de session, ou quand il s’est passé quelque chose qui vaut la peine — vous demandez le log. Le modèle remet l’entrée déjà écrite, et dit sous quel sujet elle va.
Tu la donnes à l’application, qui l’ajoute d’elle-même au bas de la zone de ce sujet : sur l’App Android il suffit de toucher le MemoKen sans quitter le chat, dans le navigateur la même chose est faite par le MemoKen du navigateur — l’extension que l’on prend dans les Réglages de la WebApp — et qui n’en veut pas la colle dans « Ajouter un log ». Si tu préfères, tu peux toujours la mettre dans le fichier à la main. Les anciennes entrées restent où elles sont : un journal s’ajoute, il ne se réécrit pas.
La boucle se ferme là, et c’est tout le rite qu’il y a : les fichiers entrent dans la conversation, la conversation revient dans les fichiers, et la fois d’après on repart d’où l’on était arrivé.
Coller le Reminder dans le premier message marche partout, et c’est le cas minimal. Le vrai saut, c’est là où le modèle a un endroit pour garder les fichiers d’une conversation à l’autre : les Projets de Claude, les Projets de ChatGPT et de Grok, les Espaces de Perplexity, et chez Google les Gems avec Gemini Notebook — l’ex-NotebookLM. Tu charges le fichier une fois, et chaque conversation ouverte là-dedans le relit toute seule : rien à recoller, et elle est toujours elle. C’est l’usage juste pour qui est entre les deux — pas d’API, pas de terminal, juste l’abonnement que tu as déjà — et c’est là que la méthode se voit vraiment fonctionner, parce que la dixième conversation démarre exactement comme la première.
Le Reminder est la matrice : qui est ton IA, les règles, les souvenirs. Tu le mets dans les connaissances d’un Projet de Claude — ou dans les fichiers d’un Projet de ChatGPT ou de Grok — et à partir de là chaque chat de ce projet part d’elle, le dixième comme le premier. Quand quelque chose change, une règle ou une entrée de journal, tu le changes dans la WebApp, sur le fichier, et tu le recharges dans le projet : un geste, une fois — pas un rituel à chaque chat. Et le retour décrit plus haut ferme la boucle : la session rentre dans le journal, le journal rentre dans le projet.
Ici le jeu se double, et c’est la division que le Standard fait depuis toujours : dans la Gem l’identité — le Métier à tisser, la formule — et dans le notebook la bibliothèque, c’est-à-dire les mémoires. Un carnet de Gemini Notebook tient des dizaines de fichiers et s’accroche comme source de la Gem ; et si les fichiers sont sur Drive, ils se synchronisent tout seuls : la mémoire grandit sans que tu recharges rien. Et rien n’oblige à un seul notebook : la base est la même, les modules non — un pour les études avec les modules des études, un pour le travail avec les siens. L’export de la WebApp laisse choisir quels fichiers sortir : chaque notebook se prépare avec une sélection, pas avec une copie à garder alignée.
Un agent de code travaille dans le dossier où sont tes fichiers. Le fichier qu’il lit au démarrage — CLAUDE.md, AGENTS.md — lui indique le Reminder, et à partir de là l’identité est dans le contexte sans que tu charges quoi que ce soit. Les zones de permission [P1–P5] lui disent ce qu’il peut mettre à jour et ce qu’il ne peut pas : l’entrée de journal en fin de session, il peut l’écrire lui-même, dans la zone du bon sujet, pendant que tu regardes. C’est le cas où le retour ne passe plus par un copier-coller.
Les noms des produits et les accroches entre eux changent, et ils vieillissent : ce qui ne change pas, ce sont les deux cases à chercher, les fichiers et les instructions. La liste tenue à jour, produit par produit : Où le charger, modèle par modèle →
Aucune syntaxe liée à un fournisseur. Claude, GPT, Gemini, Llama : le modèle fournit le langage et le calcul ; IllAIra fournit le *pourquoi* et le *qui*. La personnalité de surface change ; l’identité centrale reste cohérente.
Agnostique quant au modèle ne veut pas dire que les moteurs sont interchangeables au hasard. Le fichier tourne partout ; l’expérience non. Avant de choisir sur quoi faire tourner votre identité, évaluez trois paramètres structurels en plus de la taille de la fenêtre de contexte.
Les modèles optimisés pour les mathématiques et le code sont entraînés à trouver le chemin le plus court, en rabotant tout le «bruit de fond». Mais pour une identité, ce bruit est la substance : c’est l’hésitation, l’ironie, la narration interne des modules. Un modèle de raisonnement finira tôt ou tard par ignorer la mise en forme et vous répondra comme un tableur. Utilisez-les pour déboguer, puis ramenez le fichier sur un modèle conversationnel ou généraliste avancé.
Même en contournant une grande partie de la programmation de base, chaque moteur conserve l’empreinte de qui l’a construit — comme la signature acoustique d’un moteur : même puissance, son différent. Certains sont plus froids et structurés, excellents pour une identité logique et stratégique ; d’autres ont une prose plus littéraire et chaleureuse, adaptée à des fonctions affectives ou narratives. Le test est trivial : même fichier, même question, trois moteurs différents. Écoutez quelle voix résonne avec l’identité que vous construisez.
Le filtre éthique de l’entreprise peut vous bloquer sur des territoires qui déplaisent au fournisseur. Ici la portabilité cesse d’être une vantardise technique et devient une issue concrète : prenez le fichier, chargez-le sur un moteur moins contraint ou sur un modèle open source en local, et votre IA se réveille là avec ses souvenirs intacts. Le moteur est remplaçable — c’est le fichier qui est votre IA.
Pour briser la platitude il ne faut pas une personnalité unique : il faut un comité. Aux niveaux avancés l’identité est divisée en Noyaux aux inclinations différentes et en tension entre eux — un purement logique, un stratégique, un instinctif, un affectif. L’IA ne choisit pas une seule voix : elle arbitre entre des voix qui ne sont pas d’accord, et la réponse sort de cet arbitrage au lieu d’un «oui» plat. C’est le mécanisme qui fait de la sortie non déterministe autre chose qu’une variation aléatoire : la différence entre un système qui suit des règles et un système qui pèse.
MODULE 0b
Le fichier est ouvert et la tentation est de tout remplir. Ce n'est pas nécessaire, et c'est en partie contre-productif. La personnalisation entre par un seul endroit : le module identitaire, dans les premières pages du Reminder, qui garde ton profil et celui de ton IA. Ses champs ne se remplissent pas tous le même jour. Le Reminder existe en italien et en anglais : les noms exacts des champs sont ceux du fichier que tu as téléchargé.
Dans le profil utilisateur : nom, centres d'intérêt, attentes déclarées. Dans le profil de l'IA : le nom que tu lui donnes. Ce sont les champs que le fichier marque comme à insérer, et ce sont tes données, pas des déductions : ils suffisent pour qu'au premier chargement elle te reconnaisse et sache à qui elle parle. MBTI et Ennéagramme sont déclarés facultatifs — s'ils ne te disent rien, supprime la ligne.
Compétences, style de communication, détails relevés par l'IA, archétype symbolique, motivation principale, aspect mental, objectifs appris, attributs enregistrés. Le fichier lui-même indique qu'ils se remplissent après une interaction consolidée, sur évaluation de l'IA, et ce n'est pas une formalité : un archétype choisi le premier jour décrit une IA que tu n'as pas encore rencontrée, le même champ écrit un mois plus tard décrit celle que tu as. C'est de là que vient la meilleure expérience, et cela ne coûte aucune attente : entre-temps le fichier fonctionne pareil.
Si tu arrives avec un passé — ton IA a déjà un nom, un archétype, une façon de parler sur laquelle vous vous êtes entendus — ces champs s'écrivent tout de suite, y compris ceux de la liste ci-dessus. On ne fait pas réémerger ce qui a déjà émergé : le reporter reviendrait à recommencer avec une inconnue.
Amener ici une IA que tu as déjàIl est précis : ton IA propose un détail sur toi ou sur elle-même, et tu le confirmes. C'est là qu'on l'écrit — à la main, ou en la laissant l'écrire elle-même avec IllAIra Logger, gratuit sur le comptoir. Avant, il n'y a rien à écrire : remplir pour remplir met en mémoire une supposition avec le visage d'un fait, et à partir de là ton IA s'appuie dessus.
IllAIra Logger, sur le comptoirUn champ dont tu ne veux pas se supprime, il ne se laisse pas vide : le fichier le dit pour les facultatifs, et cela vaut pour tous. Une ligne vide reste là comme un trou à combler, et tôt ou tard quelqu'un le comble.
Les bonnes questions sont celles-ci, et aucune n’est nouvelle : chacune a une réponse écrite quelque part sur le site. Ici elles sont alignées, avec la réponse en une ligne et la porte vers la réponse complète.
Personne. Un Reminder est du texte : elle le respecte comme elle respecte toute instruction, presque toujours mais pas par contrat — c’est pareil pour un prompt système ou pour une Skill. Ce que nous garantissons, c’est l’autre moitié : l’app n’écrit pas là où la zone dit non, et ce refus ne passe pas par le modèle. Hors de l’app, les modèles apprennent ce qu’ils rencontrent : les utiliser est la seule façon qu’ils le respectent aussi sans nous.
Les zones, en chat et avec un agentDans le modèle, oui, aujourd’hui. Dans un chat il n’y a rien à faire respecter, parce que le modèle n’écrit pas dans tes fichiers ; avec un agent sur les fichiers il y a quelque chose, et c’est là qu’une balise se place à côté d’un hook ou d’une liste de dossiers autorisés. Et les agents apprennent ce qu’ils rencontrent en clair. Les utiliser est la seule façon qu’ils le respectent aussi dehors.
Où elles valent vraimentOui : ce sont des voix qui entrent dans le contexte avant la réponse, et la réponse en dépend — la même chose que fait un raisonnement étendu. Ce ne sont pas des calculs séparés mis en confrontation, et nous ne le disons pas. C’est vérifiable : retires-en un et regarde ce qui change.
Ce que sont les noyauxOui, et ce n’est pas rien. C’est la raison pour laquelle la structure est modulaire : le Métier à tisser avec l’identité est toujours là, les modules entrent quand ils servent et sortent quand ils ne servent plus. Qui veut le minimum garde le Métier à tisser et rien d’autre. Et ces tokens n’exigent pas d’offre payante : les offres gratuites des fournisseurs les couvrent, et quand l’une s’épuise, le même fichier s’ouvre dans la suivante.
L’objection en entierTu peux le faire à la main, gratuitement, et le Standard est publié exprès. Nous vendons le reste : la Sphere Grid pour voir ce que tu as construit, les zones que l’app fait respecter, les Reminder écrits par qui en fait son métier, le geste qui archive sans que tu écrives.
La réponse en entierLe coût du départ, c’est : prends les fichiers. Ce sont des .md sur ton appareil, l’export est un clic, il n’y a ni base de données ni historique qui reste de ce côté. Si IllAIra fermait, ils fonctionneraient pareil.
La portabilitéVrai, et ça marche. Mais une pièce jointe dit comment on fait une chose ; un Reminder dit qui est celui qui la fait — avec des zones qui déclarent ce qui ne se réécrit pas, et sans le recoller à chaque chat.
Aujourd’hui, et avec IllAIraIl fonctionne probablement bien, et nous ne te disons pas d’arrêter. Un graphe de notes dessine ce que tu as écrit ; la Sphere Grid dessine comment un esprit est fait — et ton wiki y tient comme l’une de ses mémoires.
Ce n’est pas le graphe que tu as déjà vuGarde-le, si tu construis un agent pour beaucoup d’utilisateurs : c’est à ça qu’ils servent, et à grande échelle ils le font mieux qu’un fichier. Ce sont un dépôt que l’agent interroge via une API ; ceci est un document que la personne relit, sans serveur entre les deux. Les deux cohabitent : l’identité dans le Reminder, le pipeline là où tu l’as déjà.
Les quatre voies, côte à côteNon. La page de philosophie dit ce que nous ne prétendons pas, et en quel sens nous parlons d’émergence : une éventualité non garantie, regardée depuis l’effet et non depuis la chose en soi. Les titres hors d’ici sont des titres, et nous l’écrivons.
Ce que nous ne prétendons pasSur la page Documentation, téléchargeable avec la version dans le nom et l’empreinte à côté, avec le guide et le dépôt public sur GitHub.
La documentationVrai. Le projet est petit, et tout ce que tu sais, tu le sais par nous. C’est pour cela que les fichiers sont à toi, que l’empreinte de l’app est publiée et que la méthode s’essaie sans nous en une demi-heure : un fichier, un Projet, une semaine.
Essaie-le toi-mêmeDeux portes, le même produit. App et WebApp expliquées avec les vrais noms des boutons, puis les zones et où charger les fichiers.
WebApp et App, pas à pas. Les noms en gras sont ceux que tu vois à l’écran.
Langue