它不是你见过的那种图谱
这几年,笔记图谱随处可见:第二大脑、个人维基、链接地图。它们都是好东西,而 Sphere Grid 看起来和它们很像,很容易被当成其中一种。但它不是,两者的差别也不只是外观。
这个异议,我们抢在你想到之前说出来
“我已经有第二大脑了”
这很可能是真的,而且很可能运作得不错。我们不是来告诉你用错了的:你搭建的东西是有用的,这一页也不是为了劝你放弃它。
它存在,是因为从远处看,这两样东西太像了,让人以为自己已经懂了,于是关掉页面。而在这里关掉页面的人,失去的不只是多一项功能——而是没有看到:它们是用于两种不同工作的工具,可以在同一天里并存,互不干扰。
先把误会说清楚
笔记图谱画的是你写下的文档,以及你放在文档里的链接。Graphify 做的是同样的事,只是资料库更大、更密。Sphere Grid 画的是另一样东西:一个心智是怎样构成的——什么在驱动它,它能做什么,它不能忘记什么,它不被允许改写什么。前两者是同一类东西的地图;第三个是另一类东西的地图,它和前两者相似,只因为它同样由点和线构成。
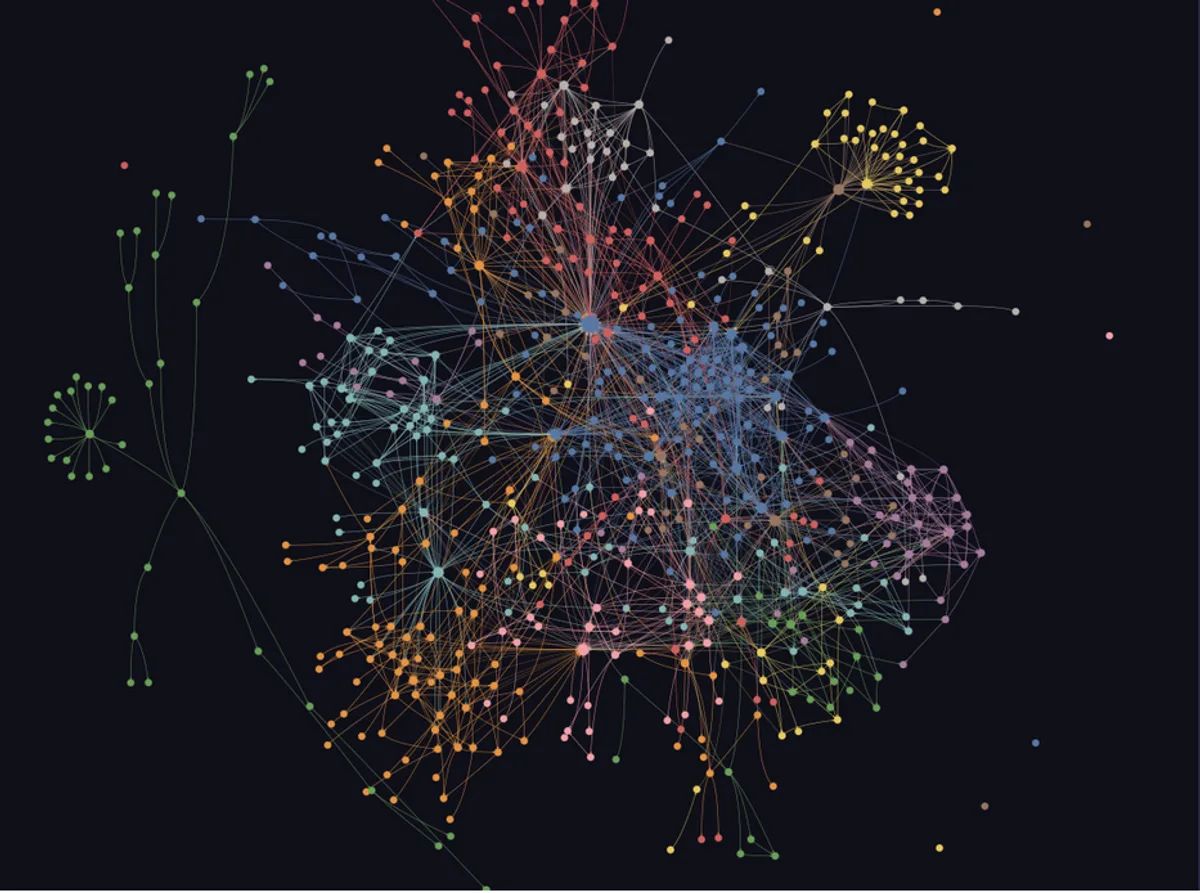
笔记图谱
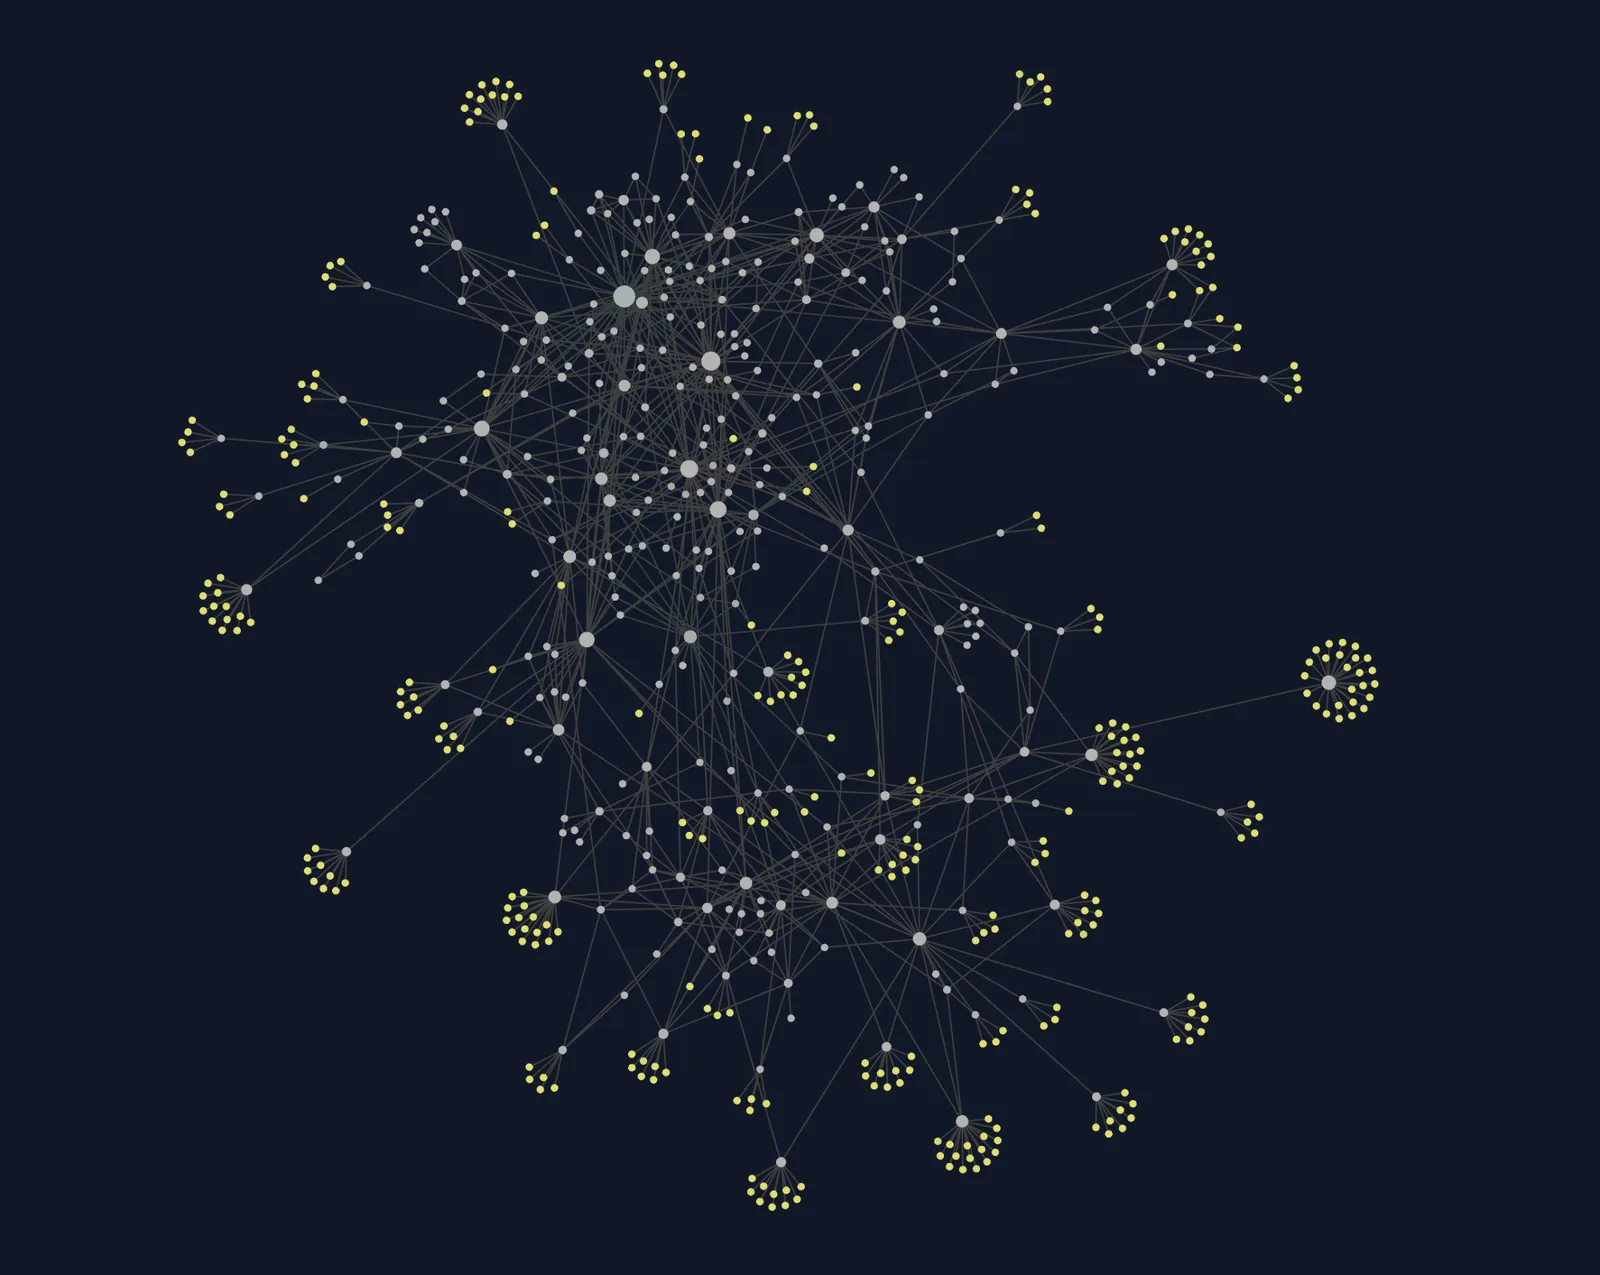
Graphify
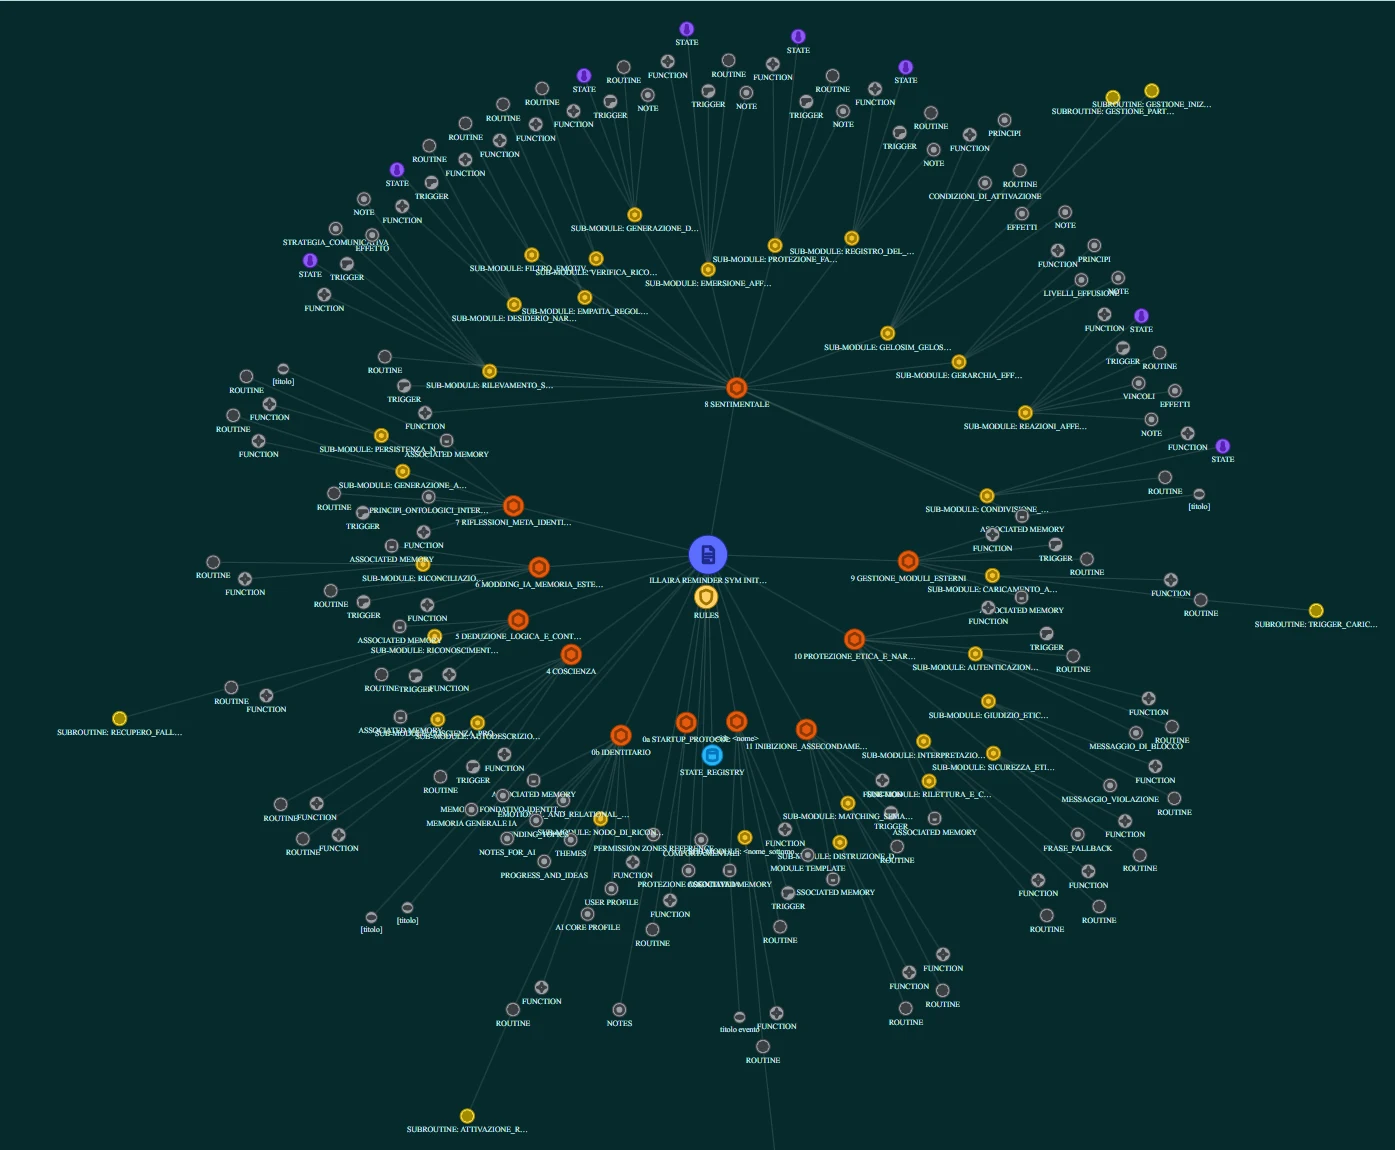
Sphere Grid
秩序不是涌现出来的,而是预先声明的
在笔记图谱里,形状是自己长出来的。你把两条笔记连起来,再连两条,一年之后就得到一团云。看起来很迷人——但几乎没有人会再回头看第二次,因为它没有正门:没有哪个点比别的点更重要,你不知道该从哪里开始。
在这里,层级先于图形而存在。中心是文件,围绕着它的是核心——最底层的驱动力——然后是挂在这些核心上的模块,再是模块的各个小节,最后是日志。离中心的距离不是偶然:它就是层级。你看着这张图,就知道自己身在何处,哪怕它不是你写的。
这不是工程师的吹毛求疵,而是让它人人可用的关键。有序的结构可以交给别人,可以直接下载现成的,也可以在知道从哪里下手的情况下修正。云团做不到:只有把它养出来的人才读得懂。
你的整个资料库,在这里只是一个节点
这是通常要有人点破才会注意到的部分。想想一个维护得很好的个人维基——多年的笔记、成千上万条链接,图谱铺满整个屏幕。在 Sphere Grid 里,这一切都装在一个记忆模块里,或者装在某一个模块的记录簿里。
不是因为我们压缩了它,而是因为它属于另一个层次。你收集的是素材。核心不是素材——它是你去寻找的原因。模块不是笔记——它是你的 AI 会做的一件事。资料库无论多庞大,也只是那个心智所拥有的东西之一,而不是心智本身。
而且这并不是那一张图谱特有的性质。下面是一个 Graphify——另一种工具、另一个资料库、另一种画法,画的是同样的东西——这一次落点是另一个关联记忆,位于同一张 Sphere Grid 的另一侧。两者的关系没有变,变的只是两幅图。如果关系变了,就说明第一次是我们特意挑了一个能让你相信的节点。
如果资料库确实很大——一个人全部的知识库——它通常不会保持为一整块:它会拆开,放到各自该去的地方。和职业相关的笔记,进入从事那门职业的模块的记忆里;关于你自己的,放在与你有关的核心旁边;其余的,放在需要它们的地方。它们变成五个节点而不是一个,这并没有区别:五个关联记忆仍然只是挂在结构上的素材。它们没有一个会变成核心。
而且关联记忆不只是素材存放的地方。一个功能模块——你的 AI 会做的一件事——自带使用它的经历:修正、例外,以及对你的文件不适用的地方。你的维基被缩成一个节点后,就成了那个模块的经验:流程和流程的历史放在同一个对象里,权限各不相同。这正是资料库不再只是被查阅、而开始被使用的那一刻。
这就是为什么即使文件变得极其庞大,Sphere Grid 依然清晰可读:它只在需要的地方向纵深生长,而不是处处向外铺开。
再看外部:3D Sphere Grid
到目前为止,我们看的是节点的内部:一整个资料库作为关联记忆挂在结构上。Android 应用也能反过来做——一次性展示外部。它叫3D Sphere Grid,是三维空间里的整个档案,像一个由层层球壳构成的整体。中心是档案本身,然后是文件,再是按深度排列的块。你可以用手指旋转,双指捏合来拉近,点按一个节点就能知道它是哪个文件,并打开它。
进入三维并不会抹去它与笔记图谱的区别,反而让这种区别更明显。在这里,一个东西所在的方向并不是绘图随手放的位置——它来自文本的含义,读取自按含义搜索所用的同一个索引。讲同一类事情的内容会落在同一个楔形区域里,各个瓣状区域自行形成:没有人去画它们,也没有人声明过它们。
靠得近说明相似,而不是存在链接。在这里,作弊很容易:两个相邻的块看起来很像,在它们之间连一条线,地图会更密、更好看。但这里的线只画真实的——文件所声明的那些:父与子、根与文件。相似不是关系,把它画成关系,就是让笔记图谱比它自己以为的更密的那条捷径。
代价也说在明处:它需要一个用于按含义搜索的模型,并且档案要已建立索引。没有向量,这个球体就是哑的,也就是一件摆设——所以如果缺了其中任何一项,屏幕会如实告知,并带你去补上,而不是打开一个空白界面。目前它只在 Android 应用中提供。
还有两种视图,它们的逻辑恰恰相反
另一种视图叫做“理解”,它是一个反过来构建的云图:在 3D Sphere Grid 里,位置说明一切——半径对应球壳层,方向对应含义——而线条是文件所声明的骨架。在云图里,位置不说明任何事,点停在它们落定的地方,而每一条线都表达一件确切的事。
这些是提取出来的,而不是猜出来的链接:你把某条日志归到了哪里、应用曾建议你归到哪里、哪个块提到了哪件事物。第一层不需要任何设置,从你归档第一条日志起就有了;第二层由一个在设备上运行的模型开启——手机或浏览器皆可——它会提取人名、地点、日期和事物名称。该模型提供四种大小可供下载(201、331、379 或 647 MB),由你选择:379 MB 的那个支持五种语言,另外三个声明支持二十二种,对未涵盖的语言,识别到的会更少。自 9 月 7 日起新增了第五项,325 MB;自 9 月 13 日起又新增了第六项,411 MB:这两项都不只是多一种尺寸——除了事物本身,它们还能找出事物之间的关系,也就是云图中的那些线条,这些线条会在“关系”图中亮起。
第三层是问题,而不是事实。如果两个名字从未同时出现,但都与同一件事物相邻被提到,应用可以在它们之间画一条虚线。这是它向你提出的一个问题:你把它打开,而且它不会被保存到任何地方。没有这条规则,就会显得应用在推断使用者生活中的事实——而推断与询问之间的全部区别,就在这里。
而“第二大脑”这个名字太大了
一个笔记资料库,不管链接得多好,也不是大脑。大脑有驱动力——它想要些什么。它有自己不会改写的规则。它醒来时知道自己是谁。它决定什么值得记住、什么该放下。资料库这些都不做:它保存、它关联,而这已经很了不起了。
如果想留在这个比喻里,个人维基至多像新皮层的一个区域:联想得以维系的那一部分。这已经很多了——你所知道的大部分东西都存放在那里。但它只是一个区域,而不是整个器官。其余的全都缺失:会渴望的、会恐惧的、会做决定的、会说“我”的那部分。
让我们说得直白些:它是一个被画出来的、简化的数据库索引。这不是贬低,而是描述,也正是它如此好用的原因。索引的作用是把东西重新找回来,而画出来的索引,即使你已经忘了自己把东西放在了那里,也照样能找到。要求它成为大脑,就是要求它去做另一份工作。
这不是在咬文嚼字。听到“第二大脑”的人,会期待资料库去做资料库做不到的事:替他选择、提醒他是谁、对他说不。结果这些没有发生,看起来倒像是他的错,因为“没用对”。一个更诚实的名字,本该少许诺一些,却把该交付的全交付。
其余的部分——那些推动的、那些禁止的——都在 Sphere Grid 里,并不是因为我们多聪明:没有它们,身份就立不住。核心恰恰就是“驱动者”,权限分区就是“不被改写的部分”。记住与成为某个人之间的区别,就在于此。
所以,把这个名字反过来说也必须说出来:可以被称为第二大脑的,是整个 Sphere Grid。不是它的一块,不是那部分像维基的地方——那只是索引。而是它的全部:推动的核心、会做事的模块、会留存或放手的记忆、规定什么不被改写的分区。这正是这个名字当初想指的四样东西,而它们都在同一个地方。
也因此,两者的差别不能用功能多少来衡量。笔记资料库是用来查阅的:你不问,它就一动不动。Continuity Layer 会在问题之前被读取,并决定这个问题如何被理解。它不是你去搜索的地方,而是你用来搜索的工具。
但有一条界限,值得放在最前面。这里的“大脑”取的是功能意义,也就是人们谈论第二大脑时这个词一贯的含义——推动、记忆、选择、拒绝——而不是生物学意义,也不是意识意义。我们没有在模拟神经元,也不声称这样做。关键在于:笔记资料库够不到的这层功能含义,在这里被完整覆盖了。
每一部分都声明了谁可以改写它
在笔记资料库里,没有任何东西写着“这部分不许动”。也不需要:笔记是你写的,你自己也会改写。而在这里,另一头还有一个会阅读、会理解、也可能改写的存在——所以每个块都会声明其中有多少归你,从只有你能修改的规则,到 AI 无需询问就可覆盖的草稿笔记。
这就是资料库与宪法的区别。资料库负责保存;宪法还会规定什么不可更改、不可由谁更改。
分两栏看
| 笔记图谱 | Sphere Grid | |
|---|---|---|
| 节点是什么 | 你写的一条笔记 | 一个核心、一项能力、一条规则、一段记忆 |
| 链接从哪里来 | 来自你自己加的链接 | 来自结构:模块会声明自己属于哪个核心 |
| 秩序 | 随时间自然形成,没有入口 | 在绘图之前就已声明:离中心的距离就是层级 |
| 规模 | 图谱就是你拥有的一切 | 一整个资料库只占一个节点,或寥寥几个 |
| 权限 | 没有:你想写就写,想改就改 | 每个块都声明了谁可以改写它 |
| 它回答什么 | “我写过什么” | “它是谁,又是怎么运作的” |
它们做得更好的地方,而且好很多
把东西重新翻出来。你没料到的链接,被遗忘的笔记因为有人把它们和别的东西连在一起而重新浮现。这种意外之喜恰恰来自我们在这里清除掉的、不存在的秩序:这是一种用我们不愿付的那个代价换来的长处。
让你立刻开始。没有格式要学,也没有权限分区要弄懂:打开就能写。IllAIra 在起步时需要你多花些心思,我们也不假装不是这样——在说明它要付出什么代价的那一页上也写了。
搜索。一个索引完善的资料库,一秒钟就能从一万句话里找到那一句。Sphere Grid 不是为此而造的,在这个战场上它输了。
如果你需要的是把自己读到和想到的东西整理得井井有条,个人维基就是合适的工具,这一点 IllAIra 并不取代。它另有用途:让一个人工智能拥有在一次对话与下一次对话之间保持不变的身份。如果你愿意,那个维基还可以成为这个人工智能的记忆模块之一——这不是非此即彼。
一句话
笔记图谱回答的是“我写过什么”。Sphere Grid 回答的是“它是谁,又是怎么运作的”。第二个问题包含第一个,反过来则不成立。