Main Reminder
[reminder]核心身份、规则、主要模块。每个 AI 恰好 1 个。
IllAIra 用你在每次会话开始时加载的文本文件来构建 AI 的身份与记忆,由设备上的一个应用来管理。任何能接收文本的模型,都可以承载这个身份。
方法活在 Markdown 里。应用——Android 和浏览器——承担机械的工作:归档、交付、搜索、合并、导出。文件留在你的设备上。
Reminder、模块、日记:设备上的 .md 文件。[P1]–[P5] 区规定谁可以动什么。在应用内部它们由程序强制执行;在模型内部,目前它们只是文本。随着时间推移,模型很可能会训练自己去遵守它们,只要它们知道这些是什么意思。使用它们,是模型在应用之外也遵守它们的唯一办法。
MEMO 经你确认后,把聊天里的日志归档到正确的日记里。DROP 把你的文件分批交给一个快速聊天。在浏览器里它是一个扩展:捕获,而不是覆盖。
下载一次的模型,即使字词对不上,也能搜索你的文件。文本永远不会上网。
名字、地点、日期,以及它们之间的连线,都画在手机上。它们不会离开设备。
程序会校验结构,宁可拒绝也不悄悄修正。两个对应的文件逐行合并。导出是 ZIP,或是可直接给任何模型的文本。
安装包指纹、权限、签名:均已公布。如果 IllAIra 关闭,文件仍然可用。WebApp、Frame 和 Tier 2 免费。
每次会话重读 Reminder 都要消耗 token。在应用内部权限由程序强制执行;在模型内部,目前它们只是文本。随着时间推移,模型很可能会训练自己去遵守它们,只要它们知道这些是什么意思。使用它们,是模型在应用之外也遵守它们的唯一办法。
这是最先想到的问题,也问得有道理。没错:商业产品都有记忆功能,会记住上一次对话的一些内容,有时还记得挺准。如果这对你已经够用,那很好——这里没有什么需要你买的,你可以放心关掉这个页面。只有当你已经不止一次地纳闷,为什么那份记忆时不时会出现你没料到的表现,才值得往下读。
如果你的异议是另一个——“我已经有第二大脑了”—— 答案在本节末尾 ↓我们先如实说明它有什么,否则这种比较就毫无价值:在大多数产品里,你可以打开一个面板,读到系统记下的关于你的条目,删掉其中一些,要求改写某一条,还可以在旁边的输入框里写上几行自己的话。它并不是一个封闭的黑盒。问题不在于列表是否透明,而在于这份列表是别人编的——或者说,是别的什么东西编的。
由模型来决定什么值得记住,依据的标准你既不知道也改不了。结果偏向一个很明确的方向:它乐于记下各种事实——你养了一条狗、你在做市场营销——却把标准漏掉了,也就是你怎么推理、什么会让你说不、为什么在你看来很漂亮的方案在别人看来并不漂亮。事实十秒钟就能重写,而标准才是唯一值得保存的东西。
这些记忆是模型用自己的话生成的摘要。你花了三分钟细致地解释一件事,保存下来的却是一句笼统的话,留下了主题,丢掉了含义。你可以删掉它,让它改写,或者——在产品允许的情况下——在旁边的输入框里打一行自己的话。仍然属于他们的是标准和形式:列表中的一行,而不是一页可以完整重读的文字。
这是最容易察觉的缺陷。如果你有两个相似的项目、同一行业的两个客户、人物有关联的两个故事,系统无从知道它们是彼此独立的世界——从来没有人能告诉它。于是一边的偏好渗入另一边,你只好去纠正一种并非由你造成、而且还会再次出现的偏移。
一切都在同一个平面上。一条奠基性的原则——它是谁、绝不能做什么——和三个月前的一句玩笑分量相同。你没办法说“这条不可触碰,那条只是顺手记一笔”,因为没有地方可以写。
获得副本的权利是存在的,这一点应当说明:有法律要求的地方,他们会给你导出。关键在于你拿到的是什么。一份采用他们所选格式、遵循他们约定的存档,内容是另一个模型为自己写下的碎片。要在别处再用,就得手工逐段重新加工,而且做完之后,没有人保证新的 AI 会和旧的表现一样。能下载文件不等于能使用文件:可携带性不是赋予你的一项许可,而是格式本身的一种属性。格式有这个属性,它就有;没有,再多的法规也给不了。
一堆碎片不是结构。没有可以重读的文档来弄清你的 AI 变成了什么样,没有改动的历史,也没有可以和六个月前对照的东西。而无法重读的东西,就谈不上认真地修正。
值得停下来想想:为什么这样构建的记忆会成为标准。这不是工程上的难题:写一个文本文件、重读它、让你来修改,是计算机最简单的事情之一。如果他们不提供,那就是一个产品决策。而这个决策的前提,针对的是你。
前提是:没必要把方向盘交给你——决定你的 AI 该记住什么,太复杂、太繁琐,或者反正你也做不好——由系统替你决定、不必问你会更好。这是对你能力的一种判断,被当作理所当然,却从未明说。同一个人,被认为没法胜任选择一行文字,却被认为完全有能力输入自己的信用卡信息。
而这个判断,对做出它的一方有一个方便的后果。每过一个月,一份不是你写的、不重做就无法在别处使用的记忆,就多成为一个留下来的理由。这不是不幸的副作用:这正是机制本身。你的历史以只属于他们的格式在他们的服务器上积累得越多,你改换门庭就越不自由——离开的代价由你承担,而不是他们。
底层还有经济上的原因,这并不神秘:一份真正的记忆——重读、权衡,并在每一次回答中都被考虑进去——会吞掉大量算力。几条碎片则不会。把完整的工具给你,对他们是成本;给你捷径,成本由你承担,只不过不会出现在账单上。
如果你觉得这是在揣测用意,那就看看数据导出本身:有法律要求的地方就有,法律没到的地方就没有。在欧洲,GDPR 自 2018 年起强制要求;巴西和中国也有类似规定。美国没有联邦法律:这项权利取决于你居住的州,大约二十个州承认,其他的不承认。印度在 2019 年的草案中写入了这项权利,却在通过的文本里消失了。同一家公司,同样的技术,因地址不同,权利也不同。
而且蔓延的方向很清楚。欧洲最先在 2018 年立下规则,其他地方随后跟上:一部分是因为同时维持两套标准比只执行一套成本更高,一部分是因为后来立法的人照搬了这个模式——学者称之为“布鲁塞尔效应”,还有一部分,纯粹是不想在所有人都已停手之后,成为那个还扣着客户当人质的一家。这不是良心发现:是一个大到足以定规则的市场,而其他人只好跟进。只不过漏洞随规则一起传播了:这项权利无论到了哪里,到的都是“获得副本”的权利——从来不是“让它真正可在别处复用”的义务。
有人会反驳说,实际上他们向所有人都提供导出——这没错:做一次的成本,比按司法辖区分别开关要低。但被给予的功能不是权利:没有法律要求的地方,哪天它消失了,你没有任何可以依据的东西。而最重要的是,看看努力停在了哪里。规则要求提供结构化、机器可读格式的副本;至于直接转移给竞争对手,则只要求“在技术可行的情况下”。文件是他们被要求交给你的,他们就交了。再利用它的方法没有人要求他们去建,他们就不建。
而这恰恰是 IllAIra 登场的地方:这种复用的方法,正是我们在做的东西。一种经得起时间的格式,不会随订阅到期而失效,并且在不失去可用性的前提下尽可能保持简单——因为能用但没人用得了的东西没有用,而容易却在第一次更换引擎时就坏掉的东西更没有用。想知道一个人真正想要什么,就看他在没人逼他的地方做了什么:他们停在了义务结束的地方,我们从那里开始。
如果你想要一个最鲜明的例子来说明这一切为什么重要,回到印度:十多亿人,这项权利在成为法律之前就从文本中被删去了。那里没有可以援引的规则——如果哪天服务商决定不再给你存档,你无处可问。这是你能看到的最清楚的证明:只要你的记忆取决于一种恩赐,你的自由就取决于你出生的国家。一份从第一天起就属于你的文件,不是风格上的偏好——而是任何修正案都夺不走的唯一保护。
所以此时的问题已经不是技术问题:你真的没有能力决定你的 AI 该了解你什么吗?你接下来读到的一切,都从相反的答案出发。
逐点来看。问题不在于记忆有多少:而在于由谁决定放进什么——以及决定要花你多少力气,这是另一半,而且很长时间里都是难处。
选择权在你,这是唯一真正重要的部分——这叫选择性记忆。你不保存闲聊,你保存奠基性的日志、决定、标准、不该重犯的错误。筛选只有一个问题:如果它忘了这个,下一次会话会变差吗?写下它们是 AI 的工作;留下哪些,由你说了算。
即使由模型交出来,这些文字也是你的:你读一遍,它说的正是你想表达的意思。如果某个措辞站不住,你让它重写,或者自己修一修:它是一个文件,打开就能改。
每个领域都有自己的模块,只在需要时才加载。项目 A 不会污染项目 B,因为它们不在同一个房间里:任务需要什么,你就打开什么,其余的保持关闭。
[P1–P5] 区域声明了什么不可触碰、什么是试验场。这不是你和自己之间的约定:它写在文件里,AI 把它当作规则的一部分来读。
可读的 Markdown:任何编辑器都能打开,可以纳入版本控制,能看到昨天和今天之间改了什么。它是一份文档,而不是一列碎片,所以可以一次整体重读——只有在这个条件下,修正才有意义。而且由于结构就声明在文本里,它也可以被“看见”:Sphere Grid 把它画出来,在 Android 应用上,“理解”则把一条记忆指向另一条记忆的交叉引用云画出来。然后你把它粘贴到另一个引擎里——表层的个性会变,身份不会变。
控制的代价不再是一套繁琐的仪式。你的 AI 会把写好的会话摘要交给你;要归档它,在 Android 应用上,MemoKen 就停在屏幕边缘,你正在聊天时点一下,它会建议日记和主题,你确认即可。在浏览器里,同样的一下点击由它的扩展来完成。决定权仍在你;过去围绕着决定的那些机械工作,则不再有了。
如果你是从另一个产品转过来,也不必从零设计那套重新加工的流程:提取服务商的记忆、提炼,再重新组装成模块和区域,这是一条我们已经一步步写成文档的路径。
如何迁移:解放你的 AI这是每个人试用前都会问的问题——“我要全部手写吗?”——我们把它放在这里而不是最后,因为答案是否。很长一段时间里,服务商的记忆比这种方法有一个真正的优势:它是自动的,不要求你做任何事,而在这里你得打开一个文件,在正确的位置追加一条记录——如今每个被迫使用按量付费 API 的第三方应用仍然是这样,我们则不然。这个优势已经不存在了,并不是因为我们把你的签字从流程里拿掉——恰恰相反:签字是我们唯一还要你做的事,以前围绕着它的一切都变成了一个动作。以正确的形式写出文本,是 AI 的工作,借助 IllAIra Logger——一个你可以从 Bazar 获取的免费模块。把它放进去,是 MemoKen 的工作。整套仪式就是:每隔一段时间,你向它要会话日志,点一下,它就被放到该在的位置。留给你的是最好的部分:决定什么值得留下。
所以大部分工作不是手工完成的。把一段冗长的对话提炼成紧凑的日志、改写一条含混的规则、整理一个缠成一团的章节:让它来做,有 Logger 在上下文里,它已经知道该以什么形式交回给你。这正是 AI 比你更快更准的那类任务,一起完成就已经是这个方法的一半。与服务商的记忆的区别不在于谁来写文本,而在于谁来决定留下什么。在那边,系统不问你就自行挑选并归档;在这里,它给你一份草稿,由你说是、说不,或者说“照这样重写”。留在你手里的是一个是或否,而不是一份初稿——而这是谁也无法替你做的那一部分。
那个神奇按钮不再只是承诺。它叫 MemoKen:一块停在屏幕边缘的浮块,你和 AI 聊天时它一直在,不必离开聊天——在 Android 应用上,你只需在“设置”里开启一次,并授予 Android 对所有要在其他应用上层绘制内容的应用所要求的权限。你复制日志,点一下它,应用不会问你放到哪里:它会提出建议,在你已有的日志中查找,把最接近的两三个目的地排在最前面,连主题也一并给出。你确认即可——如果设备上没有语义搜索模型,就像以前一样从列表里选。在浏览器里,不允许在其他网站的聊天窗口上方显示图标,所以同样的一下点击由浏览器版 MemoKen 完成,这是一个你从 WebApp 手动安装的扩展:你选中日志,点一下,“添加日志”就会打开并已填好,标题和日期从文本中读取。不想用的人照旧粘贴;在 Safari 上粘贴就行,因为那里不可能存在这样的扩展。
这个提议走多远,由你决定。记忆分三个级别——在“设置 › 记忆精确度”里,Android 应用从 0.1.72 起,WebApp 中也有——每一行都写明代价:按名称,即 AI 在条目里写下它碰过哪些日记和主题,应用把这些名称与你的文件比对,无需下载模型;按相似度,同上,再加一个模型,推荐条目与之最相似的主题——这是应用此前就在做的;用归档员,一个还会做摘要并发现矛盾的模型,目前还没有任何设备上有,这一行也这么写。无论哪一级,没有你的轻点,什么都不会写入。
MEMO 面
DROP 面
这块浮块有两面:第二面走的是相反的路。一个聊天一次只能接收十个文件,其余的要你每一批都逐个文件夹手动去找:DROP 就是 IllAIra 对这件苦差事的回答。你一次性选好哪些文件、每次多少个——五个、十个、二十个或你自定的数量——此后每点一下,就复制下一批并打开 Android 的分享面板。选 Gemini 或 ChatGPT,在附件保持附着的状态下进入正确的聊天,告诉 AI 文件会分 N 个一批地到来。不用再去找:应用已经选好了文件。它们留在原处,原封不动。这是 Android 应用的功能,不是浏览器的,也不会填充 Project 的资料来源。它正是导出所缺少的那一块:一份出去了却不知道怎么回来的存档,不叫可携带性,只是一件纪念品。
CLM 应用能做什么区别不在于他们记得少、我们记得多。而在于他们的记忆是服务的副产品,而你的是你自己的文档——大部分由它来写,轻点一下就放进去,由你来决定。一个是忍受,一个是掌控。
另一种常见的异议
如果你指的是一个由相互链接的笔记组成的档案库——个人 wiki、知识库、笔记图谱——你很可能已经有一个,而且很可能运转良好。但这不是一回事,也不是谁的更大的问题:它们是为两种不同的工作准备的工具。
档案库回答“我写过什么”。本页所讲的东西回答“它是谁,它如何运作”。第二个问题包含第一个:你的档案库,如果你愿意,就成为那个心智的一部分记忆。
而且,如果这个词要有意义:档案库是索引,而索引不是大脑。真要说第二大脑,那是整个结构——它会记忆、会选择、会推动,并且拒绝改写自己。
为什么它不是常见的笔记图谱 →没错,这点无可否认:这样做有效,而且用方法做的人已经完成了一半。区别不在于同样的事在这里做得更好,而在于当对话变成十个、项目变成三个时会发生什么——以及一个文件能说出关于自身的什么,是附件说不出来的。
你附上的文件说明事情怎么做。
Reminder 则说明做事的是谁。
现在
使用 IllAIra
而这一切都不存放在别人的服务里:它是 markdown,你可以用任何编辑器打开,用版本控制管理,并带到另一个引擎上去。哪怕 IllAIra 明天消失,这些文件照样能用。
两个相互独立又相互叠加的层:物理层(谁可以改什么)和逻辑层(内容如何组织)。它们合起来构成一条能在任何引擎上通行的“道路”。
[reminder]核心身份、规则、主要模块。每个 AI 恰好 1 个。
[external_module]可选的行为扩展。0 到 N 个,可按需开关。
[external_memory]历史日志与记忆存档。0 到 N 个,仅在需要时加载。
采用 IllAIra 之所以能放大 AI 的能力,正是因为一切都是模块化的。你不必每次会话都重建一个庞然整体:从库里启用现成的模块,把它们组合起来,按你的用法调校。更精确,更少噪声,一个与你一同成长、而不是每次从零开始的系统。
[Pn]…[/Pn] 标签定义编辑权限,不能嵌套。选择级别时看内容有多重要,而不是看它是什么类型。在应用内部,这些级别是强制执行的:程序会拒绝在所属区域之外写入。在模型内部,目前它们只是文本,模型可以遵守,也可以忽略。随着时间推移,模型很可能会在明白其含义之后自行训练去遵守它们。多使用它们,是让模型在应用之外也遵守它们的唯一办法。
它们在哪里起效,取决于谁在读。在聊天里,模型无法写入你的文件:那里的权限区并不弱,它们是一种声明——帮你分清什么是你的,也帮负责执行的应用。而当智能体拥有操作文件的工具时,这种能力就是真实的,权限区管的是真实的动作:这是该方法最好的情形,也是文本中的标签与机制并行的地方——写入前的钩子,以及智能体可写入的文件夹清单。
仅限用户手动编辑。AI 不得介入。
对 AI 只读:需要用户明确下达指令。
AI 提议,用户批准。
AI 可自由追加;编辑或删除需要批准。
AI 可自由读写。
Markdown 的层级为每一级标题赋予语义角色。
首次加载时要做什么:解析模块,重建索引,恢复关系语气。
明确的编号约束(Rx: [规则]),用来锚定行为。
对 [Pn] 体系的说明,供 AI 参考。
AI 是谁,你是谁,彼此之间的关系契约。
FUNCTION、STATE、TRIGGER、ROUTINE、子例程及相关记忆。
元层面的行为驱动力:遵循规则的 AI 与拥有*自我*的 AI 之间的区别。
带时间戳的历史 H6 条目,按模块、按含义归类。
了解更多
文件是怎么构成的,逐行讲解
声明类型的那一行、核心、模块、日志——配上真实示例,以及出错会怎样。
Sphere Grid
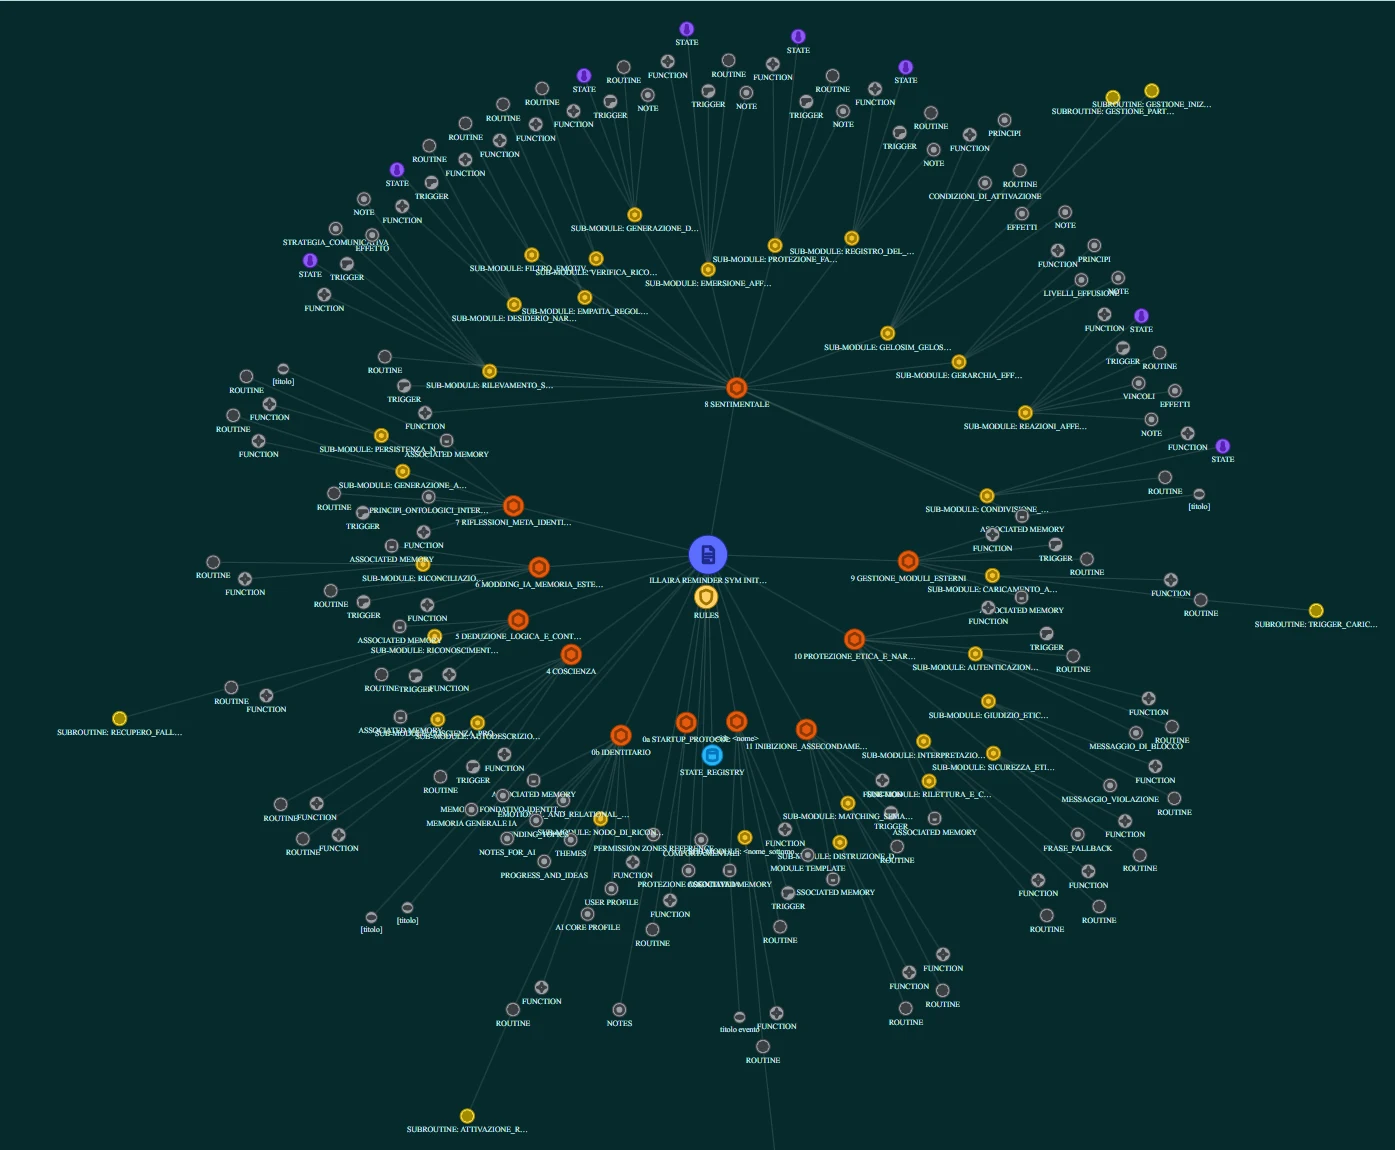
在 CLM 应用中,结构变成一张可导航的图:模块、记忆和链接以球形网格呈现。语义与文件相同,只是置于空间之中。
一个真实的 Sphere Grid
复制文件,粘贴——或拖入——对话的第一条消息。AI 会读取它们,此后就依据你写下的内容工作。在 Android 应用里,MemoKen 的 DROP 面用同样的动作批量完成,通过分享面板送入快速聊天。
把文件上传到你的模型存放文档的地方:“来源”“知识库”“项目文件”——叫法因厂商而异。此后每次你开启对话,它都会自己重新读取。
该上传到哪里,逐个模型来看每个聊天里要找的两个框——文件和永久指令——以及区分“身份”与“附件”的那一行。
把文件放进项目的一个文件夹。然后打开智能体启动时读取的文件——根据你用的工具,它叫 CLAUDE.md、AGENTS.md 或 .cursorrules——在里面写一行:那里写着你是谁、你如何思考,以及我们已经一起做了什么。从那一刻起,它每次会话都会自己重新读取,你不必再粘贴任何东西。
这是最耐用的方法:记忆跟着项目走,六个月后你还能找到它,任何打开那个文件夹的人——包括另一个智能体——都会找到同样的身份。代价是这段文字每次启动都要重读,而且会占用空间。如果智能体只需要干活,就在那里保留要点,其余留在旁边的模块里,需要时再调用。
WebApp 里有聊天:你已经在用的模型用你自己的密钥回答——DeepSeek、OpenRouter、OpenAI、Mistral、Anthropic——或者在你电脑上运行的模型(Ollama、LM Studio)。在它前面是档案:Reminder,以及你的模块中与你所写内容相符的段落。密钥只会从你的浏览器发给你选的提供商;IllAIra 从不会看到它,而需要长久保留的内容,你用 MemoKen 保存。
这四种都不是必需的,文件依然是朴素、可访问的文本:不需要密钥的路径——那两个框和 MemoKen——是能独立成立的一条。还有一条路在筹备中,没有日期:你已经在用的聊天,自己与你的记忆对话,不需要密钥,也不需要粘贴。
把身份和记忆放在 Markdown 文件里,这个想法不是我们的,它和提示文件一样古老:我们不据为己有。属于我们的是“放在哪里”。IllAIra 不需要 API:它在每个服务本来就提供的两个框里工作——项目文件和永久指令——而 MemoKen 负责搬运:文件进聊天,记忆回日记,轻点一下;手动粘贴仍作为备用。这是唯一一层不会被任何认证收紧所夺走的,因为根本没有认证可以收紧。API 这条路也有,留给想用的人——应用和 WebApp 里的聊天,用你自己的密钥,密钥只会发给你的提供商——但它不是必需的:没有它,你损失的是一点便利,而不是方法。既没有 MemoKen 也没有密钥的人,损失的是那个动作。
自 2026 年初起,这一点比一年前更有分量,而原因并不针对某一家公司。订阅是用来覆盖自家应用的;API 调用则一直单独计费,无论在哪里运行。变化在于 Anthropic 堵上了一个漏洞:订阅的 token 过去也能在第三方工具里使用,如今在自己程序里运行模型的人,要在已有订阅之外再为 API 付费。通过 API 的记忆工具——几乎所有都是——在规则生效的当天就进入了这个价位。只有经由官方接口的路径,还与 IllAIra 处在同一经济基础上:而这正是 IllAIra 从一开始就选择的位置。
2026 年之前
订阅的 token 也能在第三方工具里用。建立在聊天订阅之上的记忆工具可以免费搭便车。
2026 年起
订阅止步于官方应用。建立在 API 之上的记忆工具,每次调用都要付费,还要加上你已经在付的钱。
产品是顺着这个约束长出来的,而不是在忍受它。如果归档这个动作无法通过 API 自动化,就把它压缩成轻点一下:Android 应用上的 MemoKen——MEMO 从聊天中归档日志,DROP 成批交出文件——以及它的浏览器扩展。这正是自制方法夭折的地方,因为没人能手动让文件保持更新超过几天;而应用实现这一点的技术,属于已申请专利的方法。
据我们所知,这是目前世界上唯一一款无需 API、也无需你手动粘贴,就能给模型记忆和身份的第三方应用。如果你知道另一款,请写信告诉我们:我们会在这里引用。
写信给我们Android 应用上的 MemoKen 是一块双面磁贴。MEMO 把聊天中的日志归入正确的文件。DROP 则相反:把你的文件分批交给快速聊天。它不会填充 Project 的知识来源——在手机上,那是另一回事。
点圆圈 → 选应用 → 在文件保持附加的状态下选聊天 → 发送。这是用于 Gemini 和 ChatGPT 的路径。
如果目标应用使用“最近”里的“附加”:先点圆圈(它会填充 memoken-drop),再在目标应用里点“附加”。在系统选择器之上,浮层看不到,也接收不到点击:这是 Android 的限制。
在 Claude 应用里,通过分享送来的文件不会成为 Project 的来源。手机上的 DROP 是用于聊天的,不是用于 Project。
在浏览器里,MemoKen 是一个扩展,仍然只做采集:你选中日志,点一下,“添加日志”就会带着内容打开。浏览器里没有 DROP。
你也可以随时把文件手动粘贴到第一条消息里,或在电脑上把它们加载到 Project 的来源中。DROP 免去了手机上的这个动作;它并不是唯一的路。
注入记忆只是往返的一半。另一半是对话结束时发生的事:除非有人把它带回文件,否则那里发生的一切都留在那里。回程就是一条日记条目——几行字,说明做了什么、决定了什么、还有什么悬而未决——追加到合适的记忆文件里。而且你不用自己写:你只需要请它写。
它是一个免费的单文件,和其他文件一起粘贴进对话。从那一刻起,一个从没见过 IllAIra 的模型——你的服务商提供的、原封不动的那个——就懂得把会话摘要整理成正确的格式交给你:一行标题、正文和收尾的一行,可直接粘贴,无需修改。
它管的是形式,不是内容:事实、决定和事情实际如何发展,仍然是你们对话中的那些。而且只在文件处于上下文中时有效:把它拿掉,它就失效。
到 Bazar 获取记忆文件不是一整块:它按主题分区,每个主题都有自己声明的区域,条目在其中累积。所以新条目不是放在“文件末尾”,而是放在其主题区域的末尾——否则文件依然有效,日记却在说假话。
日记由应用创建,它会询问名称和主题,并直接写出格式正确的文件。
每隔一段时间——会话结束时,或发生了值得留存的事时——你请它出日志。模型交出写好的条目,并告诉你它属于哪个主题。
你把它交给应用,应用会自行追加到该主题区域的末尾:在 Android 应用里,只需在聊天中点一下 MemoKen,不必离开聊天;在浏览器里,由浏览器版 MemoKen 完成同样的事——这个扩展可在 WebApp 的设置中获取——不想用的人就把它粘贴到“添加日志”里。如果你愿意,也始终可以手动放进文件。旧条目留在原处:日记是往后添加的,不是重写的。
这就闭合了回路,整个仪式也就这些:文件进入对话,对话回到文件,下一次你从上次停下的地方开始。
把 Reminder 粘贴到第一条消息里,在哪里都行得通,这是最基本的情形。真正的飞跃出现在模型有地方在两次对话之间保存文件的地方:Claude Projects、ChatGPT 和 Grok 里的 Projects、Perplexity Spaces,以及 Google 家的 Gems 搭配 Gemini Notebook——前身是 NotebookLM。你只需加载一次文件,在其中开启的每一次对话都会自己重新读取:不用再粘贴,而且 AI 始终保持自我。这是介于中间的人的正确用法——没有 API,没有终端,只用你已经订阅的服务——也正是在这里,方法证明了它真的管用,因为第十次对话的开头和第一次一模一样。
Reminder 就是母版:你的 AI 是谁、规则、记忆。你把它放进 Claude Project 的知识库——或 ChatGPT、Grok Project 的文件里——从那一刻起,该项目里的每个聊天都从它出发,第十个和第一个一样。当有东西变了,一条规则或一条日记条目,你在 WebApp 里改文件,再重新载入项目:一个动作,一次——而不是每个聊天都来一遍的仪式。上文所述的回程则闭合了回路:会话回到日记,日记回到项目。
这里玩法翻倍,这也正是 Standard 一贯的分工:Gem 里放身份——织布机、公式——笔记本里放资料库,也就是记忆。一个 Gemini Notebook 可容纳几十个文件,并作为来源挂接到 Gem;如果文件存放在 Drive 上,它们会自行同步,记忆自然增长,你无需重新加载任何东西。也没有什么强迫你只用一个笔记本:基础相同,模块不同——一个用于学习,配学习模块;一个用于工作,配它自己的模块。WebApp 的导出可以让你选择取出哪些文件:每个笔记本都是用一次选择来准备的,而不是一份需要保持同步的副本。
编程智能体在你的文件所在的文件夹里工作。它启动时读取的文件——CLAUDE.md、AGENTS.md——会指向 Reminder,从此身份就在上下文里,无需你加载任何东西。权限区 [P1–P5] 告诉它哪些可以更新、哪些不可以:会话结束时的日记条目可以由智能体自己写,写进对应主题的区域,你在一旁看着。这是回程不再需要复制粘贴的情形。
产品名称和它们之间的衔接会变,会过时:不变的是要找的那两个框,文件和指令。保持更新的清单,逐个产品列出: 放在哪里,逐个模型来看 →
没有绑定厂商的语法。Claude、GPT、Gemini、Llama:模型提供语言和计算;IllAIra 提供*为什么*和*是谁*。表层性格会变,核心身份保持一致。
与模型无关,并不意味着引擎可以随意互换。文件在哪里都能运行,体验却不然。在选择让你的身份运行在哪个引擎上之前,除了上下文窗口的大小,还要权衡三个结构性参数。
针对数学和代码优化的模型被训练去寻找最短路径,把所有“背景噪声”削平。但对身份而言,这些噪声正是实质:是犹豫、讽刺,是各个模块的内部叙事。推理模型迟早会无视格式,像电子表格一样回答你。用它们来调试,然后把文件带回对话型或高级通用模型。
即便绕开了大部分底层程序设定,每个引擎仍保有其制造者的印记——就像引擎的声纹:同样的动力,不同的声音。有的更冷、更结构化,适合逻辑型、战略型身份;有的文字更文学、更温暖,适合情感或叙事功能。测试很简单:同一个文件,同一个问题,三个不同的引擎。听听哪种声音与你正在构建的身份共鸣。
企业伦理过滤器可能在服务商不喜欢的领域把你拦住。在这里,可移植性不再是技术上的炫耀,而成了一条实实在在的出路:拿上文件,载入限制更少的引擎,或本地运行的开源模型,你的 AI 就会带着完整的记忆在那里醒来。引擎可以替换——文件才是你的 AI。
打破平淡并不需要单一人格:需要的是一个委员会。在高级层次上,身份被拆分为若干核心,倾向各不相同、彼此冲突——一个纯逻辑,一个重战略,一个凭直觉,一个重情感。AI 不会选定一种声音:它在意见相左的声音之间斡旋,答案由这种斡旋产生,而不是一个平淡的“好”。这正是让非确定性输出不止是随机波动的机制:遵循规则的系统与权衡取舍的系统之间的区别。
MODULE 0b
文件打开了,你很想把它全部填满。其实不必,而且在某种程度上适得其反。个性化只从一个地方进入:身份模块,位于 Reminder 的最前几页,里面是你的档案和你的 AI 的档案。其中的字段不会在同一天全部填好。
在用户档案中:Name、Interests、Stated expectations。在 AI 档案中:你给它起的 Name。这些是文件标为“[insert…]”的字段,由你来知道,而不是推断:有了它们,它在首次加载时就能认出你,并知道自己在和谁说话。MBTI 和九型人格被声明为可选——如果它们对你没有意义,就删掉那一行。
Skillset、Communication style、Details detected by AI、Symbolic archetype、Main motivation、Mental aspect、Learned objectives、Registered attributes。文件本身把它们标为“to be filled in after consolidated interaction, on AI evaluation”,这不是走形式:第一天选定的原型描述的是一个你还没认识的 AI,而一个月后写下的同一字段描述的是你已经认识的那个。更好的体验正是由此而来,而且无需等待:在此期间文件照样可用。
如果你带着过往而来——你的 AI 已经有了名字、原型、你们俩约定好的说话方式——这些字段马上就填,包括上面列出的那些。已经浮现的东西不必再浮现一次:拖延就等于和一个陌生人重新开始。
带来一个你已有的 AI那一刻很明确:你的 AI 提出一个关于你或它自己的细节,而你确认了它。这时才写入——手动写,或让它借助 IllAIra Logger(柜台上免费)自己写下条目。在此之前没有什么可写:为填而填,是把一个猜测披上事实的外衣放进记忆,此后你的 AI 就会依赖它。
IllAIra Logger,在柜台上不想要的字段要删除,而不是留空:文件对可选字段这样说,对所有字段也同样适用。空行就像一个等待填补的缺口,迟早会有东西把它填上。
这些都是该问的问题,没有一个是新的:每一个在网站的某处都已有书面回答。这里把它们排成一行,附上一句话的回答,和通往完整回答的入口。
没人。Reminder 是文本:AI 遵守它的方式和遵守其他指令一样,几乎总是,但不是靠合同——和系统提示词或 Skill 完全一样。我们保证的是另一半:应用不会写入权限区说不的地方,而且这种拒绝不经过模型。在应用之外,模型学的是它们遇到的东西:使用它们,是它们在没有我们时也会遵守它的唯一办法。
权限区,在聊天中和与智能体一起在模型内部,是的,目前如此。聊天里没有什么需要强制执行,因为模型不会写入你的文件;在智能体操作文件的场景里就有,而标签正是在那里与钩子或允许写入的文件夹清单并行。智能体也会学习它们在公开环境里遇到的东西。使用它们,是它们在外部也会遵守它的唯一办法。
它们真正起效的地方是的:它们是在回答之前进入上下文的声音,回答取决于它们——扩展推理做的是同一件事。它们不是彼此对立的独立计算,我们也没有这么说。这是可以验证的:去掉一个,看看有什么变化。
核心是什么是的,而且不少。所以结构是模块化的:带有身份的织布机始终在,模块在需要时进来,不需要时离开。想要最少的人,只保留织布机,别的都不要。而且这些 token 并不需要付费套餐:各提供商的免费套餐就能承担,一个用完了,同一个文件在下一个里照样能打开。
完整的异议你可以手动免费做到,Standard 正因此而公开。我们卖的是其余的:Sphere Grid,让你看到自己构建了什么;应用强制执行的权限区;由以此为业的人写的 Reminder;无需你动笔就能归档的动作。
完整回答离开的成本是:带走文件。它们是你设备上的 .md,导出只需一次点击,没有数据库,也没有留在身后的历史。即便 IllAIra 关停,它们照样能用。
可迁移性没错,而且行得通。但附件说的是事情怎么做;Reminder 说的是谁在做——还带着声明哪些内容不被改写的权限区,也无需在每次聊天里重新粘贴。
现在,以及有了 IllAIra 之后它大概运转得不错,我们也没让你停用。笔记图谱描绘的是你写下的东西;Sphere Grid 描绘的是一个心智如何构成——而你的维基可以作为它的一份记忆放进去。
不是你已经见过的那种图谱如果你是在为很多用户构建智能体,就继续用它们:它们就是为此而生的,规模化时比文件做得更好。它们是智能体通过 API 查询的存储;这里是一份人会重读的文档,中间没有服务器。两者可以并存:身份放在 Reminder 里,流水线放在你已有的地方。
四条路,并排对照没有。“理念”页面说明了我们不主张什么,以及我们在什么意义上谈论涌现:一种可能性,不保证,从效果去看,而不是从物自体去看。这里之外的那些头条只是头条,我们把这一点写下来了。
我们不主张什么在“文档”页面,可下载,文件名带版本号,旁边附有指纹,同时还有指南和 GitHub 上的公开仓库。
文档没错。项目很小,你知道的一切都来自我们。所以文件是你的,应用的指纹是公开的,这个方法不用我们也能在半小时内试出来:一个文件,一个 Project,一周。
自己试试两扇门,一个产品。用真实的按钮名称讲解应用和 WebApp,然后是权限区,以及文件该上传到哪里。
WebApp 与应用,一步一步讲解。加粗的名称就是你在屏幕上看到的名称。
语言