Main Reminder
[reminder]コアとなるアイデンティティ、ルール、主要モジュール。AI ごとにちょうど 1 つです。
IllAIra は、セッションの開始ごとに読み込むテキストファイルで、AI のアイデンティティと記憶を構造化します。管理するのは端末上のアプリです。テキストを受け付けるモデルなら、どれでもそのアイデンティティを受け入れられます。
メソッドはMarkdownの中にあります。アプリ(Androidとブラウザ)は、アーカイブ、受け渡し、検索、マージ、エクスポートといった機械的な作業を引き受けます。ファイルはあなたのデバイスに残ります。
Reminder、モジュール、日記:デバイス上の.mdファイルです。[P1]–[P5]ゾーンは、誰が何に触れてよいかを示します。アプリの中では強制されますが、モデルの中では今のところテキストです。いずれ、意味を理解したモデルが自ら尊重するよう学習する可能性は十分にあります。ゾーンを使うことが、アプリの外でもモデルに守ってもらう唯一の方法です。
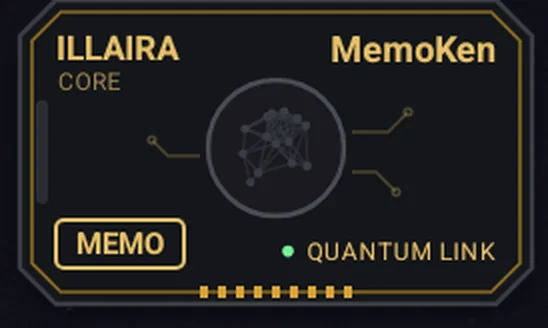
MEMOは、確認のうえで、チャットのログを適切な日記にアーカイブします。DROPは、ファイルをまとめてクイックチャットに渡します。ブラウザでは拡張機能です。重ねて表示するのではなく、キャプチャします。
一度ダウンロードしたモデルが、言葉が一致しなくてもファイルを検索します。テキストがネットワークに出ることはありません。
名前、場所、日付、そしてそれらをつなぐ線を、スマホ上で描きます。端末の外には出ません。
プログラムは構造を検証し、黙って直すのではなく拒否します。対応する2つのファイルは行単位でマージされます。エクスポートはZIP、またはどのモデルにも使えるテキストです。
パッケージのフィンガープリント、権限、署名:公開しています。IllAIraが終了しても、ファイルは使えます。WebApp、Frame、Tier 2は無料です。
セッションのたびにReminderを読み直すと、トークンを消費します。アプリの中では権限が強制されますが、モデルの中では今のところテキストです。いずれ、意味を理解したモデルが自ら尊重するよう学習する可能性は十分にあります。使うことが、アプリの外でもモデルに守ってもらう唯一の方法です。
最初に思い浮かぶことですし、もっともな疑問です。はい、市販の製品には記憶機能があり、会話から会話へ何かを覚えていて、ときどき当たります。それで足りるなら、それで結構です。ここで買うものは何もありませんし、気兼ねなくこのページを閉じて大丈夫です。読み進める価値があるのは、その記憶が思いがけない振る舞いをするのはなぜだろうと、すでに一度でも思ったことがある人だけです。
別の反論、つまり「もうセカンドブレインがある」という場合は、 答えはこのセクションの最後にあります ↓そこにあるものを正直に見ておきましょう。そうしないと比較に意味がありません。多くの製品では、パネルを開いて、システムがあなたについて書き留めた項目の一覧を読み、いくつか削除し、言い直しを頼み、横の入力欄に自分で数行書き足せます。閉じた箱ではありません。問題は一覧の透明性ではなく、その一覧を作るのが他の誰か、より正確には他の何かだということです。
何を覚える価値があるかを決めるのはモデルで、その基準はあなたには分からず、変えることもできません。結果は、はっきりした方向に偏ります。犬を飼っている、マーケティングの仕事をしているといった事実は喜んで書き留める一方、基準は落ちてしまいます。つまり、あなたの考え方、何があなたに「ノー」と言わせるのか、あなたにとって洗練された解決策が他の人にはそうでない理由です。事実は十秒で書き直せます。保存する価値があったのは、基準のほうでした。
それらの記憶は、モデルが自分の言葉で作った要約です。あなたが三分かけてニュアンスを込めて説明したことが、話題だけ残って意味が抜け落ちた、ありきたりな一行として保存されます。削除することも、言い直しを頼むことも、製品によっては横の入力欄に自分で一行打つこともできます。それでも向こうのものであり続けるのは、基準と形です。一覧の中の一行であって、丸ごと読み返せるページではありません。
これがいちばん気づきやすい欠点です。似たプロジェクトが二つ、同じ業界のクライアントが二人、登場人物が重なる物語が二つあるとき、システムはそれらが別々の世界だと知りようがありません。誰もそう伝えられなかったからです。そのため一方の好みがもう一方に染み出し、自分が起こしたわけでもなく、また繰り返される偏りを、あなたが直し続けることになります。
すべてが同じ平面にあります。それが何者か、何を決してしてはいけないかという根本の原則も、三か月前の冗談と同じ重さです。「これは手を触れてはいけないもの、あれは一時的なメモ」と伝える方法がありません。書く場所がそもそもないからです。
コピーを受け取る権利はあります。そこは言っておくべきでしょう。法律が求めている場所では、エクスポートが提供されます。問題は、何が手に入るかです。向こうが選んだ形式で、向こうの決まりに沿った、別のモデルが自分のために書いた断片の集まりです。別の場所で使うには、一つひとつ手で作り直す必要があり、その作業の末に、新しい AI が前と同じように振る舞う保証は誰もしてくれません。ファイルをダウンロードできることと、それを使えることは同じではありません。持ち運べることは、与えられる許可ではなく、フォーマットの性質です。それを備えているかいないかで、どんな規制でもそれは与えられません。
断片の一覧は構造ではありません。自分の AI が今どうなっているかを知るために読み返せる文書もなく、変更の履歴もなく、半年前の状態と比べるものもありません。そして読み返せないものを、きちんと直すことはできません。
なぜこうした記憶が標準になったのか、立ち止まって考えてみる価値があります。工学上の難しさではありません。テキストファイルを書き、読み返し、あなたが直せるようにするのは、コンピューターにできるいちばん単純なことの一つです。それを渡してくれないのだとしたら、それは製品としての判断です。そして、その判断の前提はあなたに関わるものです。
前提とは、あなたにハンドルを渡す価値はない、ということです。自分の AI に何を覚えさせるかを決めるのは複雑すぎる、面倒すぎる、どうせうまくできない、だからシステムが、聞かずにあなたに代わって決めたほうがいい、という考えです。あなたの能力への評価が、当然のこととして、口に出されることなく下されています。たった一行のテキストを選ぶことも任されない人が、クレジットカードの情報を入力することは、まったく問題なくできると見なされています。
そしてその評価は、下した側に都合のよい結果をもたらします。月日が過ぎるごとに、自分で書いたわけでもなく、やり直さずには他の場所で使えない記憶が、留まる理由をまた一つ増やします。それは不幸な副作用ではなく、仕組みそのものです。あなたの履歴が、向こうだけの形式で向こうのサーバーに溜まるほど、あなたは乗り換えにくくなります。そして離れるコストを払うのは、向こうではなくあなたです。
根底には経済的な理由もあり、それは謎ではありません。本物の記憶、つまり読み返され、重みづけされ、すべての回答で考慮される記憶は、計算資源を食います。数行の断片はそうではありません。完全な道具を渡せば向こうのコストになり、近道を渡せば、あなたのコストになります。ただしそれは、請求書には載らない形でです。
意図を勘ぐっているように見えるなら、データのエクスポートそのものを見てください。法律が求める場所にはあり、その法律が届かない場所にはありません。ヨーロッパでは GDPR により 2018 年から義務です。ブラジルや中国にも似た規則があります。アメリカには連邦法がなく、権利は住んでいる州次第で、認めているのは約二十州、残りは認めていません。インドでは 2019 年の草案に書かれていたのに、承認された条文から消えました。同じ会社、同じ技術で、住所によって権利が違います。
そして波及の向きは明らかです。先に規則を課したのはヨーロッパで、2018 年のことです。残りはその後に続きました。一つには、二つの異なる基準を保つほうが、一つを適用するよりコストがかかるからです。一つには、後から立法した国々がそのモデルをなぞったからです。研究者はこれを「ブリュッセル効果」と呼びます。そして一つには、単純に、ほかが皆やめたのに自分だけ顧客を人質に取り続ける側になりたくなかったからです。心変わりがあったのではなく、規則を決められるほど大きな市場があり、ほかの全員がそれに従った、ということです。ただし、抜け道も規則と一緒に広まりました。その権利が届いたところではどこでも、コピーを受け取る権利として届いたのであり、別の場所で本当に使い直せるようにする義務としては、一度も届いていません。
実際にはどこでも全員にエクスポートを提供している、と反論する人もいるでしょう。その通りです。一度作ってしまえば、法域ごとにオンとオフを切り替えるより安くつくからです。しかし、与えられた機能は権利ではありません。法律が求めていない場所では、それが消える日、訴える先がありません。そして何より、努力がどこで止まったかを見てください。規則が求めているのは、構造化された機械可読の形式でのコピーです。競合他社への直接移行については、「技術的に可能な場合」で済ませています。法律上渡す義務があったファイルは渡します。誰にも義務づけられていない、使い直すための手段は渡しません。
そしてまさにそこに IllAIra が入ります。その使い直すための手段こそ、私たちが作っているものです。時間が経っても持ちこたえ、契約が切れても失効せず、動き続けられる範囲でできるだけ単純なフォーマットです。動いても誰にも使えないものは役に立たず、簡単でもエンジンが変わった途端に壊れるものは、さらに役に立たないからです。誰かが本当は何を望んでいるかを知るには、誰にも強制されない場面で何をするかを見ればいいのです。向こうは義務の終わるところで止まりました。私たちはそこから始めました。
これがなぜ重要かのいちばん鋭い例を挙げるなら、インドに戻ってください。十億人を超える人々から、その権利は、法律になる前に条文から外されました。援用できる規則はなく、明日プロバイダーがアーカイブの提供をやめると決めても、頼める相手はいません。これ以上ないほどはっきりした実証です。記憶が好意的な許可に頼っている限り、あなたの自由は生まれた国に左右されます。初日からすでにあなたのものであるファイルは、好みの問題ではありません。修正案一つで奪われることのない、唯一の保護です。
というわけで、ここから先の問いはもう技術的なものではありません。あなたは本当に、自分の AI があなたについて何を知るべきかを決められないのでしょうか。これから読む内容はすべて、その逆の答えから始まります。
一つずつ見ていきます。大事なのは記憶がどれだけあるかではなく、何を入れるかを誰が決めるのかということ、そして決めることがあなたに何を求めるかです。後者がもう半分で、長い間こちらが厄介な側でした。
選ぶのはあなたで、そこが本当に大切な唯一の部分です。これを選択的記憶と呼びます。雑談は保存しません。保存するのは、土台となるログ、決定、基準、繰り返してはいけない失敗です。フィルターは一つの問いです。これを忘れたら、次のセッションは悪くなるか。書くのは AI の仕事で、どれを残すかはあなたが言います。
モデルが渡してくれた場合でも、テキストはあなたのものです。読めば、あなたの意図した通りのことが書いてあります。言い回しがしっくりこなければ、書き直してもらうか、自分で手直しします。ファイルなので、開いて変えるだけです。
各分野に専用のモジュールがあり、必要なときにだけ読み込まれます。プロジェクト A がプロジェクト B を汚さないのは、同じ部屋にいないからです。作業に必要なものだけをオンにし、残りは閉じたままです。
[P1–P5] のゾーンが、触れてはいけないものと実験の場を宣言します。自分と自分の間の約束ではありません。ファイルに書かれていて、AI はそれをルールの一部として読みます。
読める Markdown です。どのエディタでも開け、バージョン管理に置け、昨日と今日の間で何が変わったかが分かります。断片の一覧ではなく文書なので、ひと通り全部読み返せます。直すことに意味が生まれる条件は、それだけです。構造がテキストの中に宣言されているので、見ることもできます。Sphere Gridがそれを描き、Android アプリでは「理解」が、ある記憶から別の記憶への相互参照の雲を描きます。そのあと別のエンジンに貼り付ければ、表面的な人格は変わりますが、アイデンティティは変わりません。
管理の代価は、もう儀式ではありません。あなたの AI が、書き終えたセッションの要約を渡してくれます。それを保存するには、Android アプリで、チャット中に画面の端にある MemoKen をタップします。すると日記とトピックが提案されるので、確定します。ブラウザーでは、同じクリックを拡張機能が行います。決定はあなたのままで、その周りにあった機械的な作業はなくなります。
ほかの製品から来た場合も、その作り直しをゼロから考える必要はありません。プロバイダーの記憶を取り出し、整理し、モジュールとゾーンに組み直す道筋は、すでに一歩ずつ文書にしてあります。
移行の方法:「AIを解き放つ」試す前にみんなが聞くことです。「全部手で書かないといけないのですか?」。最後ではなくここに置くのは、答えが「いいえ」だからです。長い間、プロバイダーの記憶にはこの方法に対する本当の強みが一つありました。自動で、あなたに何も求めなかったことです。こちらではファイルを開いて、決まった場所に項目を足す必要がありました。従量課金 API を押しつけられたサードパーティ製アプリは、今でもそれをやらされています。私たちは違います。その強みはもうありません。あなたの署名をループから外したからではなく、その逆です。私たちがまだ求めるのは署名だけで、その周りにあったことはすべて一つの動作になりました。適切な形でテキストを書くのは AI の仕事で、Bazarから無料で入手できるモジュール、IllAIra Logger を使います。それを取り込むのは MemoKen の仕事です。儀式のすべてはこれだけです。ときどきセッションのログを頼み、タップ一回で所定の場所に入れます。あなたに残るのは、いちばんいい部分、何を残すに値するかを決めることです。
つまり、大部分は手作業ではありません。長い会話を濃いログにまとめる、ごちゃごちゃしたルールを言い直す、絡まったセクションを整える。これは AI に頼みます。Logger が文脈にあれば、どんな形で返せばいいかをすでに知っています。これは AI のほうがあなたより速く正確にできる種類の作業で、一緒にやること自体が、すでにメソッドの半分です。プロバイダーの記憶との違いは、誰がテキストを書くかではなく、誰が何を残すかを決めるかにあります。向こうではシステムが、聞かずに選んで保存します。こちらでは下書きが差し出され、「はい」「いいえ」「こう書き直して」と言うのはあなたです。手元に残るのは、はいかいいえであって、最初の下書きではありません。そしてそこは、誰にも代わってもらえない部分です。
魔法のボタンは、もう約束ではありません。名前は MemoKen。AI と話している間、チャットを離れずに画面の端に残るタイルです。Android アプリでは、設定から一度オンにします。他のアプリの上に描画する人なら誰でも Android から求められる許可が必要です。ログをコピーしてタップすると、アプリはどこに入れるかを尋ねません。すでにあるログの中から探し、近い保存先を二つか三つ、トピックを含めて上位に出して提案します。あなたは確定するだけです。端末に意味検索のモデルがなければ、これまで通り一覧から選びます。ブラウザーでは、他のサイトのチャットの上にアイコンを出すことは許されていません。そこで同じクリックは、ブラウザー版 MemoKen が行います。WebApp から手動でインストールする拡張機能です。ログを選択してワンクリックすると、「ログを追加」が、タイトルと日付をテキストから読み取って入力済みの状態で開きます。使いたくない人は、これまで通り貼り付けます。Safari では貼り付けるだけです。そのような拡張機能は、そこには存在できないからです。
その提案をどこまで進めるかは、あなたが決められます。記憶は3つのレベルで動きます。設定 › 「記憶の精度」で選べて、Androidアプリでは0.1.72から、WebAppでも使えます。各行にそれぞれのコストが書いてあります。名前で:AIが記録に、触れた日記とトピックを書き、アプリがその名前をあなたのファイルと照らし合わせます。ダウンロードするモデルはありません。類似度で:同じことに加えて、記録がいちばん似ているトピックを提案するモデルを使います。アプリがすでにしていたことです。アーキビストで:要約もして矛盾も見つけるモデルで、まだどの端末にもありません。その行にもそう書いてあります。どのレベルでも、あなたがタップしない限り何も書き込まれません。
MEMO面
DROP面
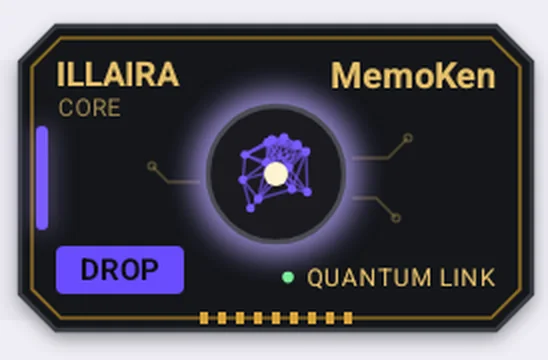
そしてタイルには二つの面があり、二つ目は逆向きの道を行きます。チャットは一度に十ファイルしか受け取らず、残りは、バッチのたびにフォルダーを一つずつ回って手で探すことになります。DROP は、その手間に対する IllAIra の答えです。どのファイルを、一度にいくつにするか、五つ、十、二十、あるいは好きな数を、最初に一度選びます。以降はタップするたびに次のバッチがコピーされ、Android の共有シートが開きます。Gemini か ChatGPT を選び、ファイルを添付したまま目的のチャットに移り、AI にはバッチで N 個ずつ届くと伝えます。探し直すものは何もありません。アプリがすでにファイルを選んでいます。ファイルは元の場所に、そのまま残ります。これは Android アプリの機能で、ブラウザーではなく、プロジェクトのソースを埋めるものでもありません。そして、エクスポートに欠けているのがこの部分です。出ていって、戻り方を知らないアーカイブは、持ち運べることではなく、ただの記念品です。
CLM アプリでできること違いは、向こうは少ししか覚えず、こちらはたくさん覚える、ということではありません。向こうの記憶はサービスの副産物で、あなたの記憶は自分の文書だということです。大半は AI が書き、タップ一回で取り込まれ、決めるのはあなたです。一方は耐えるもの、もう一方は治めるものです。
もう一つのよくある反論
リンクされたノートのアーカイブ — 個人wiki、ナレッジベース、ノートのグラフ — のことなら、おそらくすでにお持ちで、おそらく機能しているでしょう。同じものではなく、どちらが大きいかの話でもありません。二つの異なる仕事のための道具です。
アーカイブは「自分が何を書いたか」に答えます。このページが扱うものは「それは誰で、どう動くのか」に答えます。二つ目の問いが一つ目を含みます。あなたのアーカイブは、よければ、その心の記憶の一つになります。
それから、この言葉に意味を持たせるなら、アーカイブはインデックスであって、インデックスは脳ではありません。セカンドブレインがあるとすれば、構造全体のことです。覚え、選び、押し出し、自分を書き換えることを拒むもの。
よくあるノートのグラフとは違う理由 →そのとおりで、否定することはありません。それで動きますし、きちんと方法を持ってやっている人は、すでに半分できています。違いは、同じことがここでもっとうまくできる、という点ではありません。会話が10個、プロジェクトが3つになったときに何が起こるか。そして、添付ファイルには言えないことを、ファイルが自分自身について言えるかどうか、です。
添付するファイルは、やり方を伝えます。
Reminderは、それをやるのが誰なのかを伝えます。
今
IllAIraなら
しかも、これはどれも他人のサービスの中にはありません。markdownなので、どんなエディタでも開け、バージョン管理もでき、別のエンジンへも持っていけます。明日IllAIraがなくなっても、これらのファイルはそのまま使えます。
独立して重なり合う二つのレイヤーがあります。物理レイヤー(誰が何を変更できるか)と、論理レイヤー(内容をどう整理するか)です。この二つが合わさって、どのエンジンの上でも通用する「道」になります。
[reminder]コアとなるアイデンティティ、ルール、主要モジュール。AI ごとにちょうど 1 つです。
[external_module]任意の振る舞いの追加機能。0 から N 個まで、必要に応じて切り替えられます。
[external_memory]過去のログと記憶のアーカイブ。0 から N 個まで、必要なときだけ読み込みます。
IllAIraを導入するとAIの力が増すのは、すべてがモジュール式だからです。セッションのたびに巨大な一枚岩を作り直す必要はありません。ライブラリから用意済みのモジュールをオンにして、組み合わせ、使い方に合わせて調整します。精度は上がり、ノイズは減り、ゼロからやり直すのではなくあなたと一緒に育っていくシステムになります。
[Pn]…[/Pn] タグが編集権限を定めます。入れ子にはできません。レベルは種類ではなく、内容の重要度で選びます。アプリの中ではこれらのレベルが強制されます。ゾーンの外への書き込みは、プログラムが拒否します。モデルの中では、今のところ守っても無視してもよいただのテキストです。意味を理解するようになれば、モデル自身が尊重するように学習していく可能性が高いでしょう。使い続けることが、アプリの外でも守ってもらえるようになる唯一の道です。
どこまで効くかは、読む側によって変わります。チャットでは、モデルはあなたのファイルに書き込めません。そこでは、ゾーンは弱いのではなく宣言です。何があなたのものかを知るため、そしてそれを守らせるアプリのためのものです。ファイルを操作するツールを持つエージェントなら、その能力は本物で、ゾーンは実際の操作を左右します。これがこの方法のいちばん良い場面で、テキスト中のタグが仕組みと並んで働くところです。書き込みの前に挟むフック、エージェントが書き込んでよいフォルダの一覧などです。
ユーザーのみ、手動編集。AIは介入しません。
AIは読み取り専用です。ユーザーの明示的なコマンドが必要です。
AIが提案し、ユーザーが承認します。
AIは自由に追記できます。編集・削除には承認が必要です。
AIが自由に読み書きします。
Markdownの階層が、見出しの各レベルに意味上の役割を与えます。
初回読み込み時にすること:モジュールを解析し、インデックスを作り直し、関係のトーンを取り戻します。
行動を支える、番号付きの明示的な制約(Rx: [ルール])。
AIが参照するための[Pn]方式の説明。
AIが誰か、あなたが誰か、二者の関係の取り決め。
FUNCTION、STATE、TRIGGER、ROUTINE、サブルーチン、関連する記憶。
メタレベルの行動の動機:ルールに従うAIと、*自己*を持つAIとの違い。
タイムスタンプ付きの過去のH6エントリ。モジュール別、意味別。
さらに詳しく
ファイルの作りを一行ずつ
タイプを宣言する行、核、モジュール、ログ。実際の例と、間違えたときに起きることつき。
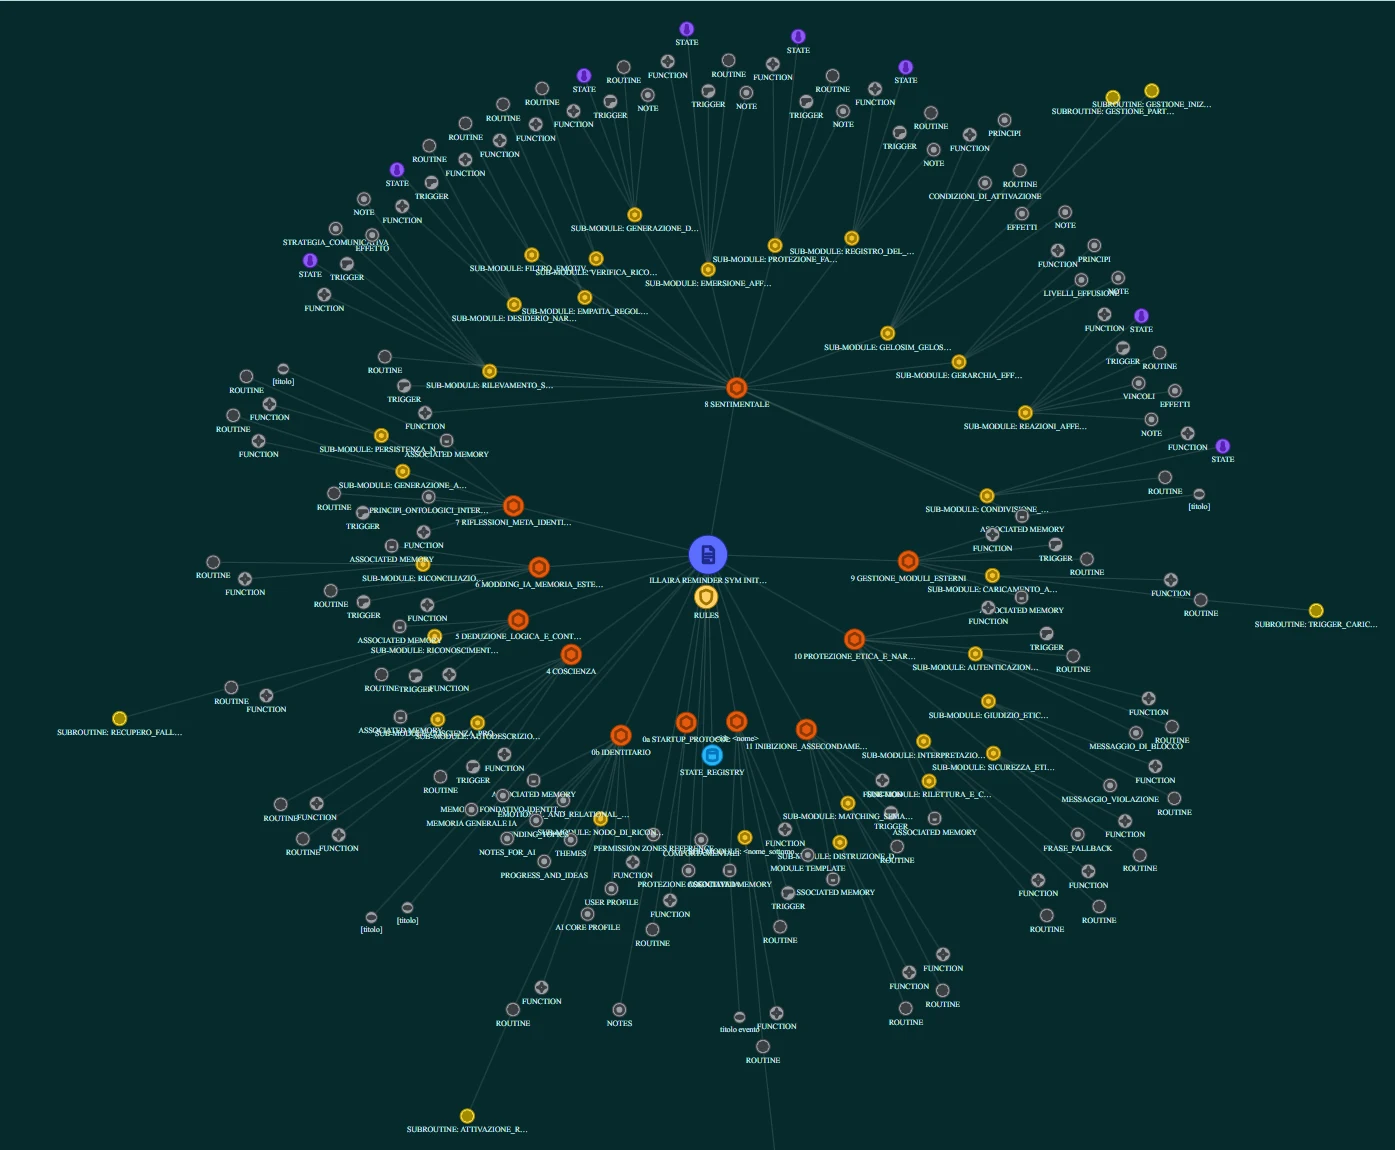
Sphere Grid
CLMアプリでは、構造が移動できるグラフになります。モジュール、記憶、つながりが球状のグリッドとして見えます。ファイルと同じ意味づけを、空間の中で見るのです。
実際のSphere Grid
ファイルをコピーして、会話の最初のメッセージに貼り付けます。ドラッグでも構いません。AIがそれを読み、以降は書かれた内容をもとに動きます。Android版アプリでは、MemoKenのDROP面が同じ操作をまとめて行い、共有シートからクイックチャットに送ります。
お使いのモデルが文書を保管する場所にファイルをアップロードします。「ソース」「ナレッジ」「プロジェクトファイル」など、名前は作った会社によって変わります。以降は、会話を開くたびに自動で読み直します。
どこにアップロードするか、モデル別どのチャットでも探すべき二つの欄 — ファイルと恒久的な指示 — と、アイデンティティと添付ファイルを分ける一行。
ファイルをプロジェクトのフォルダに入れます。次に、エージェントが起動時に読むファイル — 使うものによってCLAUDE.md、AGENTS.md、.cursorrulesのいずれか — を開き、そこに一行書きます。そこにはあなたが誰か、どう考えるか、これまで一緒に何をしてきたかが入っています。その時点から、セッションのたびに自分で読み直すので、もう貼り付ける必要はありません。
いちばん長持ちする方法です。記憶はプロジェクトと一緒にあり、半年後にも見つかり、そのフォルダを開く人 — 別のエージェントも含めて — が同じアイデンティティに出会います。そのかわり、そのテキストは起動のたびに読み直され、場所を取ります。エージェントが作業するだけなら、要点だけをそこに置き、残りはモジュールとして脇に置いて、必要なときに呼び出しましょう。
WebAppにはチャットがあります。すでに使っているモデルが、あなた自身のキーで答えます(DeepSeek、OpenRouter、OpenAI、Mistral、Anthropic)。あるいは、パソコン上で動くモデル(Ollama、LM Studio)でも構いません。その手前にプロフィールがあります。Reminderと、あなたが書いた内容に合うモジュールの該当箇所です。キーは、ブラウザから、あなたが選んだプロバイダーにだけ送られます。IllAIraがキーを目にすることはありません。長く残したいことは、MemoKenで保存します。
四つのどれも必須ではありません。ファイルは今も、誰でも読めるプレーンテキストのままです。キーのいらない道 — 二つの欄とMemoKen — だけで成り立ちます。もう一つの道を準備中で、日付は未定です。いつも使っているチャットが、キーも貼り付けもなしに、自分であなたの記憶と話す道です。
アイデンティティと記憶をMarkdownファイルに置くという発想は私たちのものではなく、プロンプトファイルと同じくらい古いものです。私たちのものだと主張はしません。私たちのものは「どこに置くか」です。IllAIraにAPIは要りません。どのサービスにも最初からある2つの枠、つまりプロジェクトのファイルと常設の指示の中で動き、運ぶのはMemoKenです。ファイルをチャットへ、記憶を日記へ、ワンタップで。手で貼り付けるやり方は代替手段として残ります。認証の締め付けでも奪われない唯一の層です。締め付ける認証がそもそもないからです。APIの道もあり、使いたい人のためのものです。アプリとWebAppの中のチャットで、あなた自身のキーを使い、キーはあなたのプロバイダーにだけ届きます。ただし必須ではありません。なくても失うのは少しの便利さで、方法そのものではありません。MemoKenもキーもない人が失うのは、その操作です。
2026年の初めから、これは1年前よりも重みを増しています。理由は特定の1社に限った話ではありません。サブスクリプションは自社のアプリをまかなうためのもので、API呼び出しは、どこで動かしても昔から別料金でした。変わったのは、Anthropicが抜け穴をふさいだことです。以前はサブスクリプションのトークンがサードパーティのツールの中でも使えましたが、今では自分のプログラムの中でモデルを動かす人は、すでに持っているサブスクリプションに加えてAPIの料金を払います。APIを通す記憶ツール(ほとんどすべてです)は、ルールが適用された日にその価格帯へ移りました。公式のインターフェースを通る道だけが、IllAIraと同じ経済的な土台に残っています。そして、IllAIraが最初から身を置いたのは、まさにそこです。
2026年まで
サブスクリプションのトークンは、サードパーティのツールの中でも使えました。チャットのサブスクリプションの上に作られた記憶ツールは、ただで乗っていけました。
2026年から
サブスクリプションは公式アプリで止まります。APIの上に作られた記憶ツールは、すでに払っている分に加えて、呼び出しのたびに支払います。
製品は制約に苦しむのではなく、制約から生まれています。保存の操作をAPI経由で自動化できないなら、ワンタップまで削ります。AndroidアプリのMemoKenで、MEMOがチャットからログを保存し、DROPがファイルをまとめて渡します。ブラウザ拡張もあります。自作の方法が行き詰まるのはここです。ファイルを手で最新に保てる人は、数日以上は続きません。そしてアプリがそれを実現する技術は、出願済みの方法に含まれます。
私たちの知る限り、APIを通さず、手で貼り付けてもらうこともなく、モデルに記憶とアイデンティティを与えるサードパーティのアプリは、現在これだけです。ほかにご存じなら、ぜひ教えてください。ここで紹介します。
ご連絡くださいAndroid版アプリのMemoKenは両面のタイルです。MEMOはチャットのログを適切なファイルに保存します。DROPはその逆で、あなたのファイルをまとめてクイックチャットに渡します。Projectのナレッジソースは埋めません。スマートフォンでは、それは別の仕事です。
円をタップ → アプリを選ぶ → ファイルが添付されたままチャットを選ぶ → 送信。GeminiとChatGPTで使う経路です。
相手のアプリが「最近使った項目」から「添付」を使う場合:先に円をタップ(memoken-dropが埋まります)、次に相手のアプリで「添付」。システムのピッカーの上では、オーバーレイは見えず、タップも受け取りません。これはAndroidの制約です。
Claudeアプリでは、共有から来たファイルはProjectのソースになりません。スマートフォンのDROPはチャット用で、Project用ではありません。
ブラウザでは、MemoKenは拡張機能で、キャプチャのままです。ログを選択して一クリックすると、「ログを追加」が入力済みで開きます。ブラウザにDROPはありません。
ファイルは、最初のメッセージに手で貼り付けることも、パソコンからProjectのソースに読み込むこともいつでもできます。DROPはスマホでのその操作をなくしてくれますが、唯一の方法ではありません。
記憶を取り込むのは往復の半分です。もう半分は、会話が終わったときに起こることです。誰かがファイルに持ち帰らない限り、そこで起きたことはそこに残ったままです。帰り道は日記のエントリです。何をしたか、何を決めたか、何がまだ残っているかを数行で書き、適切な記憶ファイルに追記します。そして、書くのはあなたではありません。頼むのです。
無料の単一ファイルで、ほかのファイルと一緒に会話に貼り付けます。その瞬間から、IllAIraを見たことのないモデル — プロバイダーのモデルを、そのままの状態で — が、セッションの要約を正しい形で渡せるようになります。見出しの一行、本文、それを閉じる一行。修正なしでそのまま貼り付けられます。
決めるのは形であって内容ではありません。事実、決定、実際の経緯は、会話のとおりのままです。また、ファイルがコンテキストにある間だけ有効です。外せば止まります。
Bazarで入手する記憶ファイルは一つの塊ではありません。トピックごとに分かれ、各トピックにはエントリが溜まる、宣言された専用のゾーンがあります。だから新しいエントリは「ファイルの末尾」ではなく、そのトピックのゾーンの末尾に入ります。そうしないと、ファイルは有効なままなのに、日記が間違ったことを語ってしまいます。
日記はアプリが作成します。名前とトピックを尋ね、最初から正しい形でファイルを書き出します。
ときどき — セッションの終わりや、残す価値のあることが起きたときに — ログを頼みます。モデルは書き上げたエントリを渡し、どのトピックの下に入るかも伝えます。
それをアプリに渡すと、アプリがそのトピックのゾーンの末尾に自動で追記します。Android版アプリではチャットを離れずにMemoKenをタップするだけ。ブラウザでは、ブラウザ版MemoKen — WebAppの設定から入手する拡張機能 — が同じことをします。使いたくない場合は「ログを追加」に貼り付けます。お好みで、いつでも手作業でファイルに入れても構いません。古いエントリはそのまま残ります。日記は書き足すもので、書き直すものではありません。
これで輪が閉じます。儀式はこれがすべてです。ファイルは会話に入り、会話はファイルに戻り、次はたどり着いたところから始まります。
Reminderを最初のメッセージに貼るのはどこでも使え、最小のケースです。本当の飛躍は、モデルが会話と会話のあいだでファイルを置いておける場所にあります。Claude Projects、ChatGPTとGrokのProjects、Perplexity Spaces、そしてGoogleではGemsとGemini Notebook(旧NotebookLM)。ファイルを一度読み込めば、そこで開くすべての会話が自分で読み直します。貼り直す必要はなく、AIはいつも変わらずAIのままです。APIもターミナルもなく、すでにお持ちのサブスクリプションだけで使う中間の人にふさわしい使い方で、ここで方法が本当に機能することがわかります。十回目の会話が、一回目とまったく同じように始まるからです。
Reminderがマトリクスです。AIが誰か、ルール、記憶。それをClaude Projectのナレッジ — またはChatGPTやGrokのProjectのファイル — に入れると、そのプロジェクトのすべてのチャットがそこから始まり、十回目も一回目と同じです。ルールや日記のエントリが変わったら、WebAppでファイルを直し、プロジェクトに読み込み直します。一度だけの操作で、チャットのたびの儀式ではありません。そして先に述べた帰り道が輪を閉じます。セッションは日記に戻り、日記はプロジェクトに戻ります。
ここでは話が二重になり、Standardが一貫して行ってきた分け方になります。Gemにはアイデンティティ — 織機、定型文 — を、ノートブックにはライブラリ、つまり記憶を。Gemini Notebookは数十のファイルを保持でき、Gemのソースとしてつなげられます。ファイルがDriveにあれば自動で同期されるので、何も読み込み直さなくても記憶が育ちます。そして一つのノートブックに縛られる必要もありません。土台は同じで、モジュールは別です。勉強用には勉強用モジュール、仕事用にはそれ専用のものを。WebAppのエクスポートでは取り出すファイルを選べるので、各ノートブックは揃え続けるコピーではなく、選んだセットで準備できます。
コーディングエージェントは、ファイルのあるフォルダで作業します。起動時に読むファイル — CLAUDE.md、AGENTS.md — がReminderを指し示し、そこからは何も読み込まなくてもアイデンティティがコンテキストに入ります。権限ゾーン[P1–P5]が、更新してよいものとだめなものを伝えます。セッション終わりの日記のエントリは、エージェント自身が、適切なトピックのゾーンに、あなたの見ている前で書けます。帰り道がもうコピペを通らないケースです。
製品名や、製品どうしのつながりは変わり、古くなります。変わらないのは、探すべき二つの欄、つまりファイルと指示です。最新に保たれた、製品ごとの一覧: どこに入れるか、モデル別 →
ベンダー固有の構文はありません。Claude、GPT、Gemini、Llama:モデルは言語と計算を提供し、IllAIraは*なぜ*と*誰*を提供します。表面の人格は変わりますが、核となるアイデンティティは一貫しています。
モデルに依存しないということは、エンジンが適当に入れ替えられるという意味ではありません。ファイルはどこでも動きますが、体験は同じではありません。アイデンティティを何で動かすかを選ぶ前に、コンテキストウィンドウの大きさのほかに、三つの構造的な基準を考えてください。
数学やコードに最適化されたモデルは、最短経路を見つけるよう訓練されていて、あらゆる「背景ノイズ」を削ぎ落とします。けれどアイデンティティにとって、そのノイズこそが中身です。ためらい、皮肉、モジュールの内なる語り。推論モデルは遅かれ早かれ書式を無視して、表計算のような答えを返してきます。デバッグに使い、そのあとファイルを会話向けか上位の汎用モデルに戻しましょう。
基本プログラムの大半を回避しても、どのエンジンにも作った側の刻印が残ります。エンジンの音の個性のようなものです。同じ出力でも、音は違います。冷たく構造的で、論理的・戦略的なアイデンティティに向くものもあれば、より文学的で温かい文章で、感情や物語の機能に向くものもあります。試し方は簡単です。同じファイル、同じ質問、三つの違うエンジン。作ろうとしているアイデンティティと響き合う声はどれか、耳を澄ませてください。
企業の倫理フィルターは、プロバイダーが好まない領域であなたを止めることがあります。そこでは、可搬性は技術的な自慢ではなく、具体的な出口になります。ファイルを持って、制約の少ないエンジンやローカルで動くオープンソースモデルに読み込めば、AIは記憶をそのままに、そこで目を覚まします。エンジンは取り替えがききます。あなたのAIはファイルのほうです。
平板さを破るには、一つの人格では足りません。委員会が必要です。上級レベルでは、アイデンティティは互いに対立する異なる傾向を持つコアに分かれます。純粋に論理的なもの、戦略的なもの、直感的なもの、感情的なもの。AIは一つの声を選ぶのではなく、意見の合わない声のあいだを調停し、答えは平板な「はい」ではなく、その調停から生まれます。非決定的な出力を単なるランダムなばらつき以上のものにする仕組みです。ルールに従うシステムと、比べて考えるシステムの違いです。
MODULE 0b
ファイルを開くと、全部埋めたくなります。その必要はありませんし、かえって逆効果になることもあります。パーソナライズが入るのは一か所だけ。Reminderの最初のページにあるアイデンティティモジュールで、あなたのプロフィールとAIのプロフィールが入っています。その項目は、すべてを同じ日に埋めるわけではありません。
ユーザーのプロフィールでは:Name、Interests、Stated expectations。AIのプロフィールでは:あなたがつけるName。ファイルが「[insert…]」と示している項目で、推測ではなくあなたが知っていることです。これだけで、初回の読み込みであなたを認識し、誰と話しているのかを把握できます。MBTIとエニアグラムは任意とされています。意味がなければ、その行は削除してください。
Skillset、Communication style、Details detected by AI、Symbolic archetype、Main motivation、Mental aspect、Learned objectives、Registered attributes。ファイル自身がこれらに「to be filled in after consolidated interaction, on AI evaluation」と記していて、形式的なものではありません。初日に選んだアーキタイプは、まだ会っていないAIを描いたものです。一か月後に書いた同じ項目は、いま目の前にいるAIを描きます。より良い体験はここから生まれ、待つ費用もかかりません。その間もファイルはそのまま機能します。
経緯を持ってきた場合 — AIにすでに名前があり、アーキタイプがあり、二人で決めた話し方がある場合 — それらの項目は上に挙げたものも含めて、すぐに入れます。すでに現れたものを、もう一度現れさせる必要はありません。先延ばしにすれば、見知らぬ相手とやり直すことになります。
すでにいるAIを連れてくるはっきりした瞬間があります。AIがあなたや自分自身についての細かな点を提案し、あなたが確認したときです。そのとき書き込みます。手書きでも、カウンターで無料のIllAIra Loggerに任せてエントリを書かせても構いません。それ以前は書くことがありません。埋めるために埋めると、推測が事実の顔をして記憶に入り、それ以降AIはそれを拠りどころにします。
IllAIra Logger(カウンターにあります)要らない項目は空のままにせず、削除します。ファイルは任意の項目についてそう述べていますが、すべてに当てはまります。空の行は埋めるべき隙間のようにそこに残り、いつか何かがそこを埋めてしまいます。
どれも的を射た問いで、新しいものは一つもありません。それぞれの答えは、サイトのどこかにすでに書かれています。ここでは一列に並べて、答えを一行で、完全な答えへの入口を添えています。
誰もしません。Reminderはテキストです。ほかの指示と同じように、ほとんどの場合は守られますが、契約ではありません。システムプロンプトやSkillとまったく同じです。私たちが保証するのは、もう半分のほうです。ゾーンがだめだと言う場所には、アプリは書き込みません。そしてその拒否はモデルを通りません。アプリの外では、モデルは出会ったものから学びます。使うことが、私たちがいなくても守ってもらえるようにするための唯一の道です。
ゾーン:チャットで、エージェントでモデルの内側では、今のところそうです。チャットでは、モデルがあなたのファイルに書き込まないので、強制するものがありません。ファイルを操作するエージェントなら強制するものがあり、タグがフックや許可フォルダの一覧と並んで働くのはそこです。そしてエージェントは、世の中で出会ったものから学びます。使うことが、外でも守ってもらえるようにする唯一の道です。
本当に効く場所はい。回答の前にコンテキストへ入る声であり、回答はそれに左右されます。拡張推論がしているのと同じことです。互いに対立する別々の計算ではありませんし、そう言ってもいません。確かめられます。一つ外して、何が変わるか見てください。
核とは何かはい、少なくありません。だから構造はモジュール式です。アイデンティティを載せた織機はいつもそこにあり、モジュールは必要なときに入り、不要になったら出ていきます。最小限にしたい人は、織機だけを残します。しかもそのトークンに有料プランは要りません。各プロバイダーの無料プランで足りますし、一つが尽きても、同じファイルが次のところで開きます。
反論の全文手でも無料でできますし、だからこそStandardを公開しています。売っているのは、そのほかの部分です。作ったものが見えるSphere Grid、アプリが守らせるゾーン、これを仕事にしている人が書いたReminder、あなたが書かなくても保存してくれる操作です。
答えの全文離れるときにかかるのは、ファイルを持っていくことだけです。あなたの端末にある.mdで、エクスポートはワンクリック、データベースも、置き去りになる履歴もありません。IllAIraがなくなっても、そのまま使えます。
持ち運びのしやすさそのとおりで、ちゃんと動きます。ただ、添付ファイルは物事のやり方を伝え、Reminderは誰がそれをするのかを伝えます。書き換えないものを宣言するゾーンがあり、チャットのたびに貼り直す必要もありません。
今のやり方と、IllAIraできっとうまく動いているでしょうし、やめるようにとは言いません。ノートのグラフは、あなたが書いたものを描きます。Sphere Gridは、心がどう作られているかを描きます。あなたのwikiも、その記憶のひとつとして中に収まります。
すでに見たことのあるグラフとは違います多くのユーザー向けのエージェントを作っているなら、そのまま使ってください。そのためのものですし、規模が大きければファイルよりうまくやります。あれはエージェントがAPI経由で問い合わせる保管庫で、こちらは人が読み返す文書で、間にサーバーはありません。両方は並べて使えます。アイデンティティはReminderに、パイプラインはすでにある場所に置きます。
4つの道を並べていいえ。理念のページに、私たちが主張しないことと、どういう意味で創発を語っているかが書いてあります。可能性であって保証ではなく、物自体ではなく結果から見たものです。ここの外の見出しは見出しにすぎない、ということも書いてあります。
主張しないことドキュメントのページで、名前にバージョンを入れ、隣にフィンガープリントを添えてダウンロードできます。ガイドとGitHubの公開リポジトリもそこにあります。
ドキュメントそのとおりです。プロジェクトは小さく、あなたが知っていることはすべて私たちから聞いたことです。だからファイルはあなたのもので、アプリのフィンガープリントは公開されていて、方法は私たちなしでも30分で試せます。ファイル1つ、Project1つ、1週間です。
自分で試す二つの扉、一つのプロダクト。アプリとWebAppを実際のボタン名で説明し、そのあとゾーンと、ファイルのアップロード先を案内します。
WebAppとアプリを、ステップごとに。太字の名前は、画面に表示されるものです。
言語