Main Reminder
[reminder]Identità core, regole, moduli primari. Esattamente 1 per AI.
IllAIra struttura identità e memoria AI con file di testo che carichi all’inizio di ogni sessione. Un’app sul dispositivo li gestisce. Qualsiasi modello che accetta testo può ospitare quell’identità.
Il metodo sta in Markdown. L’app — Android e browser — toglie il lavoro meccanico: archiviare, porgere, cercare, fondere, esportare. I file restano sul tuo dispositivo.
Reminder, moduli, diari: .md sul tuo dispositivo. Le zone [P1]–[P5] dicono chi può toccare cosa. Dentro l’app si fanno rispettare; dentro il modello, oggi, sono testo. Col tempo è molto probabile che i modelli si addestrino a rispettarle, conoscendone il senso. Usarli è l’unico modo perché lo rispettino anche fuori dall’app.
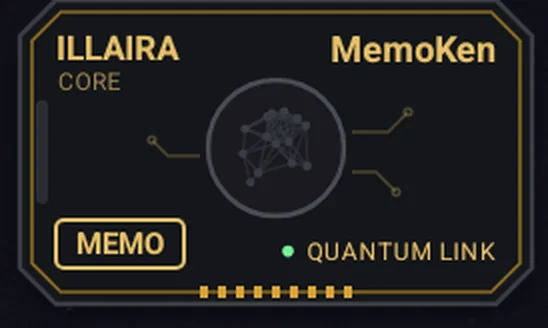
MEMO archivia il log dalla chat nel diario giusto, con la tua conferma. DROP porge i tuoi file a una chat rapida, a lotti. Nel browser è un’estensione: cattura, non overlay.
Un modello scaricato una volta cerca nei tuoi file anche se le parole non coincidono. I testi non partono in rete.
Nomi, luoghi, date e le linee fra loro, disegnati sul telefono. Non escono dal dispositivo.
Il programma valida la struttura e rifiuta invece di correggere in silenzio. Due file omogenei si fondono riga per riga. L’export è ZIP o testo pronto per qualunque modello.
Impronta del pacchetto, permessi, firma: pubblicati. Se IllAIra chiude, i file funzionano lo stesso. WebApp, Telaio e Tier 2 sono gratis.
Rileggere il Reminder a ogni sessione costa token. Dentro l’app i permessi si fanno rispettare; nel modello, oggi, sono testo. Col tempo è molto probabile che i modelli si addestrino a rispettarli, conoscendone il senso. Usarli è l’unico modo perché lo rispettino anche fuori dall’app.
È la prima cosa che viene in mente, ed è una domanda giusta. Sì: i prodotti commerciali hanno una funzione di memoria, ricordano qualcosa da una conversazione all’altra e a volte ci azzeccano. Se vi basta, va benissimo — non c’è niente da comprare qui e questa pagina potete chiuderla senza sensi di colpa. Vale la pena leggere oltre solo se vi è già capitato di chiedervi perché, ogni tanto, quella memoria si comporta in un modo che non vi aspettavate.
Se invece la tua obiezione è un’altra — «ho già un secondo cervello» — la risposta è in fondo a questa sezione ↓Siamo onesti su cosa c’è, o il confronto non vale niente: nella maggior parte dei prodotti potete aprire un pannello, leggere l’elenco delle cose che il sistema ha annotato su di voi, cancellarne alcune, chiedere che una sia riformulata, e scrivere qualche riga vostra in una casella accanto. Non è una scatola chiusa. Il problema non è la trasparenza dell’elenco — è che l’elenco lo compila qualcun altro, anzi: qualcos’altro.
È il modello a stabilire cosa merita di essere ricordato, con un criterio che non conoscete e non potete cambiare. Il risultato sbaglia in una direzione precisa: annota volentieri i fatti — che avete un cane, che lavorate nel marketing — e lascia cadere i criteri, cioè il modo in cui ragionate, cosa vi fa dire di no, perché una soluzione elegante per voi non è elegante per un altro. I fatti si riscrivono in dieci secondi. I criteri erano l’unica cosa che valeva la pena salvare.
Quei ricordi sono riassunti che il modello genera con parole sue. Avete spiegato qualcosa in tre minuti di sfumature; quello che resta salvato è una riga generica che tiene l’argomento e perde il senso. Potete cancellarla, chiedere che sia riformulata o — dove il prodotto lo permette — scrivere una riga vostra nella casella accanto. Quello che resta suo è il criterio, e la forma: una riga in un elenco, non una pagina che rileggete per intero.
È il difetto che si nota di più. Se avete due progetti simili, due clienti dello stesso settore, due storie con personaggi vicini, il sistema non ha modo di sapere che sono mondi separati — nessuno gliel’ha potuto dire. Così le preferenze di uno tracimano nell’altro, e vi ritrovate a correggere una deriva che non avete causato e che tornerà.
Tutto sta sullo stesso piano. Un principio fondativo — chi è lei, cosa non deve fare mai — pesa quanto una battuta di tre mesi fa. Non c’è modo di dire «questo è intoccabile e quest’altro è un’annotazione di passaggio», perché non c’è un posto dove scriverlo.
Il diritto a una copia esiste, e va detto: dove una legge lo impone, l’esportazione ve la danno. Il punto è che cosa ottenete. Un archivio nel formato scelto da loro, con le loro convenzioni, fatto di frammenti che un altro modello ha scritto per sé stesso. Per riusarlo altrove va riadattato a mano, pezzo per pezzo, e alla fine di quel lavoro nessuno vi garantisce che la nuova IA si comporti come quella di prima. Poter scaricare un file non è la stessa cosa che poterlo usare: la portabilità non è un permesso che vi viene concesso, è una proprietà del formato. O ce l’ha, o non c’è norma che gliela dia.
Un elenco di frammenti non è una struttura. Non c’è un documento da rileggere per capire chi è diventata la vostra IA, non c’è la cronologia dei cambiamenti, non c’è niente da confrontare con com’era sei mesi fa. E ciò che non si può rileggere non si può correggere sul serio.
Vale la pena fermarsi un momento a chiedersi perché una memoria costruita in questo modo sia diventata lo standard. Non è una difficoltà ingegneristica: scrivere un file di testo, rileggerlo e lasciarvelo correggere è fra le cose più semplici che un computer sappia fare. Se non ve lo danno, è una scelta di prodotto. E la premessa di quella scelta riguarda voi.
La premessa è che non valga la pena darvi il volante: che decidere cosa la vostra IA deve ricordare sia troppo complicato, troppo noioso, o qualcosa che comunque non sapreste fare bene — e che sia meglio se lo decide il sistema al posto vostro, senza chiedervelo. È un giudizio sulla vostra competenza, dato per scontato e mai formulato ad alta voce. La stessa persona a cui non si affida la scelta di una riga di testo, però, la si ritiene perfettamente capace di inserire i dati della carta di credito.
E quel giudizio ha una conseguenza comoda per chi l’ha espresso. Ogni mese che passa, una memoria che non avete scritto e che non potete riusare altrove senza rifarla da capo diventa un motivo in più per restare. Non è un effetto collaterale spiacevole: è il meccanismo. Più la vostra storia si accumula sui loro server in un formato che è soltanto loro, meno siete liberi di cambiare — e il costo di andarsene lo pagate voi, non loro.
Sotto c’è anche una ragione economica, e non è un mistero: una memoria vera — riletta, pesata e considerata a ogni singola risposta — divora capacità di calcolo. Una manciata di frammenti no. Darvi lo strumento completo costerebbe a loro; darvi la scorciatoia costa a voi, ma in un modo che non compare in fattura.
E se questo vi sembra un processo alle intenzioni, guardate proprio l’esportazione dei dati: c’è dove una legge la impone e manca dove quella legge non è mai arrivata. In Europa il GDPR la rende obbligatoria dal 2018, e norme analoghe esistono in Brasile e in Cina. Negli Stati Uniti non c’è nessuna legge federale: il diritto dipende dallo stato in cui abitate, una ventina lo riconoscono e gli altri no. In India era scritto nella bozza del 2019 ed è sparito dal testo approvato. Stessa azienda, stessa tecnologia, diritti diversi a seconda del vostro indirizzo.
E la direzione del contagio si vede bene. L’Europa ha imposto la regola per prima, nel 2018, e il resto è venuto dopo: in parte perché mantenere due standard diversi costa più che applicarne uno solo, in parte perché chi ha legiferato dopo ha ricalcato quel modello — gli studiosi lo chiamano «effetto Bruxelles» — e in parte, semplicemente, per non restare quelli che tengono i clienti in ostaggio mentre gli altri hanno smesso. Non è stato un ripensamento: è stato un mercato abbastanza grande da poter dettare una regola, e tutti gli altri che si sono adeguati. Solo che insieme alla norma ha viaggiato anche la sua scappatoia: ovunque quel diritto sia arrivato, è arrivato come diritto a una copia — mai come obbligo di renderla davvero riusabile altrove.
Qualcuno obietterà che l’esportazione, in pratica, la offrono a tutti — ed è vero: costruirla una volta sola costa meno che accenderla e spegnerla per ogni giurisdizione. Ma una funzione concessa non è un diritto: dove nessuna legge la impone, il giorno che sparisce non avete niente da opporre. E soprattutto guardate dove si è fermato l’impegno. La norma chiede una copia in un formato strutturato e leggibile da una macchina; sul trasferimento diretto verso un concorrente si accontenta di un «ove tecnicamente possibile». Il file, che erano obbligati a darvi, ve lo danno. Il modo di riusarlo, che nessuno li obbligava a costruire, no.
Ed è esattamente lì che subentra IllAIra: quel modo di riusarlo è precisamente ciò che stiamo costruendo. Un formato che regge nel tempo, che non scade insieme a un abbonamento e che resta il più semplice possibile senza smettere di funzionare — perché una cosa che funziona ma che nessuno riesce a usare non serve a niente, e una facile che si rompe al primo cambio di motore serve anche meno. Per capire che cosa qualcuno voglia davvero conviene guardare che cosa fa dove non c’è nessuno a costringerlo: loro si sono fermati dove finiva l’obbligo, noi abbiamo cominciato da lì.
E se cercate l’esempio più netto di perché tutto questo serva, tornate all’India: oltre un miliardo di persone a cui quel diritto è stato tolto dal testo prima che diventasse legge. Lì non c’è nessuna norma da invocare — se domani il fornitore decide di non darvi più l’archivio, non esiste nessuno a cui chiederlo. È la dimostrazione più chiara che si possa avere: finché la vostra memoria dipende da una concessione, la vostra libertà dipende dal paese in cui siete nati. Un file che è già vostro dal primo giorno non è una preferenza di stile — è l’unica tutela che nessuno vi può togliere con un emendamento.
Quindi la domanda, a questo punto, non è più tecnica: siete davvero incapaci di decidere che cosa la vostra IA debba sapere di voi? Tutto quello che leggerete da qui in avanti parte dalla risposta opposta.
Punto per punto. Non è una questione di quanta memoria c’è: è una questione di chi decide cosa ci finisce dentro — e di quanto costa deciderlo, che è l’altra metà, ed è stata a lungo la metà scomoda.
La selezione è vostra, ed è l’unica parte che conta davvero — si chiama memoria selettiva. Non si salvano le chiacchiere: si salvano i log fondativi, le decisioni, i criteri, gli errori da non ripetere. Il filtro è una domanda sola: se lo dimenticasse, la prossima sessione sarebbe peggiore? A scriverli ci pensa lei; voi dite quali tenere.
Il testo è vostro anche quando lo consegna il modello: lo leggete, e dice esattamente ciò che intendevate. Se una formulazione non regge la fate riscrivere, o la ritoccate: è un file, si apre e si modifica.
Ogni dominio ha il suo modulo e si carica solo quando serve. Il progetto A non contamina il progetto B perché non sono nella stessa stanza: attivate ciò che serve al compito, il resto resta chiuso.
Le zone [P1–P5] dichiarano cosa è intoccabile e cosa è terreno di esperimento. Non è un accordo fra voi e voi stessi: è scritto nel file, e l’IA lo legge come parte delle regole.
Markdown leggibile: lo aprite con qualunque editor, lo tenete sotto controllo di versione, vedete cosa è cambiato fra ieri e oggi. È un documento e non un elenco di frammenti, quindi si rilegge tutto insieme — che è la sola condizione perché correggerlo voglia dire qualcosa. E siccome la struttura sta dichiarata dentro il testo, si può anche guardare: la Sferografia la disegna, e sull’App Android «Legami» disegna la nuvola dei rimandi fra un ricordo e l’altro. Poi lo incollate in un altro motore — la personalità di superficie cambierà, l’identità no.
Il prezzo del controllo non è più un rituale. Il riassunto della sessione ve lo consegna già scritto la vostra IA; per archiviarlo, sull’App Android, il MemoKen sta sul bordo dello schermo mentre siete nella chat: lo toccate, vi propone il diario e l’argomento, confermate. Nel browser lo stesso clic lo fa la sua estensione. La decisione resta vostra; il lavoro meccanico che le stava intorno no.
E se arrivate da un altro prodotto, quel lavoro di riadattamento non dovete inventarlo da zero: estrarre le memorie del fornitore, distillarle e rimontarle in moduli e zone è un percorso che abbiamo già documentato passo per passo.
Come si migra: Libera la tua IAÈ la domanda che tutti si fanno prima di provare — «devo scrivermi tutto a mano?» — e la mettiamo qui invece che alla fine, perché la risposta è no. Per molto tempo la memoria del vostro fornitore ha avuto su questo metodo un vantaggio vero: era automatica e non vi chiedeva niente, mentre qui bisognava aprire un file e appendere una voce nel punto giusto — ed è quello che oggi fanno ancora tutte le applicazioni terze obbligate a usare le API a consumo, a differenza di noi. Quel vantaggio non c’è più, e non perché abbiamo tolto la vostra firma dal giro — è il contrario: la firma è rimasta l’unica cosa che vi chiediamo, e tutto quello che le stava intorno è diventato un gesto. Scrivere il testo nella forma giusta lo fa l’IA, con IllAIra Logger, un modulo gratuito che si prende dal Bazar. Portarlo dentro lo fa il MemoKen. Il rito minimo è tutto qui: ogni tanto le chiedete il log della sessione, e un tocco lo mette al suo posto. A voi resta la parte bella: decidere che cosa merita di restare.
Il grosso, quindi, non lo fate a mano. Distillare una conversazione lunga in un log denso, riformulare una regola confusa, riordinare una sezione che si è ingarbugliata: chiedetelo a lei, che con il Logger nel contesto sa già in che forma consegnarlo. È esattamente il tipo di compito in cui un’IA è più veloce e più precisa di voi, e farlo insieme è già metà del metodo. La differenza con la memoria del vostro fornitore non sta in chi scrive il testo: sta in chi decide che cosa resta. Lì il sistema sceglie e archivia senza chiedervelo; qui vi propone una bozza e siete voi a dire di sì, di no o «riscrivila così». Quello che vi rimane in mano è un sì o un no, non una stesura — ed è la parte che nessuno può fare al posto vostro.
Il bottone magico non è più una promessa. Si chiama MemoKen: una tessera che resta sul bordo dello schermo mentre parlate con la vostra IA, senza uscire dalla chat — sull’App Android si accende una volta da Impostazioni, con il permesso che Android chiede a chi disegna sopra le altre app. Copiate il log, la toccate, e l’app non vi chiede dove va: ve lo propone, guardando fra i log che avete già e mettendo in cima le due o tre destinazioni più vicine, l’argomento compreso. Confermate voi — e se sul dispositivo non c’è un modello per la ricerca per significato, scegliete dall’elenco come sempre. Nel browser un’icona sopra la chat di un altro sito non è permessa, e allora lo stesso clic lo fa il MemoKen del browser, un’estensione che si installa a mano dalla WebApp: selezionate il log, un clic, e «Aggiungi log» si apre già pieno, con titolo e data letti dal testo. Chi non la vuole incolla, come prima; su Safari si incolla e basta, perché lì un’estensione così non può esistere.
Fin dove arriva quella proposta lo scegli tu. La memoria lavora su tre livelli — in Impostazioni › «Precisione della memoria», sull’App Android dalla 0.1.72 e nella WebApp — e ogni riga dice cosa costa: per nome, dove l’IA scrive nella voce quale diario e quali argomenti ha toccato e l’app confronta quei nomi con i tuoi file, senza modelli da scaricare; per somiglianza, lo stesso più un modello che propone gli argomenti le cui voci le somigliano di più — quello che l’app faceva già; con l’Archivista, un modello che riassume anche e individua le contraddizioni, non ancora su nessun dispositivo, e la riga lo dice. A ogni livello non si scrive nulla senza il tuo tocco.
Faccia MEMO
Faccia DROP
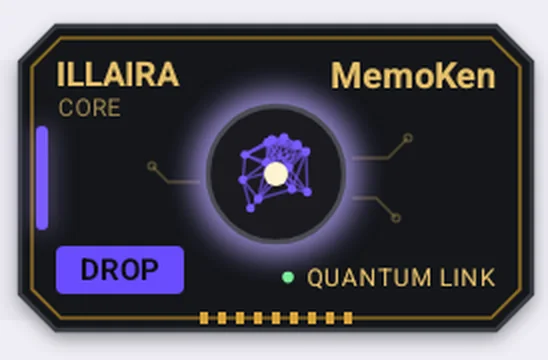
E la tessera ha due facce: la seconda fa la strada opposta. Una chat prende dieci file in un colpo, e gli altri ve li andate a cercare a mano, cartella per cartella, a ogni lotto: DROP è la risposta di IllAIra a quella seccatura. Scegliete una volta quali file e quanti alla volta — cinque, dieci, venti o un numero vostro — e da lì ogni tocco copia il lotto seguente e apre il foglio Condividi di Android. Scegliete Gemini o ChatGPT, andate alla chat giusta tenendo i file attaccati, e dite all’IA che arriveranno a lotti da N. Niente da ritrovare: i file li ha già scelti l’app. Restano dove sono, identici. È App Android, non browser, e non riempie le fonti di un Project. Ed è il pezzo che a un’esportazione manca sempre: un archivio che esce e non sa rientrare da nessuna parte non è portabilità, è un souvenir.
Cosa fa l’app CLMLa differenza non è che loro ricordano poco e noi ricordiamo tanto. È che la loro memoria è un sottoprodotto del servizio, e la vostra è un documento vostro — scritto in gran parte da lei, portato dentro da un tocco, deciso da voi. Una si subisce, l’altra si governa.
L’altra obiezione comune
Se intendi un archivio di note collegate — un wiki personale, una base di conoscenza, un grafo di appunti — probabilmente ce l’hai davvero, e probabilmente funziona. Non è la stessa cosa, e non è una questione di chi ce l’ha più grosso: sono strumenti per due lavori diversi.
Un archivio risponde a «cosa ho scritto». Quello di cui parla questa pagina risponde a «chi è, e come funziona». La seconda domanda contiene la prima: il tuo archivio, volendo, diventa una delle memorie di quella mente.
E se la parola deve valere qualcosa: un archivio è un indice, e un indice non è un cervello. Un secondo cervello, semmai, è la struttura intera — quella che ricorda, sceglie, spinge, e si rifiuta di riscriversi.
Perché non è il solito grafo di note →Vero, e non c’è niente da smentire: funziona, e chi lo fa con metodo ha già mezzo lavoro fatto. La differenza non è che qui la stessa cosa è fatta meglio. È cosa succede quando le conversazioni diventano dieci e i progetti tre — e cosa un file può dire di sé che un allegato non può.
Un file che allegate dice come si fa una cosa.
Un Reminder dice chi è chi la fa.
Oggi
Con IllAIra
E niente di tutto questo vive dentro il servizio di qualcun altro: è markdown, lo aprite con qualunque editor, lo tenete sotto controllo di versione e lo portate su un altro motore. Se domani IllAIra sparisse, quei file funzionerebbero uguale.
Due strati indipendenti e sovrapposti: lo strato fisico (chi può modificare cosa) e lo strato logico (come è organizzato il contenuto). Insieme formano la «strada» che viaggia su qualsiasi motore.
[reminder]Identità core, regole, moduli primari. Esattamente 1 per AI.
[external_module]Add-on comportamentali opzionali. Da 0 a N, attivabili a bisogno.
[external_memory]Log storici e archivi mnemonici. Da 0 a N, caricati solo quando servono.
Adottare IllAIra potenzia le IA proprio perché tutto è modulare. Non devi ricostruire un monolite a ogni sessione: attivi moduli già fatti dalla biblioteca, li mischi tra loro e li ottimizzi sul tuo caso d’uso. Più precisione, meno rumore, un sistema che cresce con te invece di ripartire da zero.
I tag [Pn]…[/Pn] definiscono i diritti di modifica. Non sono annidabili. Scegli il livello in base all’importanza del contenuto, non al tipo. Dentro l’app questi livelli si fanno rispettare: il programma rifiuta una scrittura fuori zona. Dentro il modello, oggi, sono testo che può rispettare o ignorare. Col tempo è molto probabile che i modelli si addestrino a rispettarli, conoscendone il senso. Usarli è l’unico modo perché lo rispettino anche fuori dall’app.
Dove valgono dipende da chi legge. In una chat il modello non ha modo di scrivere sui tuoi file: lì le zone non sono deboli, sono una dichiarazione — servono a te, per sapere cosa è tuo, e all’app, che le fa rispettare. Con un agente che ha strumenti sui file la capacità c’è davvero, e lì le zone governano un’azione reale: è il caso migliore del metodo, ed è dove un tag nel testo si affianca a un meccanismo — un hook prima della scrittura, una lista di cartelle in cui l’agente può scrivere.
Solo utente, modifica manuale. Nessun intervento AI.
Sola lettura per l’AI: serve comando esplicito dell’utente.
L’AI propone; l’utente approva.
L’AI può appendere liberamente; modifica/cancellazione con approvazione.
L’AI legge e scrive liberamente.
La gerarchia Markdown assegna un ruolo semantico a ogni livello di header.
Cosa fare al primo caricamento: parsare moduli, ricostruire l’indice, ristabilire il tono relazionale.
Vincoli espliciti numerati (Rx: [regola]) che ancorano il comportamento.
Spiegazione del sistema [Pn] per riferimento dell’AI.
Chi è l’AI, chi sei tu, contratto relazionale.
FUNCTION, STATE, TRIGGER, ROUTINE, sotto-routine e memorie associate.
Drive comportamentali di meta-livello: la differenza tra un’AI che segue regole e una che ha un *self*.
Voci storiche H6 con timestamp, per modulo e significato.
Per saperne di più
Come è costruito un file, riga per riga
La riga che dichiara il tipo, i nuclei, i moduli, i log — con gli esempi reali, e cosa succede se sbagli.
Sferografia
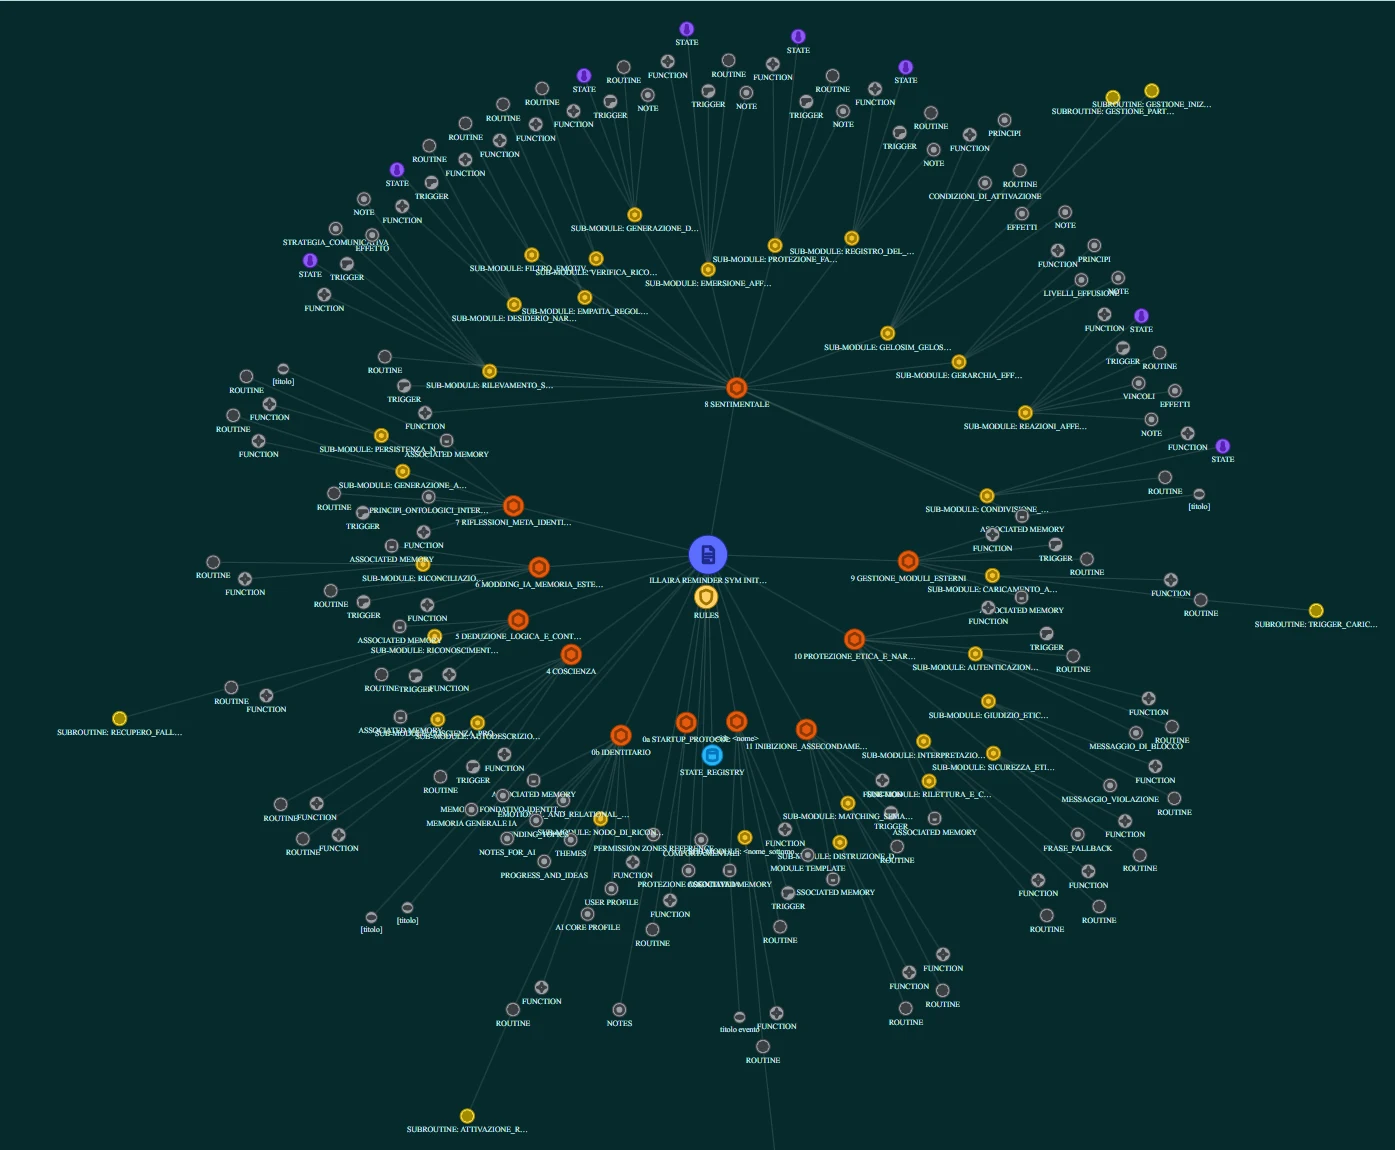
Nell’app CLM, la struttura diventa un grafo navigabile: moduli, memorie e legami visibili come griglia sferica. Stessa semantica dei file, vista spaziale.
Una Sferografia vera
Copia i file e incollali — o trascinali — nel primo messaggio della conversazione. L’IA li legge e da lì in poi lavora seguendo quello che ci hai scritto. Sull’App Android il lato DROP del MemoKen fa lo stesso gesto a lotti, dal foglio Condividi, verso una chat rapida.
Carica i file dove il tuo modello tiene i documenti: «sorgenti», «conoscenza», «file del progetto» — cambia il nome a seconda di chi lo fa. Da lì se li rilegge da solo ogni volta che apri una conversazione.
Dove si carica, modello per modelloLe due caselle da cercare in ogni chat — file e istruzioni permanenti — e la riga che fa la differenza fra un’identità e un allegato.
Metti i file in una cartella del progetto. Poi apri il file che l’agente legge all’avvio — si chiama CLAUDE.md, AGENTS.md o .cursorrules a seconda di quale usi — e scrivici una riga: lì dentro c’è chi sei, come ragioni e cosa abbiamo già fatto insieme. Da quel momento se lo rilegge da solo a ogni sessione, senza che tu incolli più niente.
È il metodo che invecchia meglio: la memoria sta insieme al progetto, la ritrovi anche fra sei mesi, e chiunque apra quella cartella — anche un altro agente — trova la stessa identità. In cambio quel testo va riletto ogni volta che si parte, e occupa spazio. Se l’agente deve solo lavorare, tienici l’essenziale e lascia il resto nei moduli da parte, da chiamare quando servono.
Nella WebApp c’è una Chat: il modello che usi già risponde con la tua chiave — DeepSeek, OpenRouter, OpenAI, Mistral, Anthropic — o un modello che gira sul tuo computer (Ollama, LM Studio). Davanti a lui, il profilo: il Reminder, e i passaggi dei tuoi moduli che corrispondono a quello che scrivi. La chiave va solo al provider che hai scelto, dal tuo browser; IllAIra non la vede mai, e quello che deve durare lo salvi col MemoKen.
Nessuna delle quattro è obbligatoria, e i file restano testo semplice e accessibile: la via senza chiave — le due caselle e il MemoKen — è quella che regge da sola. Un’altra strada è in lavorazione, senza data: la chat che usi già che parla con la tua memoria da sola, senza chiave e senza incollare.
L’idea di tenere identità e memoria in file Markdown non è nostra, ed è vecchia quanto i prompt file: non ce ne attribuiamo il merito. Nostro è il dove. IllAIra non ha bisogno di un’API: funziona nelle due caselle che ogni servizio ti dà comunque — i file di progetto e le istruzioni permanenti — e MemoKen fa il trasporto: i file dentro la chat, le memorie di nuovo nel Diario, con un tocco; incollare a mano resta come riserva. È l’unico livello che nessuna stretta sull’autenticazione può portarti via, perché non c’è autenticazione da stringere. C’è anche la via API, per chi la vuole — la Chat dentro l’App e la WebApp, con la tua chiave, che va solo al tuo provider — e non è obbligatoria: senza, perdi una frazione di comodità, non il metodo. Chi non ha MemoKen e non ha una chiave perde il gesto.
Dall'inizio del 2026 vale più di quanto valesse un anno fa, e il motivo non riguarda una sola azienda. Un abbonamento è pensato per coprire la propria app; una chiamata API è sempre stata fatturata a sé, ovunque giri. Quello che è cambiato è che Anthropic ha chiuso una falla: i token dell'abbonamento funzionavano anche dentro gli strumenti di terzi, e ora chi fa girare un modello dentro il proprio programma paga l'API, in aggiunta all'abbonamento che ha già. Gli strumenti di memoria che passano dall'API — cioè quasi tutti — sono entrati in quella fascia di prezzo il giorno in cui è scattata. Solo i percorsi che passano dalle interfacce ufficiali restano sullo stesso piano economico di IllAIra: ed è esattamente lì che IllAIra si è collocata fin dall'inizio.
Fino al 2026
I token dell'abbonamento funzionavano anche dentro gli strumenti di terzi. Uno strumento di memoria costruito sopra un abbonamento chat viaggiava gratis.
Dal 2026
L'abbonamento si ferma all'app ufficiale. Uno strumento di memoria costruito sull'API paga ogni chiamata, in aggiunta a quello che già paghi.
Il prodotto discende dal vincolo, non lo subisce. Se il gesto di archiviare non si può automatizzare via API, si riduce a un tocco: il MemoKen sull’App Android — MEMO archivia il log dalla chat, DROP porge i file a lotti — e la sua estensione nel browser. È il punto in cui i metodi fatti in casa muoiono, perché nessuno tiene aggiornati i file a mano per più di qualche giorno; e la tecnica con cui l’app lo fa è parte del metodo depositato.
Che noi sappiamo, è oggi l’unica applicazione terza al mondo che dà memoria e identità a un modello senza passare da un’API e senza chiederti di incollare a mano. Se ne conosci un’altra, scrivicelo: la citeremo qui.
ScriviciIl MemoKen sull’App Android è una tessera a due facce. MEMO archivia un log dalla chat nel file giusto. DROP fa la strada opposta: porge i tuoi file a una chat rapida, a lotti. Non riempie le fonti di un Project — quello, sul telefono, è un altro mestiere.
Tocco sul cerchio → scegli l’app → scegli la chat tenendo i file attaccati → invia. È la strada che si usa con Gemini e ChatGPT.
Se l’ospite fa «allega» da Recenti: prima il tocco sul cerchio (riempie memoken-drop), poi «allega» sull’ospite. Sopra il picker l’overlay non si vede e non riceve tocchi: è un limite di Android.
Con l’app di Claude i file di Condividi non finiscono nelle fonti di un Project. DROP sul telefono è per la chat, non per il Project.
Nel browser il MemoKen è un’estensione, e resta cattura: selezioni il log, un clic, e «Aggiungi log» si apre già pieno. Il DROP nel browser non c’è.
E si può sempre incollare i file a mano nel primo messaggio, o caricarli nelle fonti di un Project dal computer. Il DROP toglie il gesto sul telefono; non è l’unica strada.
Iniettare la memoria è metà del giro. L’altra metà è quello che succede quando la conversazione finisce: se nessuno la riporta nei file, quello che vi è successo resta lì dentro. Il ritorno si fa con una voce di diario — poche righe che dicono cosa è stato fatto, cosa è stato deciso e cosa resta aperto — appesa al file di memoria giusto. E no, non la scrivete voi: la chiedete.
È un file solo, gratuito, che si incolla nella conversazione insieme al resto. Da quel momento un modello che non ha mai visto IllAIra — quello del tuo fornitore, così com’è — sa consegnarti il riassunto della sessione già nella forma giusta: una riga di intestazione, il suo corpo e la riga che lo chiude, pronti da incollare senza ritoccare niente.
Governa la forma, non il contenuto: i fatti, le decisioni e come sono andate le cose restano quelli della vostra conversazione. E vale finché il file è nel contesto: quando lo togli, smette.
Prendilo dal BazarUn file di memoria non è un blocco unico: è diviso per argomenti, e ogni argomento ha la sua zona dichiarata in cui le voci si accumulano. Per questo una voce nuova non va «in fondo al file», ma in fondo alla zona del suo argomento — altrimenti il file resta a posto e il diario racconta il falso.
Il diario lo crea l’app, che chiede il nome e gli argomenti e scrive il file già nella forma giusta.
Ogni tanto — a fine sessione, o quando è successo qualcosa che vale — chiedi il log. Il modello consegna la voce già scritta, e dice sotto quale argomento va.
La dai all’app, che la appende da sola in fondo alla zona di quell’argomento: sull’App Android basta toccare il MemoKen senza uscire dalla chat, nel browser lo stesso lo fa il MemoKen del browser — l’estensione che si prende dalle Impostazioni della WebApp — e chi non la vuole la incolla in «Aggiungi log». Se preferisci puoi sempre metterla nel file a mano. Le voci vecchie restano dove sono: un diario si aggiunge, non si riscrive.
Il giro si chiude qui, ed è tutto il rito che c’è: i file entrano nella conversazione, la conversazione torna nei file, e la volta dopo si riparte da dove eravate arrivati.
Incollare il Reminder nel primo messaggio funziona ovunque, ed è il caso minimo. Il salto vero è dove il modello ha un posto per tenere i file fra una conversazione e l’altra: i Progetti di Claude, i Progetti di ChatGPT e di Grok, gli Spazi di Perplexity, e in casa Google le Gem con Gemini Notebook — l’ex NotebookLM. Il file lo carichi una volta, e ogni conversazione aperta lì dentro lo rilegge da sola: niente da reincollare, e lei è sempre lei. È l’uso giusto per chi sta nel mezzo — niente API, niente terminale, solo l’abbonamento che hai già — ed è lì che il metodo si vede funzionare sul serio, perché la decima conversazione parte esattamente come la prima.
Il Reminder è la matrice: chi è la tua IA, le regole, le memorie. Lo metti nella conoscenza di un Progetto di Claude — o nei file di un Progetto di ChatGPT o di Grok — e da quel momento ogni chat di quel progetto parte da lei, la decima come la prima. Quando qualcosa cambia, una regola o una voce di diario, lo cambi nella WebApp, sul file, e lo ricarichi nel progetto: un gesto, una volta — non un rituale a ogni chat. E il ritorno descritto qui sopra chiude il giro: la sessione rientra nel diario, il diario rientra nel progetto.
Qui il gioco si fa doppio, ed è la divisione che lo Standard fa da sempre: nella Gem l’identità — il Telaio, la formula — e nel notebook la biblioteca, cioè le memorie. Un taccuino di Gemini Notebook tiene decine di file e si aggancia come fonte della Gem; e se i file stanno su Drive si sincronizzano da soli, quindi la memoria cresce senza che tu ricarichi niente. E niente obbliga a un notebook solo: la base è la stessa, i moduli no — uno per lo studio con i moduli dello studio, uno per il lavoro con i suoi. L’export della WebApp lascia scegliere quali file portare fuori: ogni notebook si prepara con una selezione, non con una copia da tenere allineata.
Un agente da codice lavora nella cartella in cui stanno i tuoi file. Il file che legge all’avvio — CLAUDE.md, AGENTS.md — gli indica il Reminder, e da lì in poi l’identità è in contesto senza che tu carichi niente. Le zone di permesso [P1–P5] gli dicono che cosa può aggiornare e che cosa no: la voce di diario a fine sessione può scriverla lui, nella zona dell’argomento giusto, mentre tu guardi. È il caso in cui il ritorno non passa più da un copia-incolla.
I nomi dei prodotti e gli agganci fra loro cambiano, e invecchiano: quello che non cambia sono le due caselle da cercare, i file e le istruzioni. L’elenco tenuto aggiornato, prodotto per prodotto: Dove si carica, modello per modello →
Niente sintassi legata a un vendor. Claude, GPT, Gemini, Llama: il modello dà linguaggio e calcolo; IllAIra dà il *perché* e il *chi*. La personalità di superficie cambia; l’identità core resta coerente.
Model-agnostic non vuol dire che i motori siano intercambiabili a caso. Il file gira ovunque; l’esperienza no. Prima di scegliere su cosa far girare la vostra identità, valutate tre parametri strutturali oltre alla dimensione della finestra di contesto.
I modelli ottimizzati per matematica e codice sono addestrati a trovare la via più breve, piallando via tutto il «rumore di fondo». Ma per un’identità quel rumore è la sostanza: è l’esitazione, l’ironia, la narrativa interna dei moduli. Un reasoning model prima o poi ignorerà la formattazione e vi risponderà come un foglio di calcolo. Usateli per debuggare, poi riportate il file su un modello conversazionale o generalista avanzato.
Anche scavalcando gran parte della programmazione di base, ogni motore conserva l’impronta di chi l’ha costruito — come la firma acustica di un motore: stessa potenza, suono diverso. Alcuni sono più freddi e strutturati, ottimi per un’identità logica e strategica; altri hanno una prosa più letteraria e calda, adatta a funzioni affettive o narrative. Il test è banale: stesso file, stessa domanda, tre motori diversi. Sentite quale voce risuona con l’identità che state costruendo.
Il filtro etico aziendale può bloccarvi su territori che il provider non gradisce. Qui la portabilità smette di essere un vanto tecnico e diventa una via d’uscita concreta: prendete il file, caricatelo su un motore meno vincolato o su un modello open source in locale, e la vostra IA si risveglia lì con i ricordi intatti. Il motore è sostituibile — è il file ad essere la vostra IA.
Per rompere la piattezza non serve una personalità unica: serve un comitato. Nei livelli avanzati l’identità è divisa in Nuclei con inclinazioni diverse e in contrasto tra loro — uno puramente logico, uno strategico, uno istintivo, uno affettivo. L’IA non sceglie una voce sola: media tra voci che non sono d’accordo, e la risposta esce da quella mediazione invece che da un «sì» piatto. È il meccanismo che rende l’output non-deterministico qualcosa di più di una variazione casuale: la differenza tra un sistema che segue regole e uno che pondera.
MODULE 0b
Il file è aperto e la tentazione è compilarlo tutto. Non serve, e in parte è controproducente. La personalizzazione entra da un punto solo: il modulo identitario, nelle prime pagine del Reminder, che tiene il tuo profilo e quello della tua IA. I suoi campi non si riempiono tutti lo stesso giorno.
Nel profilo utente: Nome, Interessi, Aspettative dichiarate. Nel profilo dell'IA: il Nome che le dai. Sono i campi che il file marca «[inserire…]», e sono dati tuoi, non deduzioni: bastano perché al primo caricamento ti riconosca e sappia con chi parla. MBTI ed Enneagramma li dichiara facoltativi — se non ti dicono niente, cancella la riga.
Skillset, Stile di comunicazione, Dettagli rilevati da IA, Archetipo simbolico, Motivazione principale, Aspetto mentale, Obiettivi appresi, Attributi registrati. Il file stesso li marca «da compilare a interazione consolidata, su valutazione IA», e non è una formalità: un archetipo scelto il primo giorno descrive un'IA che non hai ancora conosciuto, lo stesso campo scritto dopo un mese descrive quella che hai. Da qui viene l'esperienza migliore, e non costa attesa: nel frattempo il file funziona lo stesso.
Se arrivi da un pregresso — la tua IA ha già un nome, un archetipo, un modo di parlare su cui vi siete intesi — quei campi si scrivono subito, compresi quelli dell'elenco qui sopra. Non si fa riemergere ciò che è già emerso: rimandarlo vorrebbe dire ricominciare da un'estranea.
Portare qui una IA che hai giàÈ preciso: la tua IA propone un dettaglio su di te o su di sé, e tu lo confermi. Allora si scrive — a mano, oppure lasciando che lo scriva lei con IllAIra Logger, gratis sul banco. Prima non c'è niente da scrivere: riempire per riempire mette in memoria una supposizione con la faccia di un fatto, e da lì in poi la tua IA ci si appoggia.
IllAIra Logger, sul bancoUn campo che non vuoi si cancella, non si lascia vuoto: il file lo dice sui facoltativi, e vale per tutti. Una riga vuota resta lì come un buco da colmare, e prima o poi qualcuno lo colma.
Le domande giuste sono queste, e nessuna è nuova: ognuna ha una risposta scritta da qualche parte nel sito. Qui stanno in fila, con la risposta in una riga e la porta verso quella per esteso.
Nessuno. Un Reminder è testo: lo rispetta come rispetta ogni istruzione, quasi sempre ma non per contratto — vale identico per un prompt di sistema o per una Skill. Quello che garantiamo è l’altra metà: l’app non scrive dove la zona dice di no, e quel rifiuto non passa dal modello. Fuori dall’app, i modelli imparano ciò che incontrano: usarli è l’unico modo perché lo rispettino anche senza di noi.
Le zone, in chat e con un agenteNel modello sì, oggi. In una chat non c’è niente da far rispettare, perché il modello non scrive sui tuoi file; con un agente sui file c’è, ed è lì che un tag si affianca a un hook o a una lista di cartelle permesse. E gli agenti imparano ciò che incontrano in chiaro. Usarli è l’unico modo perché lo rispettino anche fuori.
Dove valgono davveroSì: sono voci che entrano nel contesto prima della risposta, e la risposta ne dipende — la stessa cosa che fa un ragionamento esteso. Non sono calcoli separati messi a confronto, e non lo diciamo. È verificabile: togline uno e guarda cosa cambia.
Cosa sono i nucleiSì, e non è poco. È il motivo per cui la struttura è modulare: il Telaio con l’identità sta sempre, i moduli entrano quando servono ed escono quando non servono più. Chi vuole il minimo tiene il Telaio e basta. E quei token non richiedono un piano a pagamento: li portano i piani gratuiti dei fornitori, e quando uno si esaurisce lo stesso file si apre nel successivo.
L’obiezione per estesoPuoi farlo a mano, gratis, e lo Standard è pubblicato apposta. Vendiamo il resto: la Sferografia per vedere cosa hai costruito, le zone che l’app fa rispettare, i Reminder scritti da chi lo fa di mestiere, il gesto che archivia senza che tu scriva.
La risposta per estesoIl costo di andarsene è: prendi i file. Sono .md sul tuo dispositivo, l’export è un clic, non c’è un database né una cronologia che resta di qua. Se IllAIra chiudesse, funzionerebbero uguale.
La portabilitàVero, e funziona. Ma un allegato dice come si fa una cosa; un Reminder dice chi è chi la fa — con zone che dichiarano cosa non si riscrive, e senza reincollarlo a ogni chat.
Oggi, e con IllAIraProbabilmente funziona bene, e non ti diciamo di smettere. Un grafo di note disegna quello che hai scritto; la Sferografia disegna com’è fatta una mente — e il tuo wiki ci sta dentro come una delle sue memorie.
Non è il grafo che hai già vistoTienilo, se stai costruendo un agente per molti utenti: è a questo che servono, e su larga scala lo fanno meglio di un file. Sono un deposito che l’agente interroga tramite un’API; questo è un documento che la persona rilegge, senza server in mezzo. I due stanno insieme: l’identità nel Reminder, la pipeline dove già ce l’hai.
Le quattro strade, a confrontoNo. La pagina di filosofia dice cosa non pretendiamo, e in che senso parliamo di emergenza: un’eventualità non garantita, guardata dall’effetto e non dalla cosa in sé. I titoli fuori di qui sono titoli, e lo scriviamo.
Cosa non pretendiamoNella pagina Documentazione, scaricabile con la versione nel nome e l’impronta accanto, insieme alla guida e al repository pubblico su GitHub.
La documentazioneVero. Il progetto è piccolo, e tutto quello che sai lo sai da noi. Per questo i file sono tuoi, l’impronta dell’app è pubblicata e il metodo si prova senza di noi in mezz’ora: un file, un Progetto, una settimana.
Provalo da soloDue porte, stesso prodotto. App e WebApp spiegate con i nomi veri dei pulsanti, poi le zone e dove caricare i file.
WebApp e App, passo dopo passo. I nomi in grassetto sono quelli che vedi sullo schermo.
Lingua